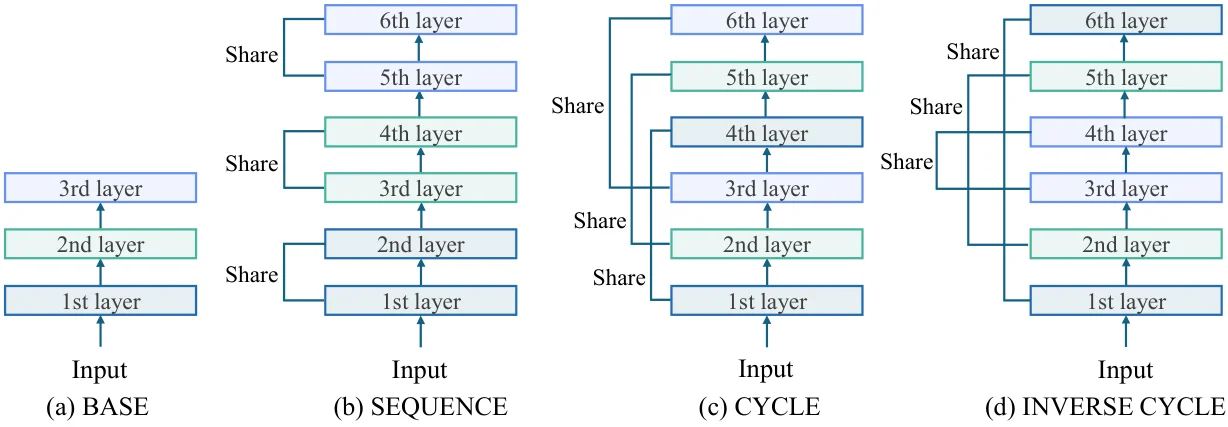
파라미터 추가 없는 LLM 추론 극대화 기법: '가상 로직 깊이'와 레이어 루프의 원리
구글 딥마인드가 매개변수 증가 없이 기존 레이어를 반복 통과시켜 추론 성능을 비약적으로 높이는 '가상 로직 깊이(Virtual Logic Depth)' 개념을 발표했습니다. 소형 로컬 모델의 활용 가치와 확장 법칙의 변화를 정리합니다.
TAU-HOME.COM에서 LocalLLM 태그로 묶인 글입니다.
구글 딥마인드가 매개변수 증가 없이 기존 레이어를 반복 통과시켜 추론 성능을 비약적으로 높이는 '가상 로직 깊이(Virtual Logic Depth)' 개념을 발표했습니다. 소형 로컬 모델의 활용 가치와 확장 법칙의 변화를 정리합니다.
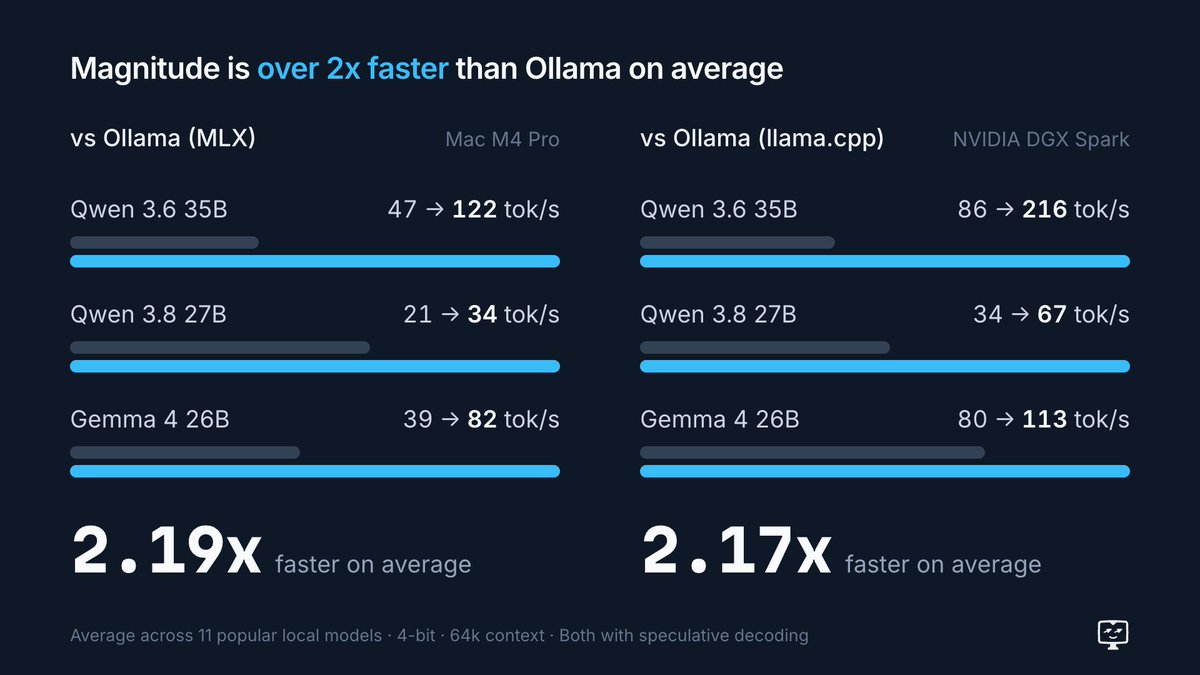
기기 칩셋에 맞춰 연산 커널을 최대 1분간 자동 튜닝해 올라마(Ollama) 대비 디코드 속도를 11개 모델 평균 2.19배(Mac M4 Pro 기준) 가속하는 오픈소스 로컬 LLM 추론 엔진 '매그니튜드(Magnitude)'가 발표되었습니다. 양자화 KV 캐시와 코딩 에이전트 연동을
허깅페이스 트렌딩 2위에 오른 12B 로컬 오픈 모델 'Humanizer'는 이메일, 에세이, 리포트 등 AI가 생성한 초안의 기계적 패턴을 사람이 직접 쓴 듯한 자연스러운 문체로 로컬에서 재작성합니다.
로컬 LLM 플릿 대시보드 sparkDash v2.0 공개. 전면 재설계 UI, 카드에서 바로 모델 실행, Decode·Prefill·품질·Tool Eval 벤치마크와 토큰·전력·이벤트 모니터링 신기능 정리.
Ghost AI가 데이터 외부 유출 없이 24시간 로컬 모델을 구동하는 개인용 AI 하드웨어 'Core'를 공개했습니다. NVIDIA RTX PRO 4000 Blackwell SFF GPU 기반으로 Qwen-3.8-27B 87 tok/s 추론을 지원합니다.
128GB 통합 메모리 단일 DGX Spark에서 Qwen3.8-Flash-Next NVFP4 구동 실측이 공개되었습니다. FP8 KV 캐시로 1M 컨텍스트와 4개 스트림 동시 서빙을 지원합니다.
Aleph Alpha의 78B MoE Kolibri-1을 47.5GB Q4_K_M GGUF로 양자화하여 패치된 llama.cpp와 128GB RAM 환경에서 CPU 단독으로 초당 13~15 토큰을 기록한 로컬 구동 방식을 정리합니다.
RTX 5060 Ti(16GB), RTX 5090(32GB), GB10(128GB/256GB) 환경에서 Qwen3.8-27B, Qwen3.8-Flash-Next, GLM-5.3-Flash 모델의 런타임별 추론 속도(tok/s)와 첫 토큰 지연시간(TTFT)을 실측 비교한 벤치마크 결과입
오픈소스 로컬 LLM 추론 엔진 Strata가 v0.1.34 업데이트를 통해 Windows 운영체제에서의 AMD GPU 하드웨어 가속과 AI 코딩 에이전트 연동을 위한 내장 Model Context Protocol(MCP) 서버를 공식 지원합니다.
코딩 에이전트 하네스 18.3.0에서 기본 프롬프트 토큰을 약 30k에서 10k로 대폭 축소해 로컬 모델 프리필을 개선하고, read/write/bash 도구 통폐합, 스킬 압축, Anthropic 온디맨드 컴팩션 등 실전 에이전트 엔지니어링 최적화 팁을 정리합니다.
하드웨어 사양을 분석해 최적의 로컬 모델과 예상 토큰 속도를 추천하고, 투기적 디코딩 튜닝과 Pi·OpenCode·Claude Code 등 주요 하네스 원클릭 연동을 지원하는 오픈소스 도구 Magnitude를 분석합니다.
정적 벤치마크 98.2% 유지율과 달리, 로컬 에이전트 코딩에서 극단적 저비트 Qwen3.8-27B는 무한 계획 루프와 파일 삭제를 유발합니다. 12GB VRAM 환경에서 실전 작업을 완수하는 GSQ-RCO IQ2_XS(2.50 bpw)와 Q4_0 KV 캐시 최적화 팁입니다.
PrismML의 Qwen3.8-27B 기반 3진법 압축 모델 Bonsai 2(5.95GB)의 거절 회로를 파일 크기 증가 없이 가중치 레벨에서 제거한 dealignai 팀의 CRACK 빌드가 공개되었습니다.
API 비용과 데이터 클라우드 전송 걱정 없이 LLM, 음성, 비전, 에이전트를 로컬에서 구동하는 LocalAI. OpenAI·Anthropic 규격 호환 엔드포인트, llama.cpp·vLLM·MLX 스왑형 백엔드, WebUI 및 CPU 지원 기능을 정리합니다.
거부 반응이 제거된 무검열 Nex-N2.5-mini GGUF 빌드(IQ4_XS)가 공개되어 18GB VRAM 환경에서 로컬 구동이 가능해졌습니다. 35B MoE(3.5B 활성), 262K 컨텍스트, 비전 및 llama.cpp 에이전틱 코딩 지원 사양과 활용 팁을 정리합니다.
MiaAI-Lab이 단일 16GB VRAM 엔비디아 GPU에서 Qwen3.8-27B 모델을 turboderp의 EXL3 양자화로 원클릭 설치하고 로컬 OpenAI 호환 API로 서빙하는 오픈소스 툴킷을 공개했습니다.
Impact-Site-Verification: 9b3ebd10-6c45-44cf-a014-5b8c19b7b285