오픈소스 LLM 추론 엔진 '매그니튜드(Magnitude)' 공개… 기기별 커널 자동 튜닝으로 올라마 대비 디코드 평균 2.2배 가속
기기 칩셋에 맞춰 연산 커널을 최대 1분간 자동 튜닝해 올라마(Ollama) 대비 디코드 속도를 11개 모델 평균 2.19배(Mac M4 Pro 기준) 가속하는 오픈소스 로컬 LLM 추론 엔진 '매그니튜드(Magnitude)'가 발표되었습니다. 양자화 KV 캐시와 코딩 에이전트 연동을
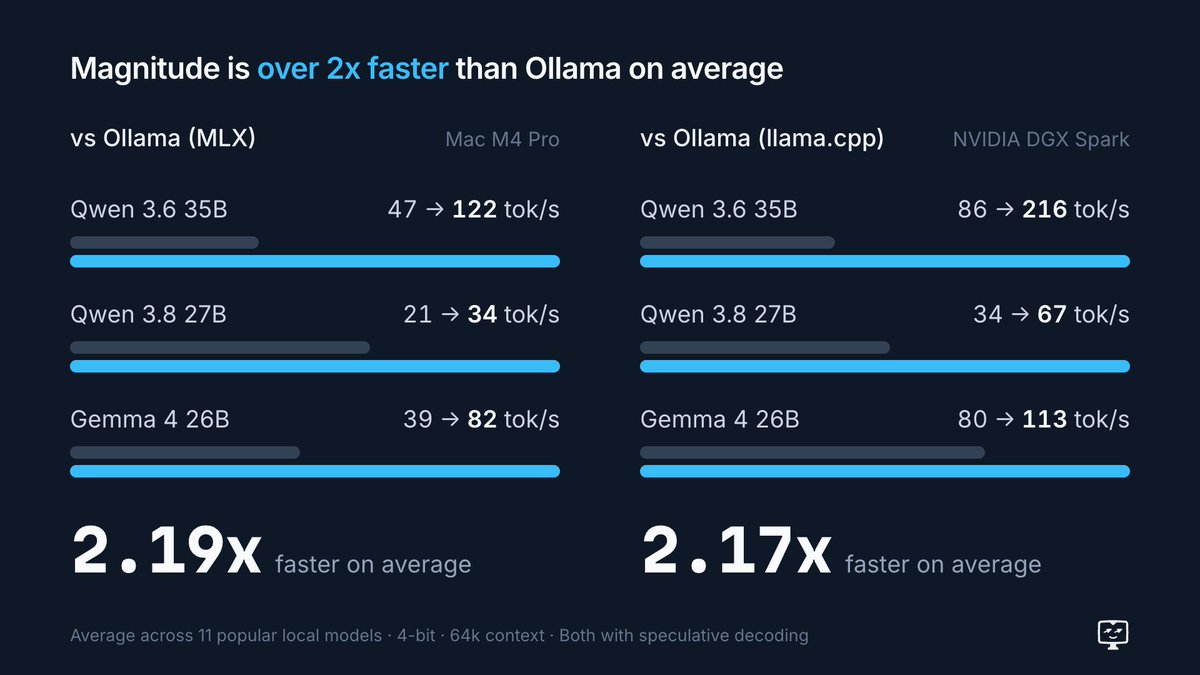
2026년 10월 15일, 개발자 톰 그린월드(Tom Greenwald, @tomgreenwald)가 사용자의 하드웨어 환경에 맞춰 연산 커널을 자동으로 튜닝하는 무료 오픈소스 로컬 대규모 언어 모델(LLM) 추론 엔진 '매그니튜드(Magnitude)'를 공식 발표했습니다. 별도의 신규 하드웨어 추가 없이 소프트웨어 차원에서 칩셋별 최적 실행 방식을 탐색해 기존 올라마(Ollama) 대비 11개 모델 평균 2.19배(Mac M4 Pro 기준) 빠른 디코드 속도를 구현한 점이 핵심입니다.
이미지 출처: Tom Greenwald (@tomgreenwald via X)
이번에 공개된 매그니튜드는 애플 실리콘(Apple Silicon)을 비롯해 엔비디아(NVIDIA), AMD GPU는 물론 일반 CPU 환경까지 폭넓게 지원하며, Mac·Windows·Linux 전용 데스크톱 애플리케이션으로 배포됩니다. 사전 컴파일된 단일 범용 커널에 의존하던 기존 로컬 런타임의 구조적 한계를 하드웨어 프로파일링 기반 자동 튜닝으로 돌파하고, 코딩 에이전트에 최적화된 메모리 아키텍처를 도입한 것이 특징입니다.
기기별 커널 자동 튜닝과 투기적 디코딩: 올라마 대비 디코드 2배 이상 가속
기존의 대표적인 로컬 모델 실행기인 올라마(Ollama), LM Studio, llama.cpp 등은 시중에 유통되는 수많은 칩셋과 모델 조합을 개발자가 일일이 수작업으로 최적화하기 어렵다는 이유로, 모든 환경에 일률적으로 적용되는 단일 범용 커널(one-size-fits-all kernels)을 탑재해 왔습니다.
반면 매그니튜드는 모델을 로컬에 다운로드하는 시점에 사용자의 실제 칩셋 환경에서 최대 1분가량의 초기 연산 탐색(tuning) 과정을 거칩니다.
- 연산 파티셔닝 자동 탐색: GPU 스레드 협력 수, 각 스레드가 처리하는 연산 청크(chunk) 크기, 데이터 사전 로드(prefetch) 거리 등 다양한 연산 분할 방식을 실제 칩에서 직접 실행해 봅니다.
- 출력 무결성 보장: 모델의 본래 추론 출력값(수학적 결과)을 일절 변경하지 않으면서 가장 빠르게 실행되는 최적의 커널 파라미터 조합만을 선택해 고정합니다.
- 투기적 디코딩(Speculative Decoding) 자동 페어링: 각 모델마다 최적의 경량 드래프터(drafter) 모델을 자동으로 매칭하여 토큰 디코드 처리량을 극대화합니다.
발표된 벤치마크에 따르면, 11개 주요 로컬 모델을 대상으로 측정한 평균 처리 속도에서 매그니튜드는 기존 엔진 대비 뚜렷한 가속 성능을 기록했습니다.
- Mac M4 Pro(Ollama MLX 백엔드 대비): 프롬프트 프리필(prefill) 속도 1.32배, 토큰 디코드(decode) 속도 2.19배 향상
- DGX Spark(Ollama llama.cpp 백엔드 대비): 프리필 속도 1.34배, 디코드 속도 2.17배 향상
개발팀은 vLLM이나 SGLang이 데이터센터 환경의 대규모 배치(batched throughput) 처리에 초점을 맞춘 것과 달리, 매그니튜드는 단일 머신에서의 싱글 스트림 디코드 속도를 극대화하는 데 특화되어 개인 로컬 환경에서 더 유리한 성능 상한선을 제공한다고 설명했습니다.
에이전트 맞춤 아키텍처: 양자화 KV 캐시·프리픽스 공유 및 데스크톱 앱 연동
매그니튜드는 단순한 챗봇 UI를 넘어 최근 개발 현장의 핵심 도구로 자리 잡은 AI 코딩 에이전트 워크플로우를 겨냥해 설계되었습니다.
OpenAI 호환 로컬 API 서버 엔드포인트를 기본 내장하여, 파이(Pi), 오픈코드(OpenCode), 헤르메스(Hermes), 코덱스(Codex) 등 기존에 널리 쓰이는 주요 코딩 에이전트 및 개발 도구와 클릭 한 번으로 손쉽게 연동할 수 있습니다. 기존에 올라마를 백엔드로 사용하던 개발 환경에서도 코드나 설정의 대대적인 변경 없이 로컬 API 주소 전환만으로 교체 가능합니다.
특히 다중 에이전트 운용 시 시스템 자원이 고갈되는 문제를 해결하기 위해 에이전트 특화 메모리 관리 기술이 대거 적용되었습니다.
- 양자화 KV 캐시(Quantized KV Cache): Key-Value 캐시를 양자화하여 각 에이전트가 점유하는 메모리 사용량을 기존 대비 약 50% 절감합니다.
- 동적 메모리 확장·축소: 세션 진행 상황과 컨텍스트 길이에 따라 메모리 점유량을 동적으로 늘리고 줄임으로써 에이전트 실행 중에도 PC의 일상 작업 환경을 쾌적하게 유지합니다.
- 프리픽스 캐시(Prefix Cache) 공유: 동일한 시스템 프롬프트나 프로젝트 컨텍스트를 참조하는 복수의 에이전트가 캐시를 공유하여, 여러 에이전트를 동시에 구동해도 속도 저하 없이 병렬 실행할 수 있습니다.
하드웨어 호환성, 초기 탐색 소요 시간과 향후 로드맵
완전 무료 오픈소스(FOSS)로 공개된 매그니튜드는 실사용 환경에서 확인된 유의점과 단계적 지원 계획도 함께 밝혔습니다.
- 초기 프로파일링 시간 소요: 기기 칩셋에 맞춰 최적 커널을 탐색하기 위해 모델 최초 다운로드 시 최대 1분간의 자동 튜닝 시간이 필요합니다.
- 환경별 체감 편차: 공개된 벤치마크는 11개 모델의 평균치이며, 실제 사용자가 체감하는 가속 배율은 개별 GPU/CPU의 세부 사양과 실행하는 모델 아키텍처에 따라 차이가 발생할 수 있습니다.
- 레거시 GPU 및 메모리 한계 대응: 구형 엔비디아 파스칼(Pascal, sm_60 등 Tesla P100 계열) 환경은 현재 벌칸(Vulkan) 백엔드를 통해 동작하며, 커뮤니티 요청에 따라 구버전 CUDA 호환 빌드 지원 여부를 검토 중입니다. 또한 일부 고용량 모델(Gemma 26B-A4B 등)의 경우 VRAM 한계에 따른 구동 제약이 보고되어 깃허브 이슈를 통한 개별 하드웨어 최적화 조사가 진행되고 있습니다.
개발팀은 차기 릴리즈를 통해 하드웨어 자원을 더욱 극한으로 활용할 수 있는 추가 기능들을 순차적으로 공개할 예정입니다.
- RAM 및 디스크 기반 익스퍼트 스트리밍(Expert Streaming): GPU VRAM 용량을 초과하는 대형 전문가 혼합(MoE) 모델을 메인 메모리와 저장 장치에서 효율적으로 분할 호출하는 기능
- 이종 하드웨어 분할 연산: 시스템 내 모든 GPU와 CPU 자원에 단일 모델 연산을 지능적으로 분산해 유휴 자원을 없애는 멀티 디바이스 스케줄링
- 어텐션 프루닝(Attention Pruning): 영향력이 낮은 불필요한 수학 연산을 생략하여 프롬프트 프리필 속도를 대폭 단축하는 경량화 기술
매그니튜드는 공식 웹사이트와 깃허브(GitHub) 저장소를 통해 설치 파일을 내려받을 수 있으며, 자세한 API 명세는 공식 개발자 문서를 통해 제공됩니다.
출처
- Tom Greenwald 공식 X 발표 (@tomgreenwald): Magnitude 오픈소스 LLM 추론 엔진 출시 공지
- Magnitude 공식 다운로드: magnitude.dev
- Magnitude 공식 GitHub 저장소: github.com/magnitudedev/magnitude
- Magnitude API 개요 문서: docs.magnitude.dev/api/overview