독일 Aleph Alpha 78B MoE 'Kolibri-1' 커뮤니티 GGUF 공개: CPU로 13~15 TPS 달성
Aleph Alpha의 78B MoE Kolibri-1을 47.5GB Q4_K_M GGUF로 양자화하여 패치된 llama.cpp와 128GB RAM 환경에서 CPU 단독으로 초당 13~15 토큰을 기록한 로컬 구동 방식을 정리합니다.
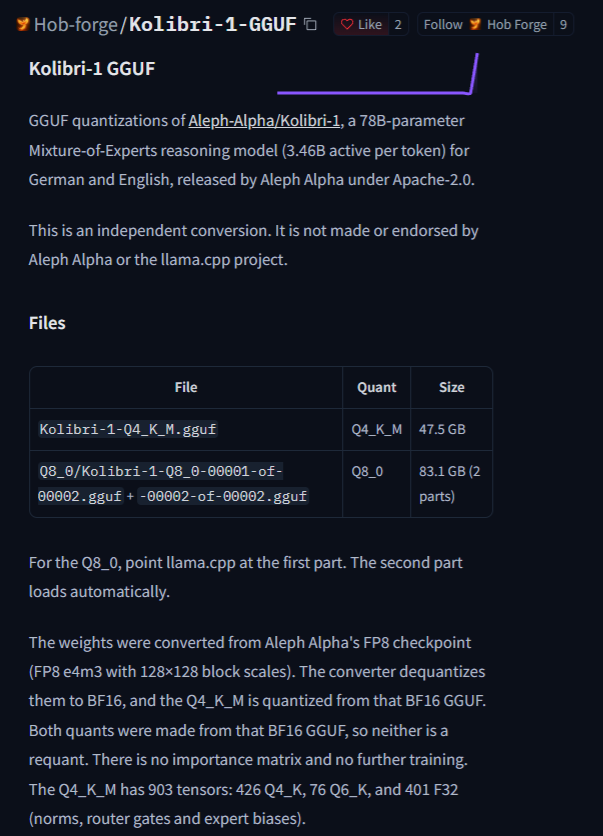
독일 AI 연구 기업 알레프 알파(Aleph Alpha)가 아파치 2.0 라이선스로 공개한 78B Mixture-of-Experts(MoE) 모델 '콜리브리(Kolibri-1)'의 커뮤니티 GGUF 양자화 버전이 허깅페이스를 통해 정식 배포되었습니다. 공식 가중치 배포 직후 오픈소스 커뮤니티 빌더인 Hob-forge가 공개한 이번 변환본은 고가의 데이터센터 GPU 없이도 일반 데스크톱 CPU 환경에서 실용적인 추론 속도를 확보할 수 있음을 입증하며 로컬 LLM 사용자들의 큰 주목을 받고 있습니다.
이미지 출처: @TeksEdge / Aleph Alpha
Kolibri-1은 총 파라미터 78B(약 781억 개) 규모의 추론 특화 언어 모델이지만, MoE 희소 활성화 설계를 통해 토큰당 약 3.46B(약 34억 5천만 개)의 파라미터만을 동적으로 활성화합니다. 384개의 라우팅 전문가 중 6개와 1개의 공유 전문가를 결합하는 이 아키텍처 덕분에, 모델 가중치를 적재할 시스템 메모리만 충분하다면 연산 부하를 크게 낮추어 로컬 CPU에서도 부드러운 토큰 생성이 가능해졌습니다.
Kolibri-1 아키텍처와 커뮤니티 GGUF 양자화 현황
알레프 알파가 2026년 10월 3일 공식 공개한 Kolibri-1은 유럽 공공 행정 및 산업 엔터프라이즈 환경을 겨냥해 독일어와 영어 처리에 최적화된 이중언어 오픈웨이트 모델입니다. 최대 100만(1,048,576) 토큰에 달하는 긴 컨텍스트 윈도우(서빙 권장 262,144 토큰 이하)와 구조화된 추론 모드, 산술 연산, 도구 호출(Tool calling) 기능을 갖추고 있습니다.
공식 릴리즈 가중치는 128×128 블록 스케일 기반의 FP8(float8_e4m3fn) 포맷으로 약 78GB에 달해, 단일 소비자용 GPU로는 적재 자체가 불가능했습니다. 이에 커뮤니티의 Hob-forge는 FP8 원본 체크포인트를 BF16으로 디퀀타이즈한 뒤 직접 GGUF 양자화를 수행했습니다. 이미 양자화된 가중치를 재압축한 손실형 재양자화(requant)가 아니라는 점이 특징입니다.
- Q4_K_M GGUF (
Kolibri-1-Q4_K_M.gguf): 단일 파일 크기 약 47.5GB로, 데스크톱 메모리 환경에서 구동하기에 가장 적합한 기본 양자화 버전입니다. - Q8_0 GGUF (
Kolibri-1-Q8_0): 전체 크기 약 83.1GB로, 파일 시스템 제약을 고려해 2개 파트로 분할 배포됩니다. llama.cpp에서 첫 번째 파트를 지정하면 두 번째 파트가 자동으로 로드됩니다.
CPU 단독 13~15 TPS 벤치마크와 128GB RAM 환경 요건
커뮤니티 테스터 David Hendrickson(@TeksEdge)이 공유한 Hob-forge의 실측 데이터에 따르면, Q4_K_M 양자화 모델은 GPU 가속 없이 AMD Ryzen 7 7800X3D CPU와 128GB 시스템 메모리 단독 구성에서 초당 약 13~15 토큰(TPS)의 디코딩 속도를 기록했습니다.
이 테스트에서는 독일어 및 영어 질의응답뿐만 아니라 산술 연산 문제(reasoning 모드)와 도구 호출(Tool call) 시나리오까지 포함되어 정상 작동이 확인되었습니다. 활성 파라미터가 3.46B에 불과하므로 토큰 생성 단계에서의 메모리 대역폭 병목이 대폭 완화된 결과입니다.
다만 시스템 메모리 용량 확보는 필수적입니다. Q4_K_M 단일 가중치 파일 크기만 47.5GB에 달하기 때문에, 64GB RAM 탑재 시스템에서는 운영체제 런타임과 KV 캐시 메모리 오버헤드로 인해 스왑 메모리 병목이나 메모리 부족(OOM) 오류가 발생할 위험이 큽니다. 따라서 CPU 환경에서 안정적인 추론을 수행하려면 128GB 이상의 시스템 메모리가 실질적으로 요구됩니다.
패치된 llama.cpp 필요성과 로컬 배포 시 주의점
현재 시점에서 Kolibri-1 GGUF를 구동하려는 로컬 개발자가 반드시 확인해야 할 기술적 제약 사항들도 존재합니다.
- 패치 적용 빌드 필수: Kolibri-1은 기존 라마 계열과 세부 MoE 라우팅 구조가 다르기 때문에, 공식 llama.cpp 메인 브랜치에 정식 병합되기 전까지는 Kolibri 전용 패치가 포함된 커스텀 llama.cpp 소스를 직접 빌드해 사용해야 합니다.
- 하드웨어 가속 검증 진행 중: 현재 배포된 릴리즈와 벤치마크는 CPU 추론을 중심으로 검증되었습니다. 제작자(Hob-forge)는 CUDA, Vulkan, Metal 하드웨어 가속 백엔드에 대해서는 아직 완전한 테스트가 이루어지지 않은 상태임을 명시하고 있습니다.
- 패키징 런타임 지원 대기: Ollama나 LM Studio 등 패키징된 로컬 LLM 런타임은 공식 llama.cpp 업스트림 반영 이후에나 정식 지원될 것으로 예상됩니다.
유럽 데이터 주권과 온프레미스 인프라를 목표로 개발된 78B 오픈 모델이 커뮤니티의 발 빠른 양자화 덕분에 데스크톱 CPU 환경에서도 실용 속도로 구동되기 시작했다는 점에서, 고성능 MoE 모델의 로컬 접근성을 크게 넓힌 중요한 진전으로 평가받고 있습니다.
출처
- Hugging Face: Hob-forge/Kolibri-1-GGUF 저장소
- David Hendrickson 공식 X (@TeksEdge): Kolibri-1 Q4_K_M GGUF CPU 벤치마크 리포트