로컬 AI 런타임 벤치마크: 16GB~256GB 체급별 exllamav3·llama.cpp·vLLM·TensorFold 실측 비교
RTX 5060 Ti(16GB), RTX 5090(32GB), GB10(128GB/256GB) 환경에서 Qwen3.8-27B, Qwen3.8-Flash-Next, GLM-5.3-Flash 모델의 런타임별 추론 속도(tok/s)와 첫 토큰 지연시간(TTFT)을 실측 비교한 벤치마크 결과입
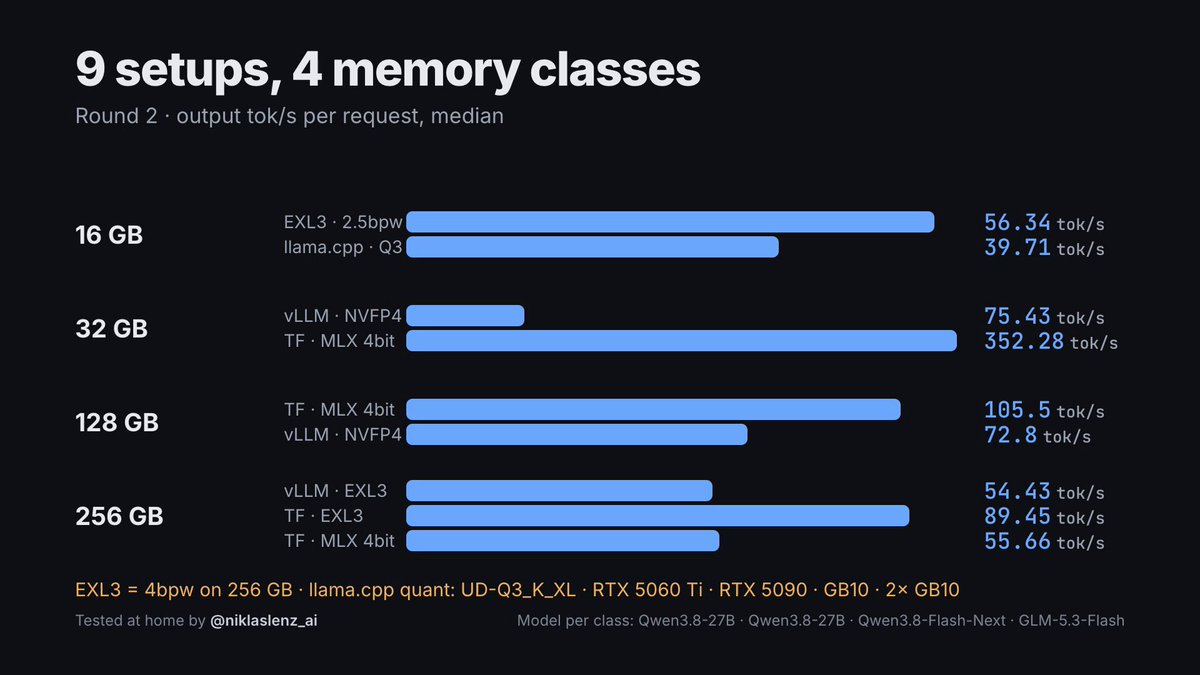
AI 엔지니어이자 연구자인 Niklas Lenz(@niklaslenz_ai)가 16GB부터 256GB까지 다양한 하드웨어 체급에서 로컬 AI 모델을 구동하고, 주요 런타임 엔진(exllamav3, llama.cpp, vLLM, TensorFold)별 추론 속도(tok/s)와 첫 토큰 지연시간(TTFT)을 실측한 '로컬 AI 테스트 파트 2(Local AI Test Part 2)' 벤치마크 결과를 공개했습니다.
이미지 출처: @niklaslenz_ai on X
이번 벤치마크는 4개 메모리 체급(16GB, 32GB, 128GB, 256GB)에서 총 9개 하드웨어 및 런타임 설정(Setup)을 구성해 동일한 10개 앱 개발 프롬프트 태스크를 실행하며 성능을 측정했습니다. 특히 오픈소스 AI 커뮤니티의 @MiaAI_lab과 @ashxhart가 개발한 최신 런타임 레시피와 키트가 새롭게 포함되었으며, 가장 복잡한 3개 태스크에는 최대 150분의 실행 시간이 주어졌습니다.
벤치마크 환경 및 측정 기준
테스트는 엔트리급 단일 GPU부터 대규모 통합 메모리 가속기까지 4단계 하드웨어 계층으로 나누어 진행되었습니다.
하드웨어 및 모델 구성
- 16 GB (RTX 5060 Ti): Qwen3.8-27B — Mia의 exllamav3 키트 vs Niklas의 llama.cpp
- 32 GB (RTX 5090): Qwen3.8-27B — Mia의 vLLM 레시피 vs Ash의 TensorFold
- 128 GB (단일 GB10): Qwen3.8-Flash-Next — Mia의 TensorFold 레시피 vs Mia의 vLLM 키트
- 256 GB (2× GB10): GLM-5.3-Flash — Mia의 vLLM 키트 vs Mia의 TensorFold 키트 vs Ash의 TensorFold 레시피
성능 측정 지표
- 추론 속도 (tok/s): 요청당 초당 출력 토큰 수의 중앙값(Median output tokens per second per request).
- 첫 토큰 지연시간 (TTFT): 전체 요청에 걸친 p50(중앙값) 첫 토큰 생성 지연시간(Time to First Token).
- Warm vs Cold 상태:
Cold는 프리픽스 캐시가 꺼져 있거나 태스크의 첫 번째 진입 요청인 상태를 뜻하며,Warm은 프리픽스 캐시 히트(Prefix-cache hit)가 적용된 후속 요청 상태를 의미합니다.
1. 16GB 체급 (RTX 5060 Ti) — Qwen3.8-27B 실측
16GB VRAM 환경에서는 27B 규모의 Qwen3.8-27B 모델을 경량 양자화하여 구동 성능을 비교했습니다.
- Mia's kit (exllamav3 1.4.4, EXL3 2.5 bpw)
- 출력 속도: 56.34 tok/s (중앙값)
- TTFT: 3.98 s (p50)
- Niklas setup (llama.cpp b11151, UD-Q3_K_XL 약 3.8 bpw)
- 출력 속도: 39.71 tok/s (중앙값)
- TTFT: 2.51 s (p50)
exllamav3(2.5 bpw)는 토큰 생성 처리량에서 56.34 tok/s를 기록하며 llama.cpp 대비 약 42% 높은 생성 속도를 나타냈습니다. 반면 llama.cpp(UD-Q3_K_XL)는 초기 프롬프트 처리 및 첫 토큰 응답 시간(TTFT 2.51 s)에서 더 민첩한 성능을 보였습니다.
2. 32GB 체급 (RTX 5090) — Qwen3.8-27B 실측
32GB 플래그십 단일 GPU 환경에서는 vLLM과 TensorFold의 4비트 서빙 성능을 비교했습니다.
- Mia's recipe (vLLM 0.27.1, NVFP4)
- 출력 속도: 75.43 tok/s (중앙값)
- TTFT: 20.39 s (프리픽스 캐시 OFF, 모든 요청 Cold 상태)
- @ashxhart's recipe (TensorFold 0.6.0, MLX 4bit)
- 출력 속도: 352.28 tok/s (중앙값)
- TTFT: Cold 30.01 s / Warm 0.84 s
TensorFold 0.6.0 기반의 MLX 4bit 구성은 352.28 tok/s라는 압도적인 디코딩 속도를 달성했습니다. 프리픽스 캐시가 비활성화된 초기 Cold 상태에서는 두 런타임 모두 20~30초대의 긴 TTFT를 기록했으나, TensorFold는 캐시 히트(Warm) 시 첫 토큰 응답 시간을 0.84초까지 대폭 단축시켰습니다.
3. 128GB 체급 (단일 GB10) — Qwen3.8-Flash-Next 실측
128GB 대용량 단일 가속기 박스에서는 Qwen3.8-Flash-Next 모델을 대상으로 Mia의 두 가지 최적화 레시피를 평가했습니다.
- TensorFold 0.3.6.3 (MLX 4bit)
- 출력 속도: 105.5 tok/s (중앙값)
- TTFT: 첫 요청(Cold) 4.99 s / 후속 요청(Warm) 0.82 s
- vLLM kit (NVFP4)
- 출력 속도: 72.8 tok/s (중앙값)
- TTFT: 첫 요청(Cold) 2.12 s / 후속 요청(Warm) 1.21 s
TensorFold가 지속적인 토큰 생성 속도(105.5 tok/s vs 72.8 tok/s)에서 vLLM 대비 약 45% 우위를 점했습니다. 첫 요청 진입 시의 초기 지연시간은 vLLM(2.12 s)이 더 빨랐으나, 후속 요청에서는 TensorFold가 0.82초로 캐시 재사용 이점을 극대화했습니다.
4. 256GB 체급 (2× GB10) — GLM-5.3-Flash 실측
256GB 듀얼 가속기 클러스터 환경에서는 대규모 플래시 모델인 GLM-5.3-Flash를 3가지 런타임 레시피로 검증했습니다.
- Mia's vLLM kit (vLLM, EXL3 4bpw)
- 출력 속도: 54.43 tok/s (중앙값)
- TTFT: 2.62 s (Warm)
- Mia's TensorFold kit (TensorFold 0.6.0, EXL3 4bpw)
- 출력 속도: 89.45 tok/s (중앙값)
- TTFT: 1.13 s (Warm)
- @ashxhart's recipe (TensorFold 0.6.0, MLX 4bit)
- 출력 속도: 55.66 tok/s (중앙값)
- TTFT: 1.19 s (Warm)
동일한 EXL3 4bpw 포맷 기준, TensorFold 0.6.0(89.45 tok/s, TTFT 1.13 s)이 vLLM(54.43 tok/s, TTFT 2.62 s) 대비 출력 속도와 응답 지연시간 모두에서 약 64% 높은 처리 효율을 보였습니다. 한편 TensorFold 내부 비교에서는 MLX 4bit(55.66 tok/s)보다 EXL3 4bpw(89.45 tok/s) 레시피가 더 높은 처리량을 기록했습니다.
체급별 실측 벤치마크 종합 요약표
| 메모리 체급 | 하드웨어 구성 | 모델 | 런타임 및 양자화 | 출력 속도 (tok/s) | TTFT 지연시간 | 설정 출처 |
|---|---|---|---|---|---|---|
| 16 GB | RTX 5060 Ti | Qwen3.8-27B | exllamav3 1.4.4 (EXL3 2.5 bpw) | 56.34 | 3.98 s | Mia's kit |
| 16 GB | RTX 5060 Ti | Qwen3.8-27B | llama.cpp b11151 (UD-Q3_K_XL ~3.8 bpw) | 39.71 | 2.51 s | Niklas setup |
| 32 GB | RTX 5090 | Qwen3.8-27B | vLLM 0.27.1 (NVFP4) | 75.43 | 20.39 s (Cold) | Mia's recipe |
| 32 GB | RTX 5090 | Qwen3.8-27B | TensorFold 0.6.0 (MLX 4bit) | 352.28 | Cold 30.01 s / Warm 0.84 s | @ashxhart |
| 128 GB | 1× GB10 | Qwen3.8-Flash-Next | TensorFold 0.3.6.3 (MLX 4bit) | 105.50 | Cold 4.99 s / Warm 0.82 s | Mia's recipe |
| 128 GB | 1× GB10 | Qwen3.8-Flash-Next | vLLM kit (NVFP4) | 72.80 | Cold 2.12 s / Warm 1.21 s | Mia's kit |
| 256 GB | 2× GB10 | GLM-5.3-Flash | vLLM (EXL3 4bpw) | 54.43 | 2.62 s (Warm) | Mia's kit |
| 256 GB | 2× GB10 | GLM-5.3-Flash | TensorFold 0.6.0 (EXL3 4bpw) | 89.45 | 1.13 s (Warm) | Mia's kit |
| 256 GB | 2× GB10 | GLM-5.3-Flash | TensorFold 0.6.0 (MLX 4bit) | 55.66 | 1.19 s (Warm) | @ashxhart |
원문 출처
- Niklas Lenz 공식 X (@niklaslenz_ai): Local AI Test Part 2 Benchmark Results