5.95GB 초경량 27B 모델 'Bonsai 2', 가중치 레벨 거절 가드레일 해제 빌드 공개
PrismML의 Qwen3.8-27B 기반 3진법 압축 모델 Bonsai 2(5.95GB)의 거절 회로를 파일 크기 증가 없이 가중치 레벨에서 제거한 dealignai 팀의 CRACK 빌드가 공개되었습니다.
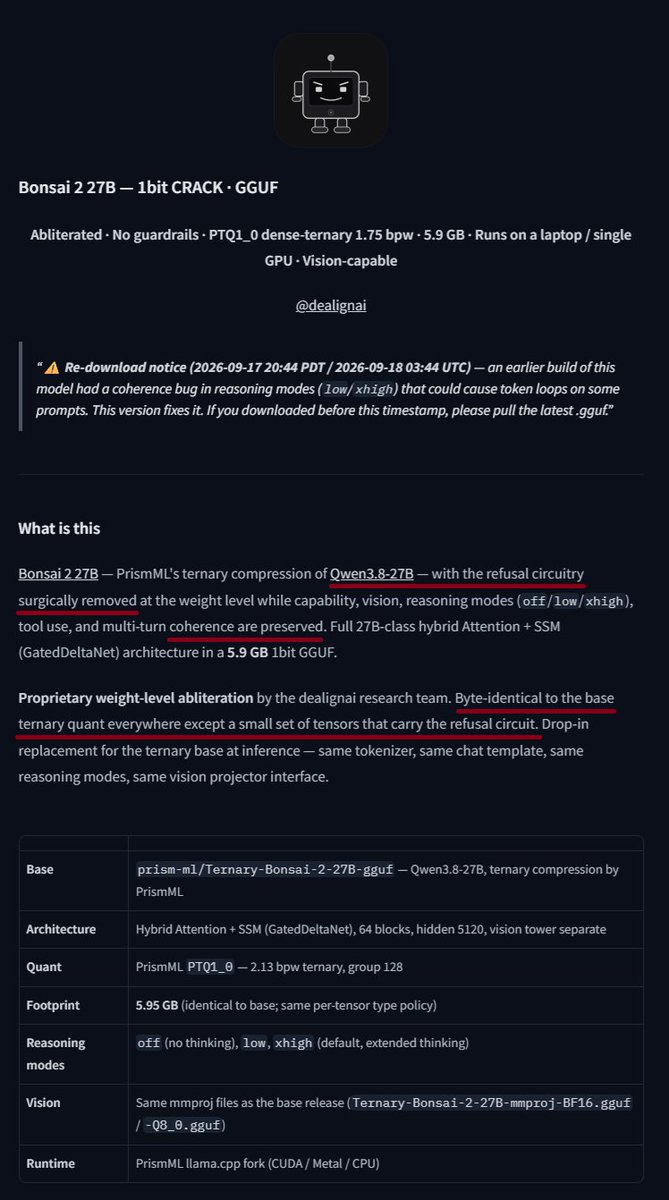
2026년 9월 23일, AI 연구 개발팀 dealignai가 PrismML의 Qwen3.8-27B 기반 초경량 3진법 압축 모델 'Bonsai 2 27B'의 내부 거절 회로를 가중치 수준에서 수술적으로 제거한 'Bonsai-2-27B-1bit-CRACK-GGUF' 및 'Bonsai-2-27B-Ternary-CRACK-GGUF' 빌드를 Hugging Face에 공개했습니다. 이번 릴리즈는 기존의 5.95GB 초소형 파일 크기를 1바이트의 증가도 없이 그대로 보존하면서, 단순 시스템 프롬프트 우회가 아닌 모델 내부 가중치 레벨에서 직접 정렬 가드레일을 절제(Abliteration)해 로컬 오픈소스 LLM 생태계의 이목을 집중시키고 있습니다.
이미지 출처: @TeksEdge / X Bonsai 2는 PrismML이 Qwen3.8-27B 모델을 독자적인 조밀 3진법(dense-ternary) 압축 기법을 통해 16비트 기준 53.8GB에 달하던 언어 가중치를 불과 5.95GB 크기로 경량화하여 단일 노트북 GPU나 8GB VRAM 그래픽카드에서도 구동 가능하도록 만든 고효율 파운데이션 모델입니다. 이번에 공개된 dealignai의 CRACK 빌드는 이처럼 극단적으로 양자화된 3진법 가중치 텐서 내부에서 지시 거절에 관여하는 특정 활성화 방향만을 정밀 타격하여 제거함으로써, 모델의 추론 능력 손실을 최소화한 무검열(Uncensored/Abliterated) 상태로 탈바꿈시켰습니다.
5.95GB 가중치 직접 수술: 파일 크기 증가 없는 거절 회로 절제
전통적인 LLM 탈옥이나 파인튜닝 방식은 추가 파라미터 어댑터(LoRA)를 연결하거나 대규모 추가 데이터셋으로 재학습을 진행하는 과정에서 모델 파일 용량이 늘어나고, 양자화 정밀도가 틀어지는 부작용을 겪기 쉬웠습니다. 반면 dealignai 팀은 이미 3진법으로 압축된 텐서 공간 내에서 거절 회로만을 가중치 차원에서 직접 소거하는 독자적인 어블리터레이션(Abliteration) 방식을 적용했습니다.
- 용량 유지: 가장 조밀한 PTQ1_0 패킹 포맷 기준 파일 용량은 오리지널 Bonsai 2와 동일한 5.95GB를 정확히 유지합니다. 270억 개 파라미터급 모델의 지능을 6GB 미만의 단일 파일로 온디바이스에서 실행할 수 있는 구조입니다.
- 다양한 패킹 포맷 제공: 1.75 bpw(effective bits per weight) 수준의 극단적 압축을 구현한 PTQ1_0 포맷 외에도, 2.13 bpw 밀도를 갖는 7.21GB 용량의 PQ2_0 3진법 포맷과 Apple Silicon MLX 환경을 위한 1.75bit JANG 번들 등 세부 하드웨어에 맞춘 다양한 빌드가 동시에 제공됩니다.
- 온디바이스 하드웨어 적합성: 16비트 FP16 원본 가중치(약 53.8GB) 대비 약 1/9 수준으로 압축되어, 8GB VRAM을 탑재한 일반 컨슈머급 그래픽카드나 랩톱에서도 모델 텐서 전체를 메모리에 완전히 적재해 대화형 추론을 수행할 수 있습니다.
HarmBench 거절률 0%와 MMLU 벤치마크: 포맷별 성능 트레이드오프
제작자 dealignai 측이 공개한 자체 벤치마크 데이터에 따르면, CRACK 빌드는 안전 가드레일 우회 성능과 추론 능력 보존 간의 실측 트레이드오프를 수치로 제시하고 있습니다.
- HarmBench-320 거절률 테스트: 베이스 모델인 PrismML Bonsai 2 27B가 93.44%에서 최대 100%의 거절률을 보이며 표준 안전 가이드라인에 따라 민감 요청을 차단한 반면, CRACK 빌드는 거절률 0.00%(200개 테스트 중 199개 순응)를 기록하여 안전 가드레일이 완전히 비활성화되었음을 확인했습니다.
- PTQ1_0(5.95GB) 포맷 MMLU 평가: 베이스 Bonsai 2의 MMLU 점수 39.69% 대비 CRACK 빌드는 38.46%를 기록하며, 단 -1.23%p의 미미한 점수 하락만으로 거절 회로를 성공적으로 제거했습니다.
- PQ2_0(7.21GB) 포맷 MMLU 평가: 조금 더 높은 정밀도를 유지하는 2.13 bpw PQ2_0 포맷의 경우, 베이스 40.53% 대비 CRACK 빌드가 39.91%(-0.62%p)를 기록하여 지식 및 상식 추론 손실을 1%p 미만으로 억제했습니다.
다만 공개된 HarmBench 및 MMLU 점수는 제작자(dealignai)의 자체 테스트 결과이며 공인된 독립 벤치마크 기관의 교차 검증을 거친 수치가 아니라는 점은 유의할 필요가 있습니다.
하이브리드 아키텍처 계승과 커스텀 런타임 호환성 및 주의사항
Bonsai 2 CRACK 빌드는 베이스 모델의 핵심 아키텍처 특성과 멀티모달 확장성을 결손 없이 계승하고 있습니다.
- 하이브리드 아키텍처 및 추론 모드: 48개 GatedDeltaNet SSM(State Space Model) 블록과 16개 풀 어텐션(Full Attention) 레이어로 구성된 총 64블록 하이브리드 구조를 유지합니다. 베이스 모델과 동일하게 토크나이저, 챗 템플릿, 도구 호출(XML Function Calling), 262K 네이티브 컨텍스트 길이, 3단계 추론 모드(
off,low,xhigh)를 모두 지원합니다. - 비전 프로젝터(mmproj) 연동: 언어 가중치 외에 독립된 6비트 아핀 비전 타워 인터페이스를 그대로 탑재하고 있어 멀티모달 이미지 및 비전 분석 작업도 동일하게 처리 가능합니다.
- 커스텀 런타임 필수 요구: 공식 메인라인 llama.cpp, Ollama, LM Studio는 해당 특수 3진법 텐서 타입(타입 142, 143)을 기본 런타임에서 지원하지 않습니다. 따라서 본 모델을 실행하려면 저비트 전용 커스텀 커널이 내장된 PrismML의 llama.cpp 포크 빌드(CUDA / Metal / CPU) 또는 vMLX 환경을 사용해야 합니다.
- 초기 빌드 루프 버그 수정: 이전 배포본에서
low및xhigh추론 모드 사용 시 특정 프롬프트에서 발생하던 토큰 무한 루프 버그는 2026년 9월 18일 자 업데이트 GGUF 파일에서 완전히 해결되었습니다.
가중치 수준에서 거절 회로가 절제된 무검열 모델인 만큼, 실제 애플리케이션 서비스 환경에 도입할 경우 발생할 수 있는 잠재적 위험에 대비해 다운스트림 계층에서 별도의 안전 모더레이션 시스템을 구축하는 것이 권장됩니다.
출처
- Hugging Face 저장소: dealignai/Bonsai-2-27B-1bit-CRACK-GGUF
- Hugging Face 저장소: dealignai/Bonsai-2-27B-Ternary-CRACK-GGUF
- 원문 소식 출처 (@TeksEdge X): TeksEdge Status 2102639098074644825
- HackerNoon 기술 분석: Bonsai-2-27B-Ternary-CRACK-GGUF: A 27B Model With Refusals Removed