내 PC 맞춤 로컬 LLM 추천부터 에이전트 하네스 연동까지: 오픈소스 'Magnitude'
하드웨어 사양을 분석해 최적의 로컬 모델과 예상 토큰 속도를 추천하고, 투기적 디코딩 튜닝과 Pi·OpenCode·Claude Code 등 주요 하네스 원클릭 연동을 지원하는 오픈소스 도구 Magnitude를 분석합니다.
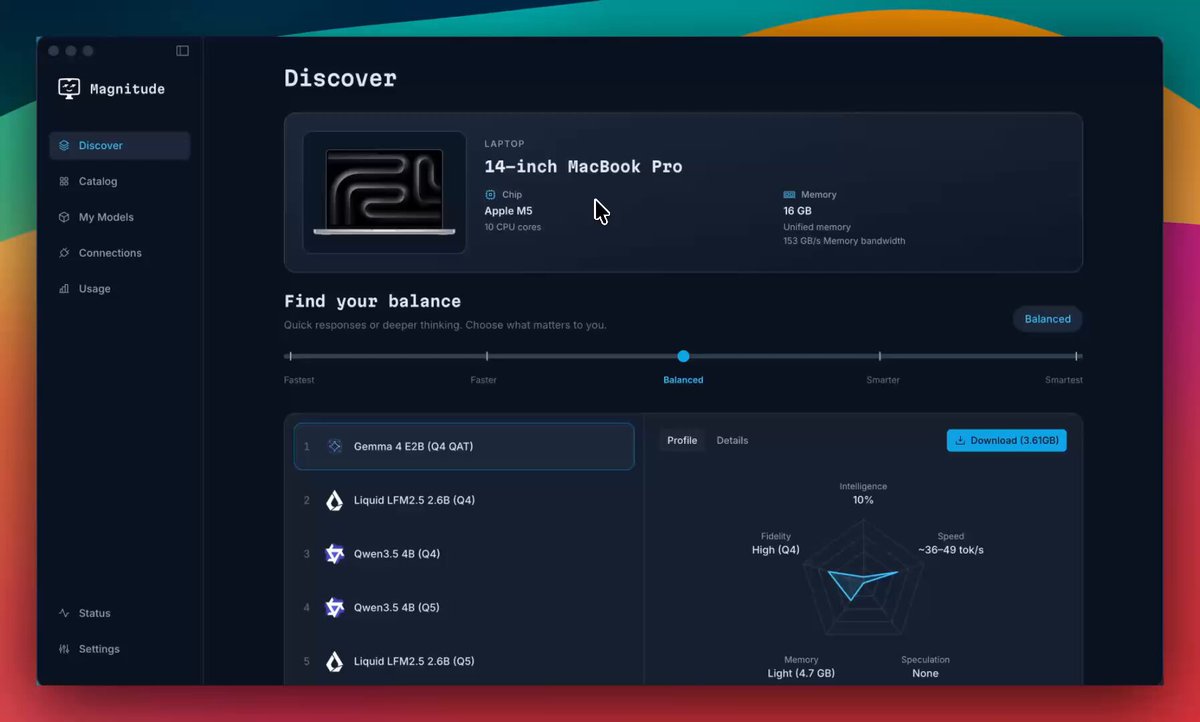
로컬 대형 언어 모델(LLM)을 데스크톱이나 워크스테이션에서 직접 구동하려는 개발자가 가장 먼저 부딪히는 장벽은 하드웨어 사양에 적합한 모델과 양자화(Quantization) 버전을 선택하는 과정입니다. 메모리 대역폭과 VRAM 용량을 일일이 계산하고 모델 구동 런타임을 구성하는 번거로움을 해결하기 위해, 하드웨어 자동 프로파일링과 맞춤형 튜닝, 코딩 에이전트 하네스 연동을 하나로 결합한 오픈소스 도구 ‘Magnitude(매그니튜드)’가 공개되었습니다.
이미지 출처: @_avichawla / Magnitude
하드웨어 자동 프로파일링과 4대 지표 기반 모델 랭킹
Magnitude의 핵심 차별점은 모델 가중치를 다운로드하기 전에 로컬 PC의 하드웨어 스펙을 정밀하게 진단하고 성능을 사전 예측한다는 점입니다.
기존 로컬 LLM 구동 도구들이 사용자의 수동 모델 선택과 시행착오에 의존했던 반면, Magnitude는 시스템의 칩셋, 가용 시스템 RAM 및 VRAM, 메모리 대역폭을 종합적으로 분석합니다. Apple Silicon, NVIDIA 및 AMD GPU는 물론 순수 CPU 환경까지 폭넓게 지원합니다.
프로파일링이 완료되면 카탈로그에 등록된 모델과 각 양자화 버전별로 예상 추론 속도(tok/s)를 사전에 계산해 제공하며, 사용자가 목적에 맞춰 선택할 수 있도록 4가지 핵심 축으로 모델 순위를 매깁니다.
- 추론 속도(Speed): 하드웨어 메모리 대역폭과 컴퓨팅 코어에 기반한 초당 토큰 생성 속도(tok/s) 예상치
- 정확도(Accuracy): 태스크 수행 시의 응답 정밀도 및 할루시네이션 억제 수준
- 지능 지수(Intelligence): 복합 추론 및 코딩·지시 이행 역량 벤치마크 점수
- 요구 메모리(Memory Required): 컨텍스트 윈도우 확장에 따른 최소 필요 VRAM/RAM 할당량
이를 통해 개발자는 대용량 모델 가중치를 수십 기가바이트씩 내려받고 나서야 메모리 부족(OOM)이나 느린 추론 속도로 실패를 겪는 비효율을 사전에 방지할 수 있습니다.
투기적 디코딩 맞춤 튜닝과 온디맨드 리소스 라이프사이클
모델을 선택한 이후의 실행 환경 구성과 자원 관리 또한 시스템 수준에서 자동 최적화됩니다.
Magnitude는 하드웨어 사양에 맞춰 컨텍스트 크기뿐만 아니라 투기적 디코딩(Speculative Decoding)과 동시성 처리를 엔드투엔드로 세팅합니다. 작은 드래프트 모델과 타깃 모델을 결합하는 투기적 디코딩을 기기 특성에 맞게 구성하여 일반적인 단일 모델 추론 대비 유효 토큰 생성 속도를 대폭 끌어올립니다.
또한 리소스 관리 측면에서는 온디맨드(On-demand) 모델 라이프사이클을 채택했습니다.
- 요청 시 즉시 로드(Load on Request): 에이전트나 사용자의 질의가 인입되는 시점에 최적화된 가중치를 메모리에 올립니다.
- 유휴 상태 자동 해제(Unload when Idle): 일정 시간 추론 호출이 없거나 백그라운드 상태로 전환되면 모델을 메모리에서 내려 시스템 자원을 환원합니다.
- 메모리 부족 시 안전 보호(Unload on Memory Pressure): 다른 시스템 작업으로 메모리가 부족해지는 상황을 감지해 메모리 누수나 크래시를 방지합니다.
Pi·OpenCode·Claude Code 등 코딩 에이전트 하네스 원클릭 연동
Magnitude가 개발 도구로서 큰 주목을 받는 이유는 로컬 모델 런타임에 머무르지 않고 실제 작업자가 사용하는 코딩 에이전트 하네스와의 즉각적인 브릿지를 제공하기 때문입니다.
CLI와 데스크톱 앱 형태로 배포되며, 번거로운 백그라운드 데몬 설정 없이 단일 명령어로 실행할 수 있습니다.
- CLI 설치:
npm install -g @magnitudedev/cli - 실행:
magnitude(데몬 설정 없이 단일 명령어로 즉시 구동) - 스킬 확장: Excel, PDF, Chrome 등의 작업을 지원하는 스킬 확장 기능 제공
무엇보다 Pi, OpenCode, Hermes, Claude Code, Codex, Cline 등 주요 코딩 에이전트 하네스에 원클릭 또는 단일 명령어로 로컬 모델을 연결할 수 있습니다. 클라우드 API 키나 호출 토큰 과금 없이 완전한 오프라인 환경에서 프라이빗하게 코딩 어시스턴트를 운용할 수 있는 실질적인 인프라를 제공합니다.
다만 기기의 물리적 메모리(RAM/VRAM) 한계를 초과하는 파라미터 크기나 높은 비트의 모델은 구동할 수 없으며, 연동하려는 에이전트 하네스의 로컬 CLI 버전에 따라 추가 브릿지 옵션 구성이 필요할 수 있습니다. 프로젝트는 Apache 2.0 라이선스로 전체 소스코드가 공개되어 있어 기업 및 개인 환경에서 자유롭게 감사하고 수정할 수 있습니다.
출처
- Magnitude 공식 웹사이트: Magnitude - Run the best local models for your machine
- Avi Chawla 공식 X (@_avichawla): Magnitude 런칭 및 기능 발표
- Magnitude GitHub 저장소: GitHub - magnitudedev/magnitude