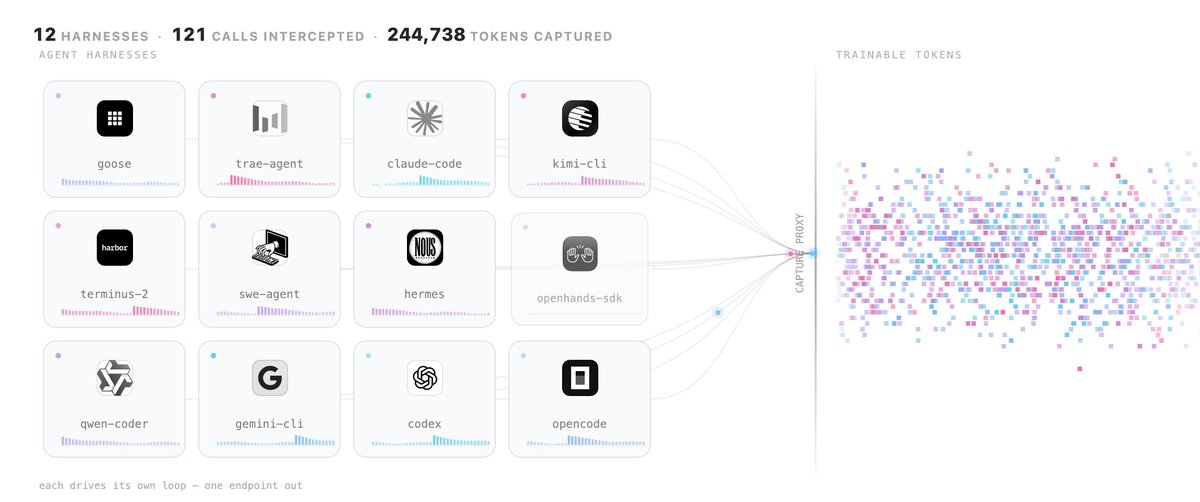
Claude Code·Codex 하네스를 그대로 RL 환경으로: 허깅페이스 OpenEnv 공개
하네스나 학습 코드 수정 없이 Claude Code, Codex 등 10개 코딩 하네스를 강화학습 환경으로 전환하는 허깅페이스 OpenEnv 프록시와 TRL 기반 훈련 스택이 완전 오픈소스로 공개되었습니다.
TAU-HOME.COM에서 vLLM 태그로 묶인 글입니다.
하네스나 학습 코드 수정 없이 Claude Code, Codex 등 10개 코딩 하네스를 강화학습 환경으로 전환하는 허깅페이스 OpenEnv 프록시와 TRL 기반 훈련 스택이 완전 오픈소스로 공개되었습니다.
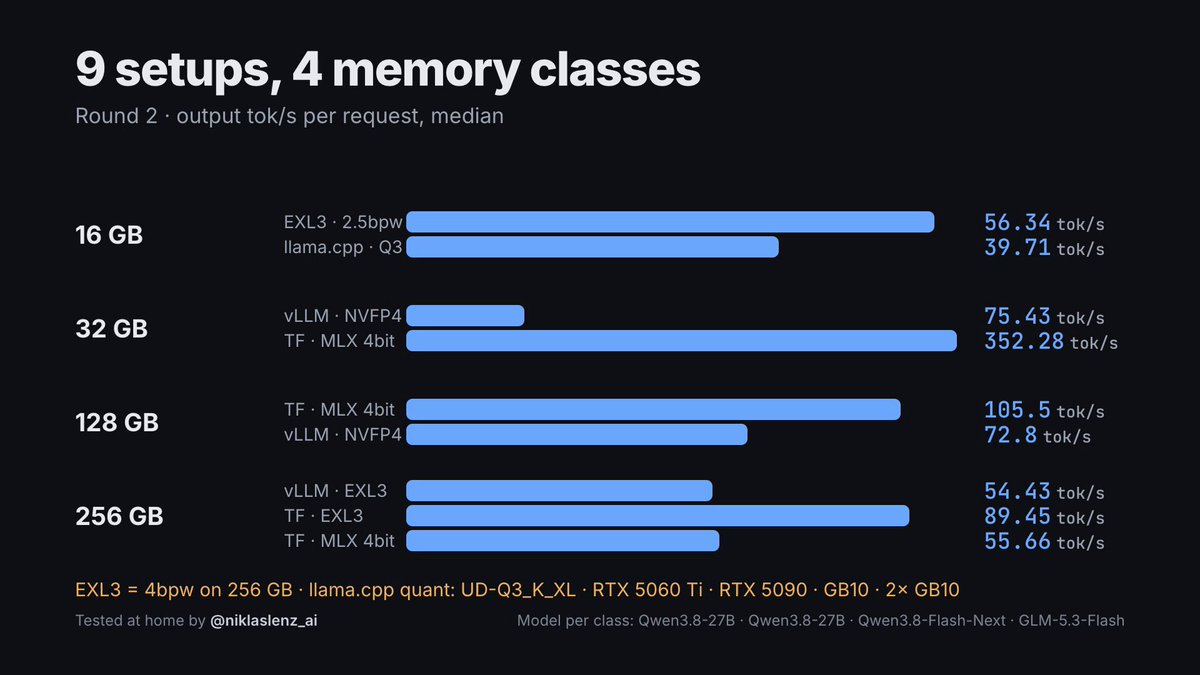
RTX 5060 Ti(16GB), RTX 5090(32GB), GB10(128GB/256GB) 환경에서 Qwen3.8-27B, Qwen3.8-Flash-Next, GLM-5.3-Flash 모델의 런타임별 추론 속도(tok/s)와 첫 토큰 지연시간(TTFT)을 실측 비교한 벤치마크 결과입
vllm-sr 연구진이 0.6B 초경량부터 27B까지 전 체급을 포괄하는 오픈소스 의사결정 특화 모델 'Decision 2.0'을 Hugging Face에 공식 공개했습니다. 단일 순방향 패스로 정합된 확률을 출력하며 에이전트 라우팅과 온체인 스캔에 최적화된 선택지를 제공합니다.
NVIDIA Model Optimizer(ModelOpt)는 NVFP4·FP8 양자화, 구조화된 가지치기, 지식 증류를 단일 라이브러리로 통합해 TensorRT-LLM, vLLM, SGLang 배포 추론 속도를 최적화하는 오픈소스 프레임워크입니다.
DiffusionGemma 26B-A4B 모델에서 JSON 토큰 생성 대신 고정 캔버스에 결정 슬롯만 열어두고 확률을 즉시 판독해 Jev 호환 로컬 의사결정 API를 구축하는 vLLM 패치 기반 최적화 팁.
vLLM이 텍스트 디퓨전 모델 DiffusionGemma를 활용해 캔버스에 템플릿을 고정하고 단 1회의 디노이징 스텝으로 Yes/No, 다지선다, 점수 및 신뢰도 확률 분포를 즉시 추출하는 Jev 스타일 구조화 추론을 지원합니다.
초거대 AI 모델의 이면에서 대규모 서빙과 로컬 실행, 게이트웨이, 벡터 검색, 분산 오케스트레이션을 지탱하는 10대 핵심 오픈소스 인프라 저장소(vLLM, llama.cpp, SGLang, Ollama, LiteLLM, Milvus, Qdrant, TensorRT-LLM, Ray, K
Impact-Site-Verification: 9b3ebd10-6c45-44cf-a014-5b8c19b7b285