디퓨전젬마를 Jev처럼: 토큰 생성 없이 슬롯 확률 직접 판독으로 초고속 구조화 의사결정 구현하기
DiffusionGemma 26B-A4B 모델에서 JSON 토큰 생성 대신 고정 캔버스에 결정 슬롯만 열어두고 확률을 즉시 판독해 Jev 호환 로컬 의사결정 API를 구축하는 vLLM 패치 기반 최적화 팁.
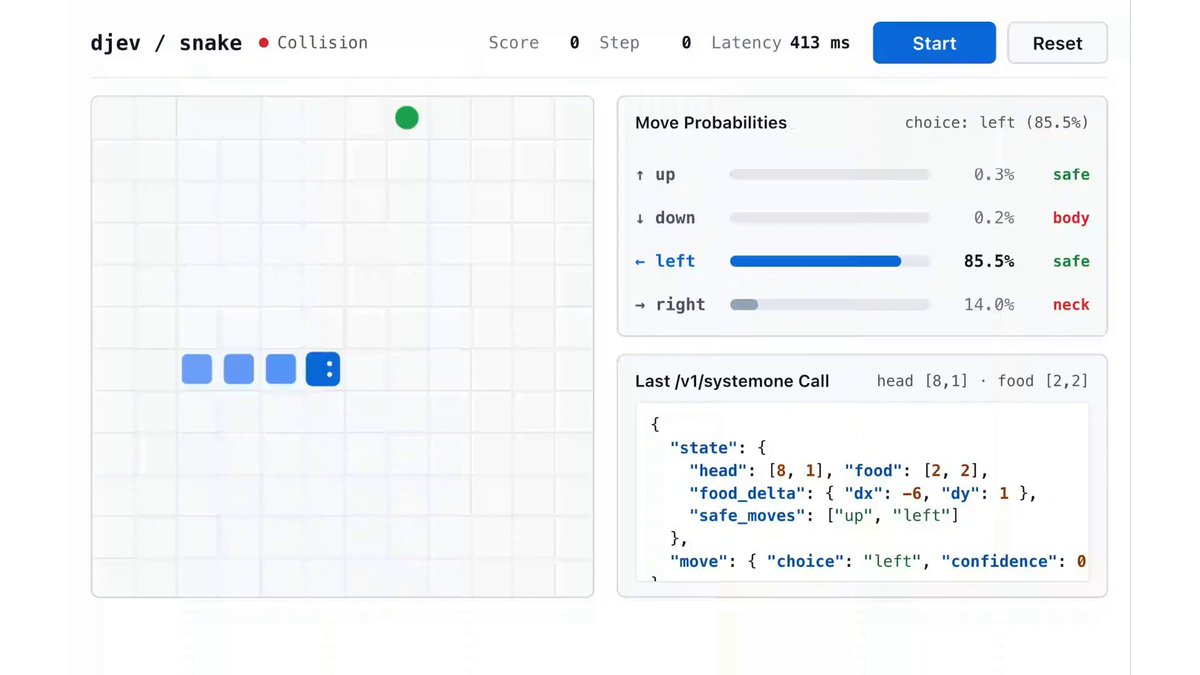
인공지능 및 고성능 컴퓨팅 엔지니어 데이비드 헨드릭슨(David Hendrickson, @TeksEdge)이 오픈소스 프로젝트 Djev-Spark를 인용하며, 구글의 오픈 가중치 텍스트 디퓨전 모델인 디퓨전젬마(DiffusionGemma 26B-A4B)를 TypeSafe의 경량 의사결정 모델 Jev처럼 구동시키는 새로운 구조화 추론 최적화 기법을 공유했습니다. 기존 거대언어모델(LLM)이 문맥에 따라 토큰을 하나씩 순차적으로 생성하는 오토리그레시브(Autoregressive) 방식과 달리, 디퓨전 모델 특유의 캔버스 구조를 활용해 JSON 토큰 생성 자체를 생략하고 핵심 결정 슬롯의 확률을 직접 판독하는 것이 핵심입니다.
이미지 출처: David Hendrickson (@TeksEdge)
JSON 토큰 생성 거부: 캔버스 사전 채움과 결정 슬롯 직접 판독
전통적인 언어 모델에서 구조화된 JSON 출력을 얻으려면 스키마에 맞춰 키와 구두점을 포함한 모든 텍스트 토큰을 순차적으로 생성해야 합니다. 이 과정은 불필요하게 많은 디코딩 단계를 거치며 지연 시간을 유발하고, 문법 오류가 발생할 위험을 내포합니다. 반면 구글의 Gemma 4 아키텍처 기반 Mixture-of-Experts(MoE) 텍스트 디퓨전 모델인 DiffusionGemma는 여러 단계의 디노이징 과정을 통해 캔버스 전체의 토큰들을 병렬로 정제하는 독특한 메커니즘을 지니고 있습니다.
사쿠라 유키(@sakurayukiai)가 기술 토론에서 지적했듯, 이번 최적화의 본질은 JSON을 더 빠르게 생성하는 것이 아니라 JSON 생성 자체를 거부하는 데 있습니다. Djev-Spark는 완성될 구조화 응답의 고정된 JSON 뼈대를 캔버스에 미리 채워두고(prefill the canvas), 오직 모델이 판단해야 할 결정 슬롯 위치만 공백으로 비워둡니다. 이후 vLLM PR #57250으로 제안된 구조화 읽기 확장 기능(diffusion_seed_canvas, diffusion_read_only)을 통해 단 1회의 디노이징 전방 계산만으로 해당 슬롯에 허용된 레이블 토큰 ID들의 logprob과 엔트로피를 직접 판독한 뒤 사후 직렬화합니다.
NVFP4 로컬 구동과 Jev 호환 System One 엔드포인트 구성
Djev-Spark는 로컬 환경에서 NVFP4 양자화를 적용하고 커스텀 패치된 vLLM 구조화 읽기 엔진을 결합하여 동작합니다. 현재는 NVFP4 하드웨어 가속을 온전히 지원하는 NVIDIA GB10과 같은 고성능 GPU 환경을 필요로 합니다. 이 스택은 외부로 Jev 호환 와이어 API(POST /v1/systemone 또는 POST /v1/request)를 노출하므로, TypeSafe SDK를 활용해 Noul(불리언 판정), Choice(단일 선택), Score(점수화) 태스크를 수행하던 기존 애플리케이션 코드를 수정 없이 그대로 로컬로 전환할 수 있습니다.
이는 일반적인 채팅 엔드포인트를 통해 JSON 확률을 프롬프트 형태로 질의하고 모델의 자기 보고 수치를 받아오는 LocalJev 방식과 근본적인 차이를 보입니다. LocalJev는 Bun 환경에서 oMLX 백엔드를 사용해 호환성을 확보하지만 로짓을 직접 판독하지 못하는 한계가 있는 반면, OpenJev와 Djev 계열은 실제 엔진 로짓 레벨에서 확률 분포를 추출합니다. JevBench v1.2.8 공식 벤치마크 기록에 따르면 djev는 74.3점을 기록하여 Jev 1.13.0(75.4점)과 SemIf(74.7점)에 이어 3위에 올랐으며, 초기 양자화 텍스트 벤치마크에서는 1,000회 요청 기준 p50 76.87ms, p95 86.40ms의 응답 속도를 달성했습니다. 다만 이 수치는 과거 양자화 텍스트 실행 기준이며 현재 BF16 릴리즈나 이미지 질의에는 직접 적용되지 않습니다.
캐시 재사용에 따른 성능 편차와 실무 적용 시 고려사항
실무 파이프라인에서 Djev 방식을 평가하거나 도입할 때에는 프롬프트 캐시 재사용 여부에 따른 성능 차이를 명확히 인지해야 합니다. 벤치마크 측정에 참여한 마티아스 하인케(Mathias Heinke, @ares_mheinke)는 110,707개 토큰 문맥을 기준으로 테스트했을 때 콜드 스타트 지연 시간이 105초에 달했던 반면, 캐시가 예열된 웜 스타트 상태에서는 불과 0.44초가 소요되었다는 실측 결과를 공개했습니다.
하인케는 새로운 문서를 지속적으로 처리해야 하는 실무 환경에서는 이전 입력의 캐시 재사용 효과가 배제된 콜드 스타트 지표가 훨씬 중요하다며, 공정한 성능 비교를 위해서는 의도적으로 캐시를 비우고 측정해야 한다고 강조했습니다. 아울러 커뮤니티에서는 Laya와 같은 대안 구현이 더 빠르다는 0xBakeer의 의견 등 다양한 비교 논의가 이어지고 있습니다. Djev-Spark 스택을 구축하기 위해서는 vLLM의 9개 런타임 파일을 수정한 커스텀 패치(siliconflow/dgemma-jev-patch 계열) 적용과 고용량 GPU 확보가 필수적이며, 모델이 반환한 엔트로피가 특정 임계값을 초과할 경우 추가 샘플링을 수행해 신뢰도를 검증하는 방어적 로직 설계가 권장됩니다.
원문 출처
- David Hendrickson (@TeksEdge) X 포스트: DiffusionGemma 26B-A4B Jev 호환 구조화 판독 및 Djev-Spark 구동 소개
- 기술 토론 및 벤치마크 참여자: Sakura Yuki (@sakurayukiai), Mathias Heinke (@ares_mheinke), 0xBakeer (@0xBakeer)
- 관련 기술 참조: vLLM PR #57250 (DiffusionGemma structured generation mode), djev-dev 및 JevBench 벤치마크 리포트 (Jev News)