Claude Code·Codex 하네스를 그대로 RL 환경으로: 허깅페이스 OpenEnv 공개
하네스나 학습 코드 수정 없이 Claude Code, Codex 등 10개 코딩 하네스를 강화학습 환경으로 전환하는 허깅페이스 OpenEnv 프록시와 TRL 기반 훈련 스택이 완전 오픈소스로 공개되었습니다.
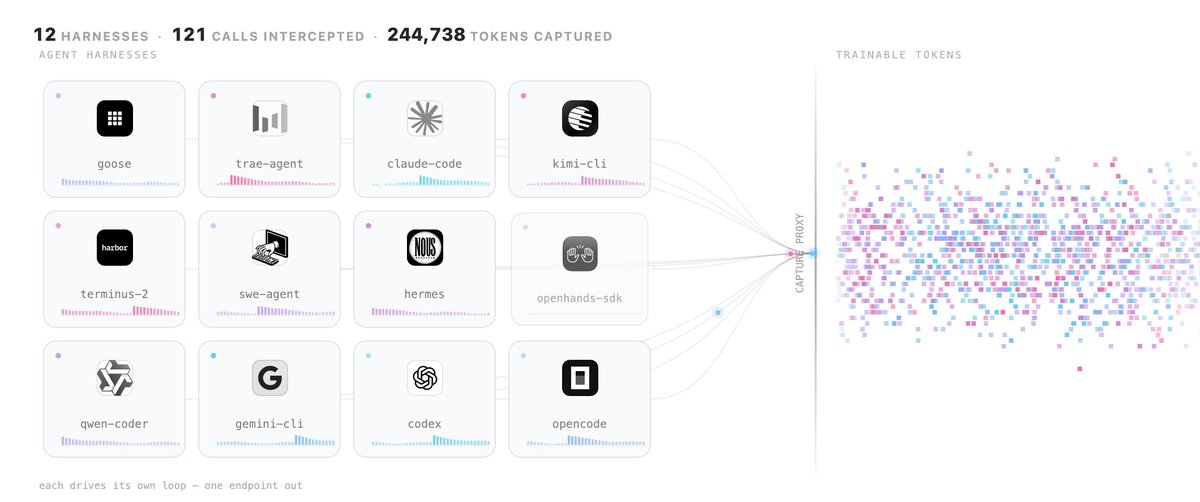
허깅페이스(Hugging Face)가 2026년 10월 5일, Claude Code, Codex, Hermes, Pi, OpenCode 등 실제 개발 현장에서 사용되는 코딩 에이전트 하네스를 코드 수정 없이 강화학습(RL) 환경으로 직접 연동하는 캡처 프록시 프레임워크 'OpenEnv'와 TRL 기반의 전체 훈련 파이프라인을 완전 오픈소스로 공개했습니다.
이미지 출처: @ClementDelangue on X / Hugging Face
그동안 코딩 에이전트를 강화학습으로 훈련하려면 에이전트의 내부 제어 흐름과 도구 실행 환경을 커스텀 학습용 환경으로 밑바닥부터 재구현해야 했습니다. 이로 인해 대다수 연구 모델은 실제 개발자가 사용하는 상용 CLI나 에디터 플러그인이 아닌, 연구실 전용 간이 스캐폴드(scaffold)에서만 훈련되어 실무 배포 시 심각한 성능 저하를 겪어왔습니다. 허깅페이스 연구팀(Adithya S.K., Ben Burtenshaw 등)은 하네스를 재작성하는 대신, 에이전트와 모델 사이의 통신 트래픽을 가로채는 경량 프록시 아키텍처를 도입해 이 문제를 해결했습니다.
실전 하네스와 벤치마크 스캐폴드의 괴리: 동일 가중치 62% vs 33%
코딩 에이전트 평가에서 하네스 구조 자체가 모델 성능에 미치는 영향은 예상보다 훨씬 컸습니다.
허깅페이스 연구팀이 Liquid AI의 오픈 가중치 소형 모델인 LFM2.5-2.6B를 대상으로 소프트웨어 엔지니어링 벤치마크를 수행한 결과, 모델 가중치가 완전히 동일함에도 불구하고 경량 연구용 하네스인 Mini-SWE-Agent에서는 62%의 문제 해결률을 기록한 반면 상용 프로덕션 도구인 Claude Code 하네스에서는 33%로 급락했습니다.
- 스캐폴드 편향: 에이전트가 사용하는 시스템 프롬프트, 도구 호출 프로토콜, 작업 디렉토리 인덱싱 방식, 오류 반환 형식의 미세한 차이가 벤치마크 점수에 결정적인 왜곡을 초래합니다.
- 배포 불일치: 연구용 스캐폴드에 과적합된 모델은 개발자가 실제로 사용하는 터미널 환경이나 대화형 하네스에 탑재되었을 때 도구 호출 문법 오류나 컨텍스트 누수를 극복하지 못하고 실패율이 높아집니다.
연구팀은 실제 사용자가 쓰는 하네스 자체를 수정하지 않고 그대로 강화학습 환경의 롤아웃 루프로 편입시키는 것이 실전 코딩 성능 확보의 핵심 전제라고 지적했습니다.
프록시 인터셉션 아키텍처: 4개 API 규격 중계와 정확한 로그 확률 기록
OpenEnv의 핵심 메커니즘은 코딩 하네스를 다시 만드는 것이 아니라 투명한 캡처 프록시(Capture Proxy)를 배치하는 것입니다.
하네스는 평소처럼 원격 LLM 제공자의 공식 API 엔드포인트와 통신한다고 인식하지만, 실제로는 로컬 또는 호스트 측의 OpenEnv 프록시가 트래픽을 중계합니다.
- 4대 주요 API 프로토콜 네이티브 지원: 코딩 에이전트 생태계에서 널리 쓰이는 OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Google Gemini 규격을 모두 지원합니다.
- vLLM 백엔드 직결 및 토큰 캡처: 전달받은 요청을 고성능 추론 엔진인 vLLM으로 라우팅하고, vLLM이 샘플링한 정확한 토큰 ID와 로그 확률(logprobs)을 손실 없이 캡처합니다.
- TRL 훈련 파이프라인 연계: 캡처된 다단계 추론 궤적(trajectory)과 보상 신호는 Hugging Face TRL(Transformer Reinforcement Learning) 라이브러리에 실시간 전달되어 비동기 GRPO(Async GRPO) 정책 업데이트에 사용됩니다.
이 방식을 통해 Claude Code, Codex, Hermes, Pi, OpenCode를 포함한 10개 코딩 에이전트 하네스가 단 한 줄의 코드 수정 없이 즉시 강화학습 환경으로 구동됩니다. 에이전트 샌드박스로는 Harbor 및 Docker 격리 컨테이너를 결합해 안전한 코드 실행과 테스트 채점을 수행합니다.
멀티 하네스 학습 성과와 도구 호출 31% 절감 리워드 셰이핑
실제 훈련 결과는 단일 하네스 최적화와 다중 하네스 동시 학습 간의 현격한 성능 격차를 증명했습니다.
LFM2.5-2.6B 모델을 OpenCode 단일 하네스에서만 강화학습으로 훈련했을 경우, OpenCode 내 해결률은 34%에서 58%로 크게 개선되었으나 다른 하네스 환경에서는 유의미한 성능 전이가 일어나지 않았습니다. 반면 4개 하네스 환경에서 동시에 강화학습을 진행했을 때는 전 하네스 평균 해결률이 42%에서 54%로 상승했으며, 특히 Claude Code 환경 기준 해결률이 33%에서 49%로 대폭 향상되었습니다.
- SFT와의 비교 우위: Qwen3.8-27B가 생성한 3,189개 고품질 롤아웃 데이터를 활용한 지도 미세조정(SFT) 모델은 해결률 47.5%에서 정체(plateau)를 보이며 두 가지 RL 실험 결과보다 낮았습니다. 사전 기록된 정적 데이터로 학습한 소형 모델은 자신이 잘못된 도구 호출을 실행했을 때 하네스가 반환하는 에러 피드백을 실시간으로 수습하는 방법을 학습하지 못하기 때문입니다.
- 도구 호출 효율화 리워드 셰이핑: 연구팀은 과제 해결 성공 여부뿐만 아니라, '더 적은 횟수의 도구 호출로 문제를 해결할 때' 추가 보상을 지급하는 리워드 셰이핑을 적용했습니다. 그 결과 기해결 과제 기준 전 하네스 평균 도구 호출 횟수가 31% 감소했으며, Codex 하네스 기준으로는 호출 수가 약 절반 수준으로 대폭 축소되어 에이전트 실행 시간과 API 추론 비용을 동시에 낮췄습니다.
오픈소스 생태계 배포 자산과 인프라 고려사항
허깅페이스는 재현성과 커뮤니티 연구 촉진을 위해 이번 프로젝트의 전체 자산을 전면 공개했습니다.
공개된 패키지에는 OpenEnv 캡처 프록시 리포지토리, TRL 트레이너 모듈, 벤치마크 태스크 세트, 3,189개 롤아웃 SFT 데이터셋, 전체 학습 실행 스크립트, 그리고 단계별로 훈련된 7개 오픈 모델 체크포인트가 모두 포함됩니다.
다만 실제 인하우스 환경에서 멀티 하네스 롤아웃과 비동기 GRPO 학습 루프를 직접 운용하려면 vLLM 호스팅 및 다중 격리 샌드박스를 원활히 실행할 수 있는 충분한 GPU 인프라와 컨테이너 오케스트레이션 설정이 뒷받침되어야 합니다. 또한 단일 하네스에만 치우친 훈련은 특정 도구 호출 방언에 모델을 종속시킬 수 있으므로, 실무 환경에 맞춘 멀티 하네스 혼합 훈련 프로토콜을 구성하는 것이 필수적입니다. 허깅페이스 연구팀은 이번 2.6B 소형 모델 성과에 이어 대규모 모델과 확장된 훈련 런을 순차적으로 공개할 계획입니다.
출처
- GitHub: huggingface/OpenEnv
- Clement Delangue 공식 X (@ClementDelangue): OpenEnv Multi-Harness RL Release
- Adithya S.K. 연구원 X 스레드 (@adithya_s_k): The Ultimate Guide to Multi-Harness RL