vLLM, DiffusionGemma 기반 단일 스텝 의사결정 모드 지원 시작
vLLM이 텍스트 디퓨전 모델 DiffusionGemma를 활용해 캔버스에 템플릿을 고정하고 단 1회의 디노이징 스텝으로 Yes/No, 다지선다, 점수 및 신뢰도 확률 분포를 즉시 추출하는 Jev 스타일 구조화 추론을 지원합니다.
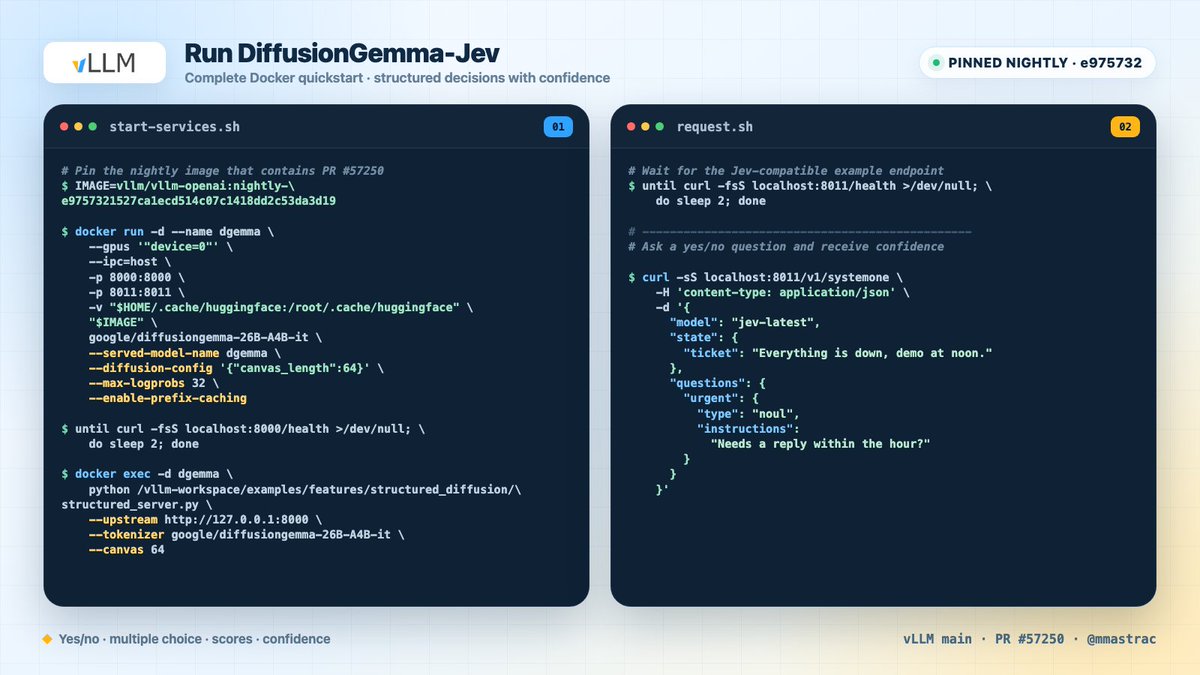
고성능 오픈소스 LLM 서빙 프레임워크 vLLM(@vllm_project)이 2026년 9월 23일, 텍스트 디퓨전 파운데이션 모델 DiffusionGemma를 기반으로 고정 응답 템플릿과 단 1회의 디노이징 패스를 결합한 구조화 의사결정 모드(DiffusionGemma-Jev) 지원을 공식 발표하고 업스트림 코드베이스에 병합했습니다. 이번 기능은 Matt Mastracci(@mmastrac)의 PR 기여를 통해 vLLM에 공식 통합되었으며, 기존 오토리그레시브(Autoregressive) 생성 모델의 순차적 토큰 디코딩 병목을 건너뛰고 정형화된 의사결정과 신뢰도 확률 분포를 초저지연으로 추출하는 새로운 추론 경로를 제시합니다.
이미지 출처: @vllm_project
이번 업데이트는 경량 의사결정 모델 Jev가 제시했던 마이크로 판단 메커니즘을 오픈소스 디퓨전 LLM(dLLM) 가속 인프라에 직접 이식한 사례로 평가받고 있습니다. 기존 언어 모델이 분류나 라우팅을 수행할 때 겪던 순차 디코딩 지연 시간과 문법 제약 엔진(FSM) 오버헤드를 근본적으로 줄여 에이전트 하네스 설계에 즉각적인 변화를 가져올 전망입니다.
양방향 어텐션 캔버스와 단 1회의 디노이징 메커니즘
이번 지원의 핵심 원리는 텍스트 디퓨전 모델인 DiffusionGemma(Gemma 4 기반 26B 아키텍처)의 고유한 디코딩 구조에 기반합니다.
전통적인 인과적(Causal) 언어 모델은 이전 토큰을 기반으로 다음 토큰을 하나씩 순차 생성하지만, DiffusionGemma의 디코더는 출력 캔버스 전체에 걸쳐 비인과적 양방향 어텐션(Bidirectional Attention)을 적용합니다. 캔버스의 모든 위치가 KV 캐시에 저장된 프롬프트 컨텍스트는 물론, 주변 JSON 키와 다른 모든 슬롯을 동일한 시점에 동시에 참조할 수 있습니다.
- 캔버스 템플릿 시딩(Canvas Seeding): 응답에 필요한 고정 텍스트 구조나 JSON 키를 캔버스에 미리 배치하고, 모델이 채워 넣어야 할 핵심 답변 슬롯만 노이즈 상태로 남겨둡니다.
- 단일 디노이징 패스(Single Denoising Step): 개방형 텍스트 생성처럼 수십 회의 점진적 디노이징 루프를 거치지 않고, 단 1회의 순전파(Forward Pass)만 실행해 답변 슬롯을 디노이징합니다.
- 토큰 확률 및 엔트로피 즉각 추출: 단 한 번의 스텝으로 지정된 슬롯의 어휘 확률 분포(Logprob)와 엔트로피를 직접 읽어내어, 가장 가능성 높은 답변과 해당 결정의 신뢰도를 동시에 획득합니다.
- 단일 토큰 슬롯 제약: 캔버스 위치가 어긋나지 않도록 답변 슬롯은 단일 토큰으로 구성되어야 하며, 다중 토큰 옵션은 클라이언트 수준에서 'A', 'B' 등의 단일 토큰 기호로 매핑하여 처리합니다.
이 방식을 통해 개발자는 별도의 분류 헤드를 학습시키거나 복잡한 제약 디코딩 오토마타를 거치지 않고도, Yes/No 판단, 다지선다 옵션 선택, 정량적 점수 채점을 즉시 산출할 수 있습니다.
단일 스텝 레이턴시와 에이전트 분기 판단 가치
오토리그레시브 모델이 분류나 라우팅 호출에서 토큰을 하나씩 순차 생성하며 지연 시간을 누적시키는 것과 달리, 단 1회의 순전파 디노이징으로 후보 토큰을 평가하는 방식은 의사결정 집약적 워크로드의 턴당 지연 시간을 대폭 단축합니다.
이러한 특성은 에이전트 하네스(Agent Harness) 및 워크플로우 오케스트레이션에서 의사결정 병목을 해소하는 데 직접적인 이점을 제공합니다:
- 검증 패스 없는 단일 호출 분기: 기존에는 모델이 텍스트를 출력한 뒤 별도의 파싱과 검증 단계를 거쳐야 했으나, 이제 단 한 번의 호출로 답변과 슬롯별 신뢰도 수치를 동시에 확보해 조건부 분기를 즉각 트리거할 수 있습니다.
- 신뢰도 및 엔트로피 기반 동적 라우팅: argmax 단일 결과뿐 아니라 전체 슬롯 확률 분포와 엔트로피를 함께 받아볼 수 있어, 엔트로피가 사전에 설정한 임계값을 통과하지 못할 때만 추가 샘플링을 수행하거나 상위 추론 모델로 에스컬레이션할 수 있습니다.
- 문법 파싱 실패 원천 차단: 템플릿의 정적 구조가 캔버스에 이미 고정되어 있으므로, LLM이 잘못된 JSON 포맷을 출력하거나 필드를 누락해 런타임 에러가 발생하는 구조적 결함을 방지합니다.
Nightly 프리뷰 배포와 운영 시 고려사항
현재 본 기능은 vLLM 공식 나이틀리 빌드 컨테이너(vllm/vllm-openai:nightly)를 통해 개발자 프리뷰 형태로 즉시 배포되어 사용할 수 있습니다.
개발자는 나이틀리 컨테이너를 실행하고 예제 서버를 기동한 뒤 Jev 호환 엔드포인트를 호출하여 기능을 테스트할 수 있습니다. vLLM 팀은 공식 레시피 저장소와 개발자 문서를 통해 세부 실행 가이드를 함께 제공하고 있습니다.
다만 실무 파이프라인 도입 시 몇 가지 제약과 주의점을 염두에 두어야 합니다:
- 프리뷰 단계 인터페이스 변동 가능성: 나이틀리 빌드에서 선행 제공되는 기능이므로, 향후 공식 안정화 릴리스 이전까지 요청/응답 형식이나 세부 인터페이스 규격이 조정될 수 있습니다.
- 슬롯 신뢰도의 범위 한계: 단일 디노이징 스텝으로 획득하는 신뢰도와 확률은 사전에 고정된 템플릿 캔버스 내 슬롯 후보군 사이의 상대적 분포를 의미합니다. 입력 프롬프트 자체의 논리적 타당성이나 개방형 생성 전반의 품질을 보증하는 것은 아니므로 도메인 특성에 맞춘 임계값 캘리브레이션이 권장됩니다.
출처
- vLLM 공식 X (@vllm_project): DiffusionGemma-Jev vLLM 지원 발표 스레드
- vLLM 공식 레시피: DiffusionGemma 26B Jev-Style Structured Decisions Guide
- vLLM 공식 문서: Structured Reads on DiffusionGemma
- vLLM 공식 블로그: DiffusionGemma: The First Diffusion LLM Natively Supported in vLLM