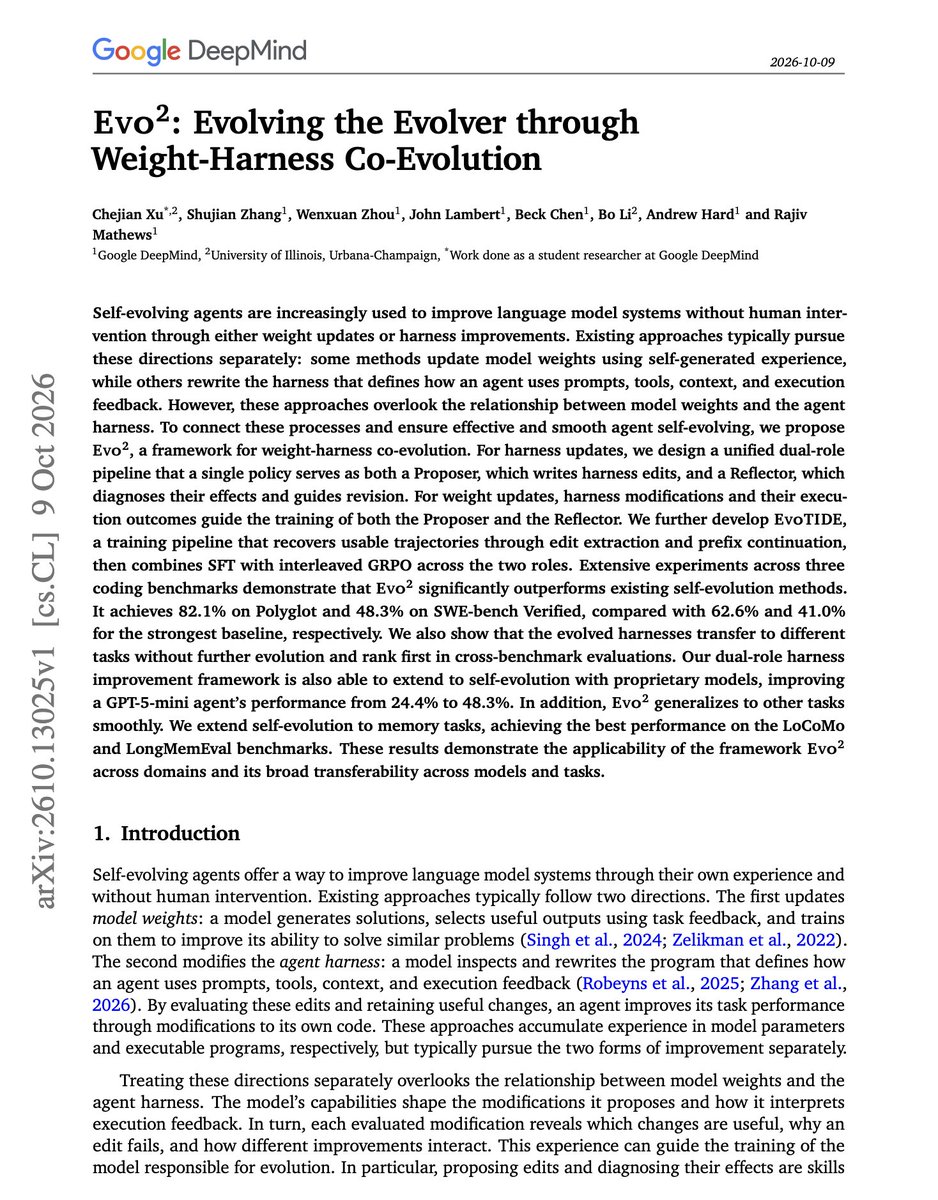
구글 딥마인드, 에이전트 하네스와 가중치를 공진화하는 'Evo2' 프레임워크 공개
구글 딥마인드가 에이전트 실행 환경(하네스)과 모델 가중치를 함께 진화시키는 공진화 프레임워크 'Evo2'를 발표했습니다. 제안자-반영자 루프와 SFT 및 인터리브드 GRPO를 결합해 SWE-bench Verified 48.3%를 달성했습니다.
TAU-HOME.COM에서 ReinforcementLearning 태그로 묶인 글입니다.
구글 딥마인드가 에이전트 실행 환경(하네스)과 모델 가중치를 함께 진화시키는 공진화 프레임워크 'Evo2'를 발표했습니다. 제안자-반영자 루프와 SFT 및 인터리브드 GRPO를 결합해 SWE-bench Verified 48.3%를 달성했습니다.
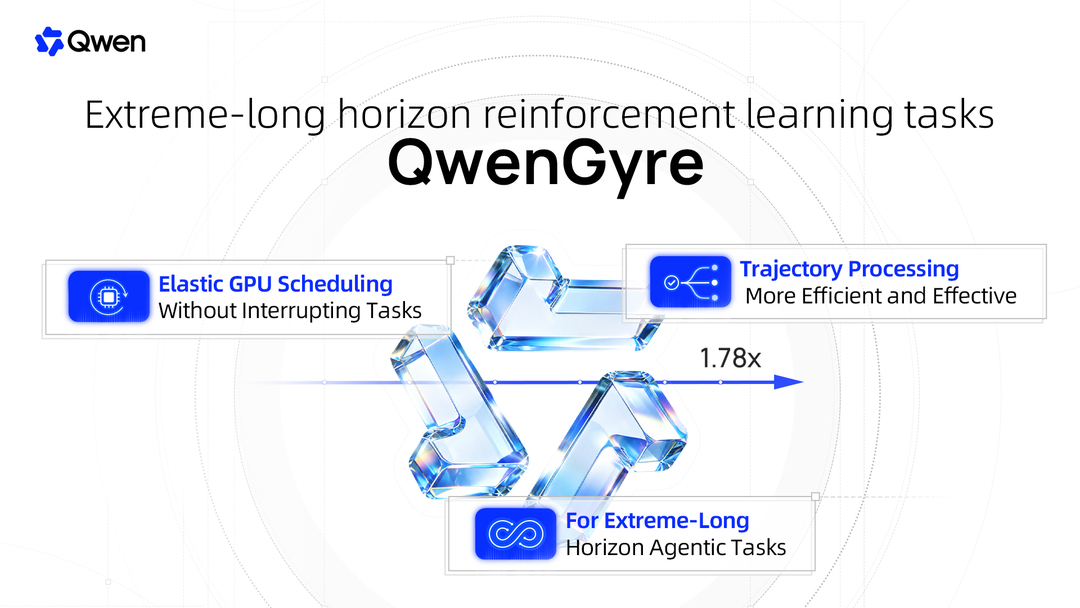
알리바바 Qwen 팀이 초장기 에이전트 강화학습을 위한 탄력적 RL 프레임워크 QwenGyre를 발표했습니다. 탄력적 GPU 스케줄러와 접두사 공유 궤적 트리로 훈련 시간을 44% 단축하고 NL2RepoBench 58.5%를 달성했습니다.
허깅페이스 CEO가 OpenAI의 수학 문제들을 오픈소스 강화학습 환경으로 패키징했다고 밝혔습니다. 초기 버전의 검증기가 원본 형식과 정확히 일치하는 증명만 인정한다는 한계도 함께 공개됐습니다.
MS 리서치의 에이전트 강화학습 프레임워크 Agent Lightning의 구조와 특징을 정리했습니다. 기존 에이전트를 거의 그대로 RL 학습에 연결하는 방식, 지원 범위, 학습 자료 위치를 확인했습니다.
Dan Kondratyuk가 2026년 10월 7일 공개한 에이전트 메타하네스 연구 주장 정리. 15M 파라미터 Craftax 에이전트의 최종 보스 승률 44%, 단일 실행 1회분으로 보이는 약 1센트·10초 주장과 OSS 그래프 DB trackinizer 기반 4,805회 실험 구조를
라미나(Laminar)가 AI 에이전트 실행 트레이스 분석 및 오류 진단에 특화된 RL 모델 'flow-1'을 공개했습니다. Signals 벤치마크에서 GPT-6-sol급 분석 성능을 내면서도 1달러당 23배 더 많은 트레이스를 처리합니다.
하네스나 학습 코드 수정 없이 Claude Code, Codex 등 10개 코딩 하네스를 강화학습 환경으로 전환하는 허깅페이스 OpenEnv 프록시와 TRL 기반 훈련 스택이 완전 오픈소스로 공개되었습니다.
오픈소스 강화학습 프레임워크 SkyRL의 Kimi K2 INT4 LoRA 예제가 공개됐습니다. 1T 파라미터 MoE 모델 Kimi-K2.7-Code를 2개 8-GPU 노드(B300)에서 262,144 토큰 풀 컨텍스트로 GRPO 방식 RL 훈련하는 레퍼런스 구성입니다.
Kevin Zakka가 공개한 오픈소스 도구 mjbatch는 C++ 스레드 풀로 Python GIL을 우회해 일반 CPU에서 수천 개의 MuJoCo 물리 시뮬레이션을 실시간 병렬 실행합니다. 상태·제어 배치 접근과 4족 보행 PPO 등 핵심 기능을 정리합니다.
Impact-Site-Verification: 9b3ebd10-6c45-44cf-a014-5b8c19b7b285