알리바바 Qwen, 극한 장기 에이전트 강화학습 프레임워크 'QwenGyre' 발표
알리바바 Qwen 팀이 초장기 에이전트 강화학습을 위한 탄력적 RL 프레임워크 QwenGyre를 발표했습니다. 탄력적 GPU 스케줄러와 접두사 공유 궤적 트리로 훈련 시간을 44% 단축하고 NL2RepoBench 58.5%를 달성했습니다.
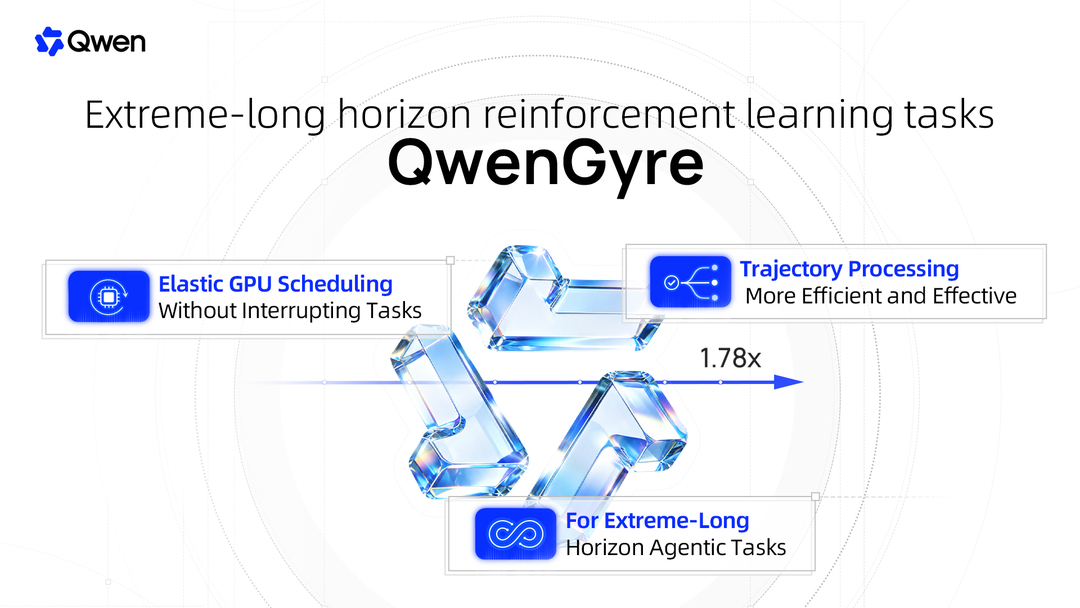
알리바바 Qwen 공식 연구팀(@Alibaba_Qwen)이 2026년 10월 12일, 극단적 장기 시계열(Extreme-Long-Horizon, XLong) 에이전트 훈련을 위한 탄력적 강화학습(Elastic RL) 시스템인 'QwenGyre'와 관련 연구 논문을 공식 발표했습니다.
이미지 출처: @Alibaba_Qwen on X
복잡한 소프트웨어 엔지니어링이나 다단계 추론 에이전트를 강화학습으로 훈련할 때, 롤아웃(rollout) 단계에서 생성되는 토큰 수가 수십만 개에 달하고 서브에이전트 호출, 컨텍스트 압축, 재시도 등으로 인해 실행 경로가 복잡하게 분기됩니다. 이 과정에서 롤아웃과 훈련(training) 간 GPU 부하 불균형과 막대한 계산 자원 낭비가 발생해 왔습니다. 알리바바 Qwen 팀은 이러한 두 가지 핵심 병목을 해결하기 위해 '탄력적 스케줄러(Elastic Scheduler)'와 '궤적 처리기(Trajectory Processor)'라는 2대 핵심 아키텍처를 제시했습니다.
탄력적 스케줄러: 롤아웃 중단 없는 GPU 동적 자원 재할당
QwenGyre의 첫 번째 핵심 축은 롤아웃과 모델 파라미터 업데이트 훈련 단계 사이에서 자원을 유연하게 전환하는 '탄력적 스케줄러(Elastic Scheduler)'입니다.
기존 분산 강화학습 파이프라인에서는 롤아웃 워커와 트레이너 노드가 고정되거나(Colocate 방식), 비동기 큐를 채우는 과정에서 유휴 자원이 생기는(Async 방식) 비효율이 빈번했습니다. QwenGyre는 실시간 부하 변동에 맞춰 GPU 풀을 롤아웃과 훈련 간에 동적으로 재할당합니다.
- 무중단 실행 보장: 자원 재할당 과정에서도 현재 실행 중인 에이전트의 라이브 롤아웃을 강제로 중단하거나 폐기하지 않고 매끄럽게 인계합니다.
- 처리 속도 대폭 개선: 알리바바 연구팀의 측정 결과에 따르면, 자원을 함께 배치하는 기존 Colocate 방식 대비 최대 1.85배, 표준 Async 방식 대비 최대 1.78배의 종단간 속도 향상을 기록했습니다.
궤적 처리기: 분기형 실행의 접두사 공유 트리화와 부분 진행도 평가
두 번째 축인 '궤적 처리기(Trajectory Processor)'는 장기 에이전트 실행에서 필연적으로 발생하는 비선형적 경로와 데이터 비효율을 정제하는 역할을 담당합니다.
실제 에이전트 환경에서는 재시도(retries), 컨텍스트 압축(compaction), 서브에이전트(sub-agents) 생성 등으로 인해 수많은 분기 궤적이 생성됩니다. QwenGyre는 이를 무작위로 평탄화해 저장하는 대신, 구조화된 트리 형태로 변환합니다.
- 접두사 공유 궤적 트리(Prefix-shared Trajectory Trees): 공통 실행 접두사를 공유하는 트리 구조로 궤적을 묶어, 중복 샘플을 제거하고 훈련 샘플의 상한 경계(bounded)를 설정합니다. 이를 통해 불필요한 중복 역전파 계산을 차단합니다.
- 타임아웃 발생 후 부분 진행도 점수화: 장기 시계열 태스크에서 타임아웃으로 최종 성공에 도달하지 못한 경우라도, 에이전트가 완료한 중간 단계의 진행도를 판정해 부분 점수를 부여함으로써 신호 희소성 문제를 완화합니다.
Qwen3.8-2.4T-A95B 확장 실험 결과와 적용 한계
알리바바 연구팀은 Qwen3.8-2.4T-A95B 모델을 기반으로 롤아웃당 약 70만 토큰 규모의 초장기 에이전트 작업에 QwenGyre를 적용한 실증 결과를 공개했습니다.
- NL2RepoBench 58.5% 달성: 코드 저장소 단위의 복합 과제 벤치마크인 NL2RepoBench에서 불과 48단계(steps) 만에 기존 52.5%에서 58.5%로 성능을 끌어올렸습니다.
- 훈련 시간 44% 절감: 비동기(Async) 훈련 기준 대비 종단간(End-to-End) 총 훈련 시간을 약 44% 단축하여 대규모 장기 에이전트 훈련 비용을 크게 낮췄습니다.
다만 도입을 검토할 때 유의해야 할 지점도 명확합니다. 알리바바 발표문에는 연구 논문 링크가 포함되어 있으나, 소스 코드 저장소의 오픈소스 공개 여부 및 라이선스는 이번 발표에서 명시되지 않았습니다. 아울러 논문에서 제시된 가속 배율(최대 1.85배·1.78배)과 44%의 훈련 시간 단축 수치는 에이전트의 분기 빈도 및 롤아웃과 훈련 단계 간 부하 편차 패턴에 따라 달라질 수 있습니다.
출처
- Alibaba Qwen 공식 X (@Alibaba_Qwen): QwenGyre 공식 발표 및 연구 논문 안내