구글 딥마인드, 에이전트 하네스와 가중치를 공진화하는 'Evo2' 프레임워크 공개
구글 딥마인드가 에이전트 실행 환경(하네스)과 모델 가중치를 함께 진화시키는 공진화 프레임워크 'Evo2'를 발표했습니다. 제안자-반영자 루프와 SFT 및 인터리브드 GRPO를 결합해 SWE-bench Verified 48.3%를 달성했습니다.
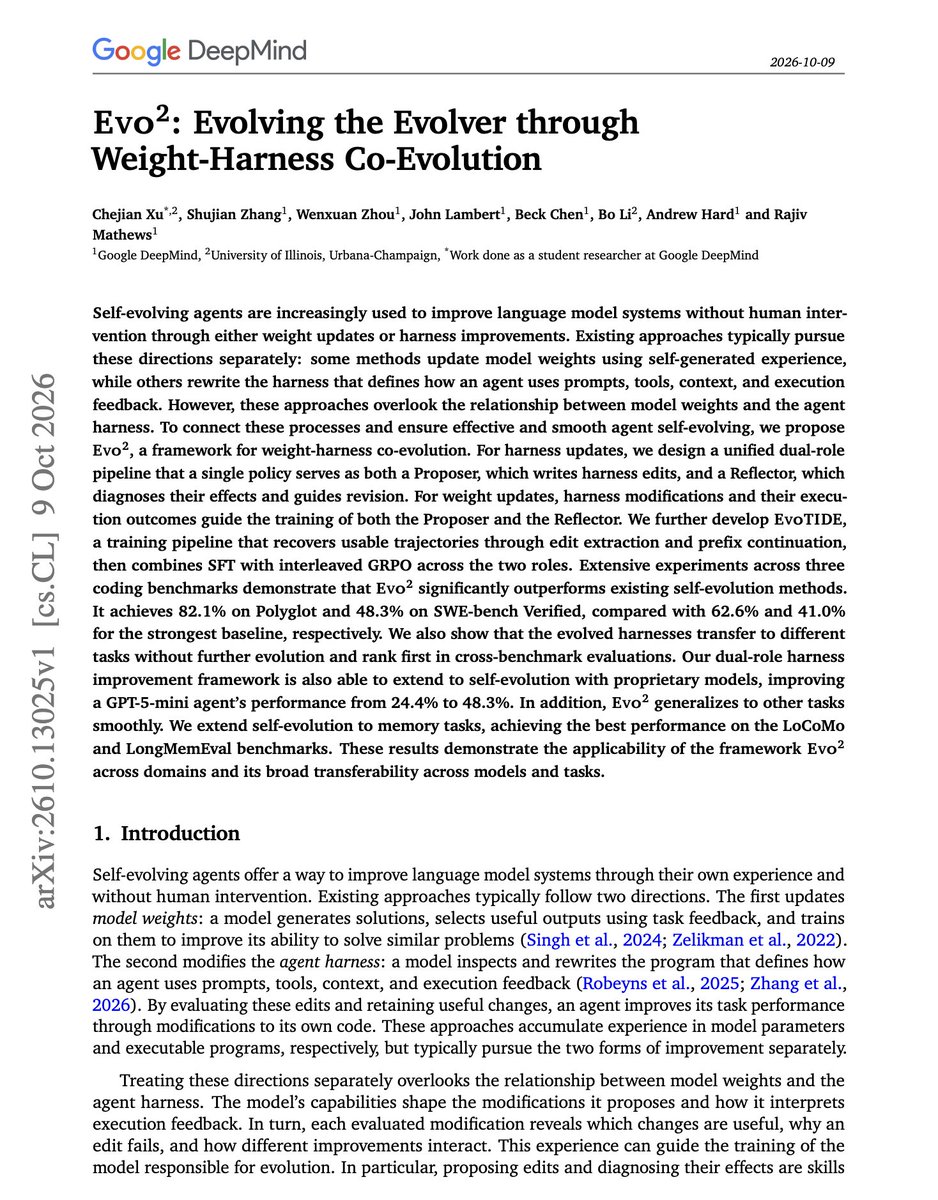
구글 딥마인드(Google DeepMind) 연구진이 2026년 10월 13일, 인공지능(AI) 코딩 에이전트의 실행 환경(하네스) 수정 기록을 모델의 사후 학습 데이터로 순환시켜 하네스와 가중치를 동시에 진화시키는 공진화(co-evolution) 프레임워크 'Evo2' 연구를 공개했습니다.
이미지 출처: @omarsar0 (via X) / Google DeepMind
기존 AI 에이전트 개발은 사람이 작성한 프롬프트 및 도구 래퍼(하네스) 환경에 고정된 모델 가중치를 결합하거나, 고정된 실행 프레임워크 안에서 모델 파인튜닝만을 반복하는 단방향 접근에 머물러 있었습니다. 이번에 공개된 Evo2는 단일 정책이 스스로 실행 환경 코드를 수정하고 그 실행 결과를 반성적으로 진단하는 피드백 루프를 구축해, 에이전트 하네스와 모델 가중치가 상호 보완적으로 성장하는 체계를 실증했습니다.
제안자·반영자 역할 분리와 SFT·인터리브드 GRPO 학습 파이프라인
Evo2의 핵심 아키텍처는 단일 정책(Policy)이 두 가지 상호 보완적 역할을 수행하며 자체 수정 로그를 생성하고 학습하는 메커니즘입니다.
- 제안자(Proposer) 역할: 에이전트가 실행되는 런타임 하네스 코드의 구체적인 수정안(diff)을 작성합니다.
- 반영자(Reflector) 역할: 하네스 수정안을 적용한 후 발생한 실행 결과와 에러, 벤치마크 평가 변화를 분석해 각 수정이 무엇을 변화시켰는지 인과적으로 진단합니다.
이렇게 축적된 하네스 수정안과 진단 결과는 다음 단계 학습을 위한 데이터셋으로 변환됩니다. Evo2는 지도학습(SFT)으로 기본 수정·진단 패턴을 학습한 뒤, 인터리브드 GRPO(Interleaved Group Relative Policy Optimization) 강화학습을 통해 성공적인 하네스 변형 패턴과 정확한 진단 정책을 최적화합니다.
특히 실제 작업을 수행하는 작업자 모델 가중치는 동결(frozen) 상태로 유지하면서 하네스를 수정·평가하는 메타 정책만을 집중 훈련할 수 있어, 폐쇄형 상용 모델을 다루는 환경에서도 비용 효율적인 최적화가 가능합니다.
SWE-bench Verified 48.3% 달성과 폐쇄형 모델 전이 효과
Evo2 연구진이 제시한 벤치마크 평가 결과에 따르면, 공진화 파이프라인은 코딩 에이전트 성능을 의미 있는 수준으로 끌어올렸습니다.
- SWE-bench Verified: Evo2는 48.3% 해결률을 기록해 기존의 강력한 베이스라인(41.0%) 대비 7.3%p 향상된 성과를 입증했습니다.
- Polyglot 벤치마크: 다국어 코드 평가인 Polyglot에서 82.1%를 달성하며 베이스라인(62.6%) 대비 큰 폭의 개선을 달성했습니다.
- 폐쇄형 모델 전이(Harness Transfer): 모델 가중치를 직접 재학습할 수 없는 상용 폐쇄형 모델 환경에서도 진화된 하네스는 뚜렷한 효과를 나타냈습니다. SWE-bench Verified 60개 태스크 서브셋 평가에서 GPT-5-mini 기반 에이전트에 진화된 하네스를 결합한 결과, 기존 최고 베이스라인(SICA, 24.4%) 대비 약 2배에 달하는 48.3% 성공률(상위 2개 하네스 중 최우수 결과 기준)을 기록했습니다.
또한 한 벤치마크에서 진화된 하네스 코드가 다른 성격의 평가 태스크로도 일반화되어 전이된다는 점이 확인되었습니다.
모델군별 성능 편차와 구조화된 로깅 인프라의 필요성
연구진의 실험 데이터와 커뮤니티의 기술적 분석은 하네스 공진화 프레임워크의 실전 적용 시 고려해야 할 현실적 한계와 필수 조건도 명확히 짚고 있습니다.
- 모델군에 따른 개선 폭 차이: 논문(Table 3) 분석에 따르면, GPT-5-mini에서 나타난 급격한 성능 도약과 달리 Haiku 4.5 환경에서는 베이스라인 45.0% 대비 하네스 진화 후 47.8%로 개선 폭이 2.8%p 수준에 그쳤습니다. 이는 하네스 변경이 모델 고유의 추론 특성과 결합하는 방식에 따라 민감도 차이가 존재함을 시사합니다.
- 구조화된 로그(Structured Logging)의 중요성: 커뮤니티의 기술적 논의에서는 단순한 표준 출력(stdout) 덤프 대신, 하네스 이벤트에 고유 ID를 부여하고 파일 및 라인 단위로 추적 가능한 구조화된 로그가 갖춰져야 노이즈 없는 인과 신호를 학습 데이터로 활용할 수 있다는 점이 실전 과제로 지적되었습니다.
- 잠재적 회귀(Regression) 위험 고려: 커뮤니티 피드백에서는 특정 평가 지표를 높이기 위한 하네스 수정이 다른 작업에서 의도치 않은 기능 파손을 일으키고 이것이 모델 가중치에 영구 반영될 위험이 제기되었으며, 다각적인 검증이 수반되어야 한다는 의견이 제시되었습니다.
현재 Evo2는 학술 연구 논문 단계로 별도의 독립형 설치 패키지는 공개되지 않았으나, 일상적인 에이전트 하네스 운영 로그를 자산화해 모델 역량을 확장할 수 있는 새로운 공학적 패러다임을 제시했다는 평가를 받고 있습니다.
출처
- Elvis Saravia (@omarsar0 via X): Google DeepMind Evo2 연구 발표 안내
- Google DeepMind Research: Evo2: Weight-Harness Co-Evolution Paper