라미나, 에이전트 트레이스 오류 탐지 특화 RL 모델 'flow-1' 공개... GPT-6-sol급 분석에 비용 23배 절감
라미나(Laminar)가 AI 에이전트 실행 트레이스 분석 및 오류 진단에 특화된 RL 모델 'flow-1'을 공개했습니다. Signals 벤치마크에서 GPT-6-sol급 분석 성능을 내면서도 1달러당 23배 더 많은 트레이스를 처리합니다.
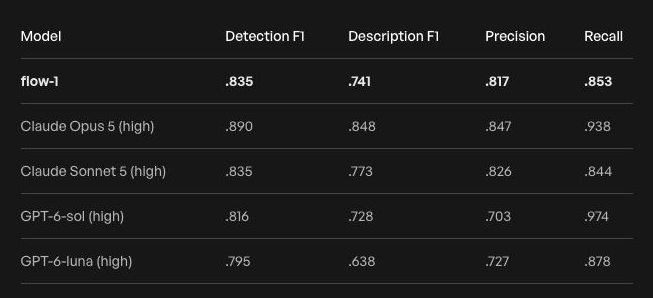
AI 관측성 및 에이전트 평가 플랫폼 라미나(Laminar)의 로버트(Robert)가 2026년 10월 5일(현지 시각), 자율형 AI 에이전트의 실행 트레이스(trace) 분석과 장애 원인 탐지에 특화된 신규 강화학습(RL) 모델인 'flow-1'을 공식 공개했습니다.
이미지 출처: @skull8888888888 (Laminar)
이번 발표는 복잡한 다단계 에이전트 워크플로우에서 발생하는 논리적 오류와 도구 호출 실패를 감시하기 위해 막대한 API 비용을 지불해야 했던 엔지니어링 병목을 정조준했습니다. 100k 토큰 이하 트레이스 환경에서 프론티어 모델인 GPT-6-sol 수준의 정밀한 결함 진단 능력을 제공하면서도 비용을 23배 대폭 낮춘 것이 핵심입니다.
에이전트 실행 트레이스 전수 감시와 비용 혁신: GPT-6-sol 대비 23배 효율
자율형 에이전트가 소프트웨어 엔지니어링, 고객지원, 법률, CRM 등 복잡한 실무 환경으로 확대되면서 수십 번의 도구 호출과 긴 문맥이 누적되는 실행 트레이스의 크기도 급격히 비대해졌습니다. 지금까지 엔지니어링 팀은 트레이스 내부의 논리 오류나 비정상 루프를 포착하기 위해 GPT-6-sol이나 GPT-6-luna 같은 고성능 범용 LLM을 평가자로 활용해 왔으나, 토큰 비용 부담으로 인해 극히 일부의 트레이스만을 무작위 표본 추출(sampling)해 검사하는 데 그쳤습니다.
라미나가 발표한 flow-1은 표본 추출 없이 프로덕션 환경의 모든 에이전트 실행 트레이스를 100% 전수 모니터링할 수 있는 경제성을 확보하는 데 초점을 맞추었습니다.
- 비용 효율성 극대화: 100k 토큰 이하의 다양한 난이도로 구성된 트레이스 실행 테스트에서 flow-1은 1달러당 처리할 수 있는 트레이스 건수가 GPT-6-sol 대비 23배에 달합니다.
- 경량 모델 대비 우위: 운영 비용 측면에서도 가성비 모델인 GPT-6-luna보다 실행 비용이 25% 더 저렴합니다.
- 실전 벤치마크 검증: 코딩, 법률 검토, 고객지원, 헬스케어 등 523개의 고난도 실제 워크플로우 트레이스로 구성된 라미나 자체 'Signals' 벤치마크에서 GPT-6-sol과 대등한 진단 품질을 입증했습니다.
라미나 측은 모델 비교 결과에서 GPT-6-sol이 더 넓은 범위의 트레이스를 결함 후보로 플래그(flag)하는 경향을 보이는 반면, flow-1은 실제 장애로 직결되는 트레이스를 가려내는 정밀도(precision) 측면에서 더욱 뛰어난 분별력을 보였다고 밝혔습니다.
시그널스 에이전트(Signals Agent) 하네스와 코드 분석형 진단 아키텍처
flow-1의 차별점은 단순한 프롬프트 주입형 분류기가 아니라, 트레이스 분석에 고도로 최적화된 전용 하네스인 '시그널스 에이전트(Signals agent)' 내부에서 구동되도록 설계되었다는 점입니다.
시그널스 에이전트 내부에서 flow-1은 마치 소프트웨어 소스코드를 디버깅하는 코딩 에이전트처럼 작동합니다.
- 저장소-파일 메타포: 전체 에이전트 실행 트레이스를 단일 코드 저장소(repo)로 취급하고, 트레이스를 구성하는 개별 스팬(span)들을 개별 파일(file)처럼 다룹니다.
- 도구 기반 능동적 조사: 전체 트레이스를 무작정 한 번에 읽는 대신, 특정 스팬 내용을 검색(grep)하고 도구 실행 결과값을 선택적으로 열람하며 장애 징후를 추적합니다.
- 정형화된 진단 반환: 사용자가 "이 트레이스에서 논리적 오류를 찾아라"와 같은 포괄적인 지시문과 요구 출력 스키마를 입력하면, 모델은 트레이스를 탐색한 뒤 스키마 규격에 맞춘 구조화된 진단 결과를 최종 반환합니다.
이를 통해 수만 토큰에 달하는 긴 트레이스 전체를 매번 컨텍스트 윈도우에 쏟아붓지 않고도, 결함이 의심되는 스팬과 도구 입출력을 핀포인트로 식별하여 분석 효율을 극대화합니다.
합성 데이터 SFT와 실전 RL 파이프라인, 그리고 도메인 특화 모델의 한계
flow-1의 훈련 과정은 도메인 특화 지능을 구축하기 위해 2단계 파이프라인으로 진행되었습니다.
첫 번째 단계에서는 소프트웨어, 법률, 고객지원, CRM 등 실제 산업군 워크플로우를 모사한 대규모 합성 조사 데이터셋을 구축하여 지도 미세조정(SFT)을 수행했습니다. 이어 두 번째 단계에서는 시그널스 에이전트 하네스 환경 안에서 강화학습(RL)을 집중적으로 적용했습니다. 이를 통해 복잡한 트레이스 탐색 과정에서의 도구 활용 능력, 출력 스키마 준수율, 그리고 다단계 원인 추적 능력을 비약적으로 끌어올렸습니다.
다만 flow-1을 도입할 때 주의해야 할 기술적 경계선도 명확합니다.
- 비범용 도메인 특화 모델: 로버트는 커뮤니티 질의에 대해 flow-1이 일반적인 대화나 복합 추론을 위한 범용 LLM이 아니며, 오직 트레이스 분석과 장애 원인 규명에 특화되어 시그널스 하네스에 결합된 모델임을 명시했습니다.
- 벤치마크 환경의 제약: 제시된 23배 비용 절감 및 품질 비교는 100k 토큰 이하 크기의 트레이스와 라미나 자체 Signals 벤치마크(523개) 환경을 기준으로 도출된 수치입니다.
라미나는 flow-1을 통해 프로덕션에서 발생하는 수많은 실패 및 성공 트레이스를 고품질 평가셋으로 자동 전환하고, 에이전트의 완성도를 높이는 데이터 피드백 루프를 구축할 수 있을 것이라고 강조했습니다.
출처
- Laminar 공식 기술 블로그: Introducing flow-1: RL for agent trace error detection
- Robert 공식 X 스레드 (@skull8888888888): flow-1 릴리즈 발표 및 벤치마크 지표