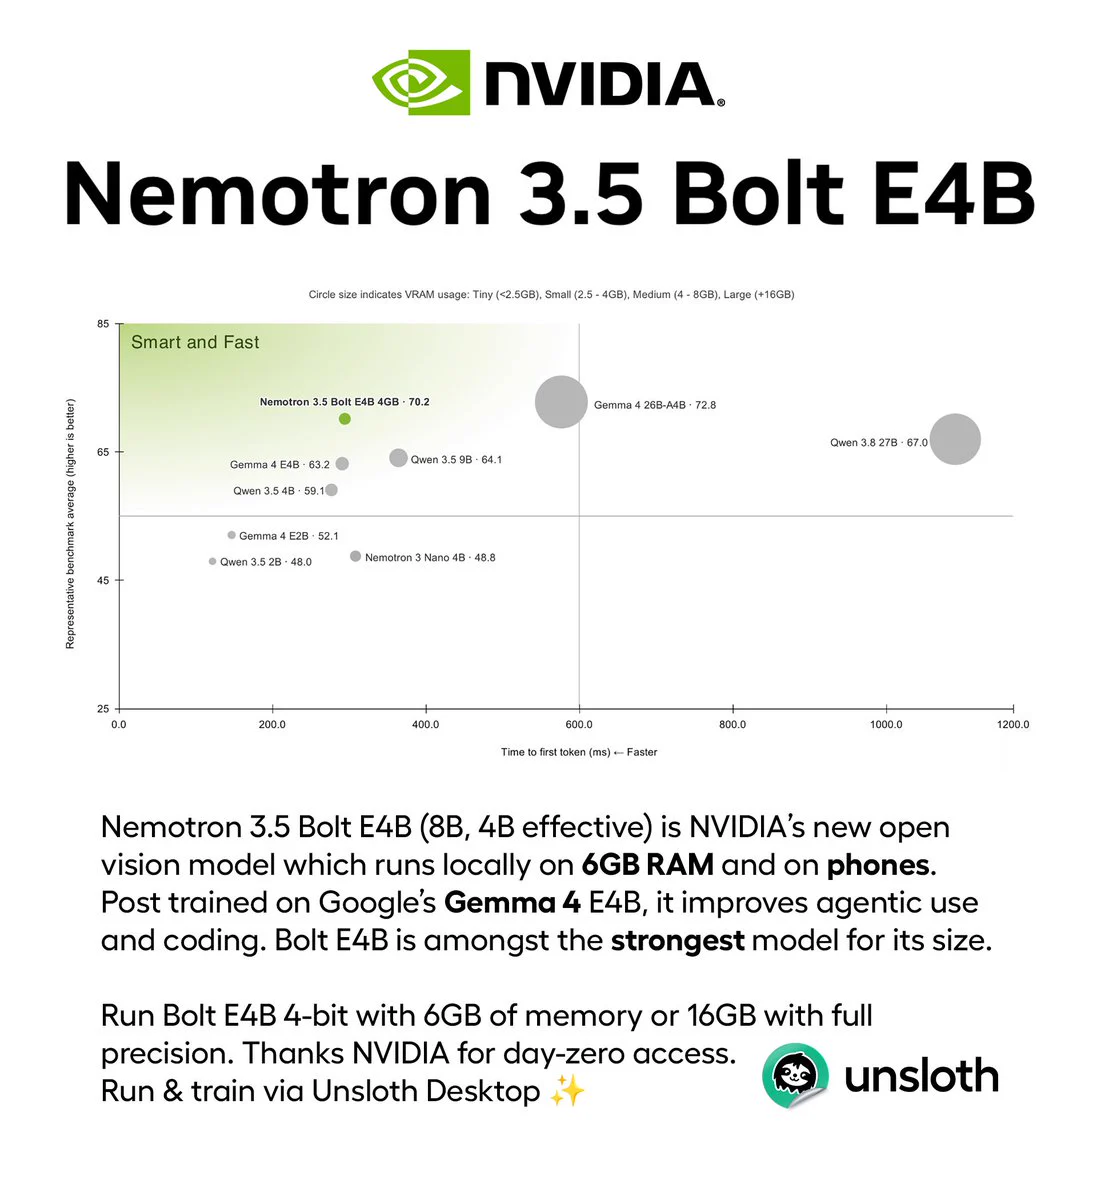
NVIDIA Nemotron 3.5 Bolt E4B 공개: 10월 23일 모델 카드와 Unsloth의 엣지 구동 안내
NVIDIA 공식 모델 카드의 10월 23일 출시·텍스트 입출력 사양과 10월 24일 Unsloth의 6GB 메모리·GGUF 소개를 각각 원문에 따라 정리했습니다.
TAU-HOME.COM에서 GGUF 태그로 묶인 글입니다.
NVIDIA 공식 모델 카드의 10월 23일 출시·텍스트 입출력 사양과 10월 24일 Unsloth의 6GB 메모리·GGUF 소개를 각각 원문에 따라 정리했습니다.
Unsloth가 Qwen3.8-27B를 위한 Dynamic 3.0 GGUF 가중치를 공개하며 6.2GB부터 22GB까지 다양한 양자화 옵션을 제시했습니다. 변경 사항과 고려할 한계를 정리합니다.
UkisAI의 추론 효율화 모델 Swift 1.5 Qwen3.8-27B를 llama.cpp용 초경량 2~3비트 GSQ-RCO GGUF로 패키징한 릴리스와 IQ3_S 16GB 실측 벤치마크 소식을 정리합니다.
Mirai S Qwen3.8-27B 2.4비트 양자화 모델이 프롬프트 1회와 후속 3회로 1,005줄 단일 HTML 3D 햄스터 시뮬레이션을 생성한 실측 데모를 정리합니다. 게이밍 카드 1장 구동 주장과 호환성 제약을 검증된 범위에서만 다룹니다.
Qwen3.8-27B를 3진(1.58-bit) 양자화해 7.3GB로 압축한 비전 언어 모델 Mitsuba와 무검열 HiMitsuba LoRA가 공개되었습니다. 단일 16GB GPU 환경의 ComfyUI에서 이미지 분석과 고속 프롬프트 작성을 지원합니다.
Aleph Alpha의 78B MoE Kolibri-1을 47.5GB Q4_K_M GGUF로 양자화하여 패치된 llama.cpp와 128GB RAM 환경에서 CPU 단독으로 초당 13~15 토큰을 기록한 로컬 구동 방식을 정리합니다.
Qwen-Image-2.1을 로컬 환경에서 프롬프트 거부 없이 구동하는 실전 팁. 7B DiT 주간은 Q4_K_M GGUF(4.68GB)로 VRAM을 절감하고, 8B 텍스트 인코더를 Heretic GGUF로 교체해 품질 저하 없이 거부율을 5%로 낮추는 ComfyUI 세팅 가이드.
PrismML의 Qwen3.8-27B 기반 3진법 압축 모델 Bonsai 2(5.95GB)의 거절 회로를 파일 크기 증가 없이 가중치 레벨에서 제거한 dealignai 팀의 CRACK 빌드가 공개되었습니다.
거부 반응이 제거된 무검열 Nex-N2.5-mini GGUF 빌드(IQ4_XS)가 공개되어 18GB VRAM 환경에서 로컬 구동이 가능해졌습니다. 35B MoE(3.5B 활성), 262K 컨텍스트, 비전 및 llama.cpp 에이전틱 코딩 지원 사양과 활용 팁을 정리합니다.
Impact-Site-Verification: 9b3ebd10-6c45-44cf-a014-5b8c19b7b285