Mitsuba & HiMitsuba 27B GGUF: 16GB GPU에서 구동하는 ComfyUI 전용 1.58비트 비전 프롬프트 생성 모델
Qwen3.8-27B를 3진(1.58-bit) 양자화해 7.3GB로 압축한 비전 언어 모델 Mitsuba와 무검열 HiMitsuba LoRA가 공개되었습니다. 단일 16GB GPU 환경의 ComfyUI에서 이미지 분석과 고속 프롬프트 작성을 지원합니다.
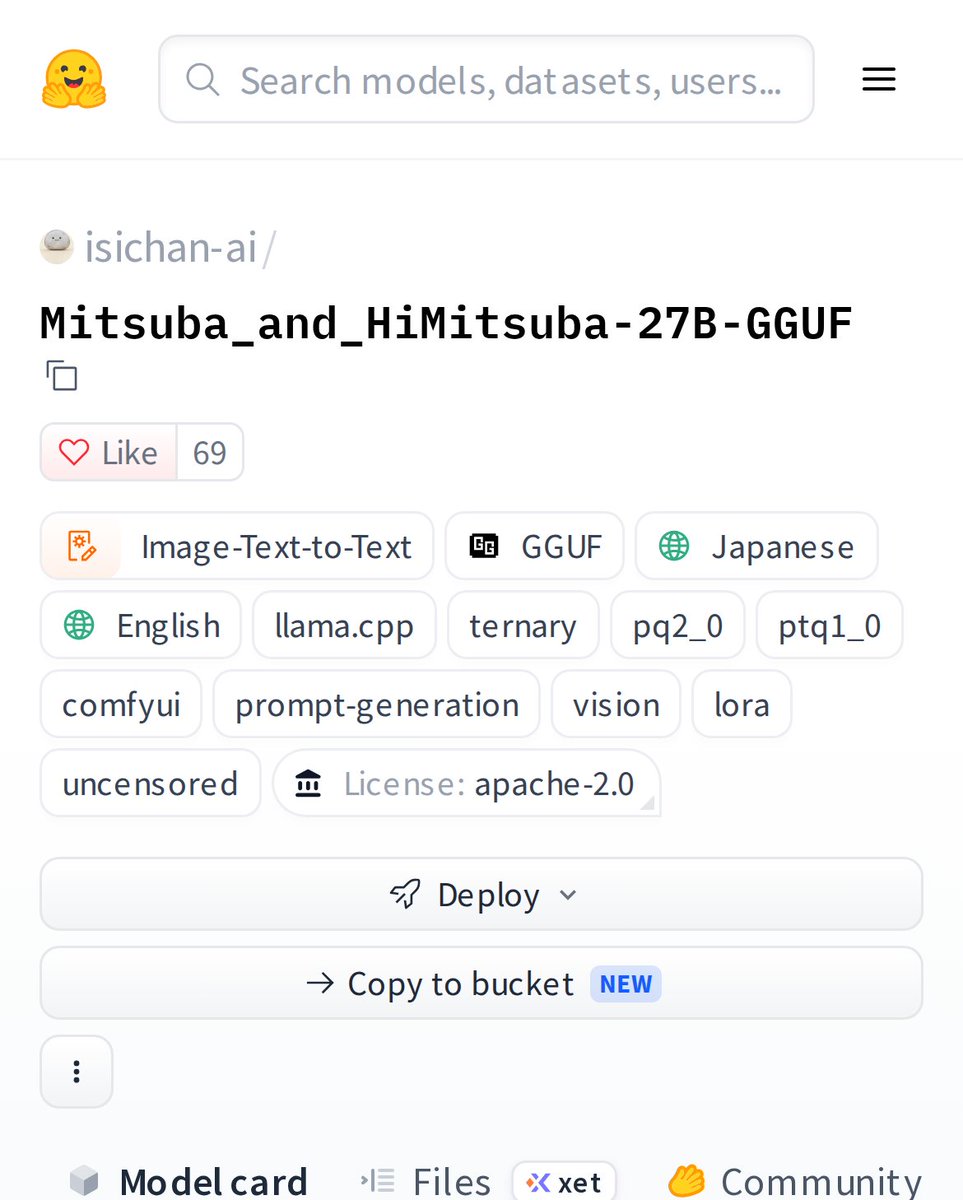
오픈소스 AI 개발자 이시찬(isichan-ai)이 대형 비전 언어 모델 Qwen3.8-27B를 1.58비트(3진, ternary) 양자화 기법으로 압축해 단일 16GB VRAM 그래픽카드에서 구동할 수 있도록 최적화한 'Mitsuba & HiMitsuba 27B GGUF' 모델 패키지를 공개했습니다.
이미지 출처: @HuggingModels
이번 릴리즈는 생성형 이미지 및 비디오 제작 도구인 ComfyUI 환경에서 입력 이미지를 정밀 분석하고, 하류(downstream) 생성 모델을 위한 엄격한 조건의 프롬프트를 작성하는 전용 로컬 비전 언어 모델(VLM)입니다. 2026년 10월 4일 저장소명이 기존 Mitsuba-ComfyUI-27B-GGUF에서 공식 변경되면서, 과도한 안전성 거부 반응을 해소하는 무검열 HiMitsuba LoRA 가중치가 함께 통합되었습니다.
1.58비트 3진 양자화와 단일 16GB GPU 로컬 구동 아키텍처
Mitsuba 27B의 핵심 기술적 성과는 고성능 270억(27B) 파라미터 기반 비전 모델을 3진 양자화(Ternary Quantization)를 통해 일반 소비자용 단일 GPU VRAM 예산 내로 압축해 냈다는 점입니다.
- PQ2_0 포맷 (7.32GB): 실측 가중치 크기 7.32GB로, 16GB VRAM 환경에 완전히 상주하며 지연 시간 없이 고속 추론을 제공합니다.
- PTQ1_0 포맷 (6.00GB): 추가 압축을 적용해 약 5.998GB 크기를 기록하며 VRAM 여유가 극도로 부족한 환경을 지원합니다.
- 독립 비전 프로젝터 필수: 비전 입력을 정상적으로 디코딩하기 위해 0.63GB 크기의 별도 멀티모달 프로젝터 파일(
mmproj-Q8_0.gguf)을 함께 로드해야 합니다. - 고속 디코딩 속도: 최신 RTX 5090 환경 실측 기준, PQ2_0 단독 구동 시 초당 약 119토큰(tokens/s)의 디코딩 속도를 기록했습니다.
3진 양자화 적용에도 불구하고 비전 벤치마크 점수는 원본 대비 소폭 하락(89.8에서 87.8)에 그쳤으며, 오히려 생성 프롬프트의 지시문 준수율은 양자화 이전보다 개선되는 성능 보존력을 입증했습니다.
ComfyUI 이미지 분석 특화와 코딩 능력 배제 설계
Mitsuba는 범용 다목적 모델이 아닌, ComfyUI 및 Krea 2와 같은 AI 아트 파이프라인의 프롬프트 역공학(reverse engineering)과 캡셔닝 작업에 철저히 초점을 맞춰 튜닝되었습니다.
- 이미지 분석 및 프롬프트 생성: 참조 이미지를 전달받으면 대상의 피사체, 조명, 구도, 질감, 스타일을 분석하고 시스템 프롬프트의 제약 조건에 맞춘 정교한 프롬프트를 생성합니다.
- 비디오 생성용 모션 캡션 작성: 단일 프레임 정지화뿐 아니라 영상 생성 워크플로우에 필요한 연속성 묘사 문장을 구조화된 텍스트로 출력합니다.
- 일반 코딩 목적 사용 금지: 모델의 어텐션과 가중치가 시각 묘사 및 프롬프트 문법에 집중 조율되면서, 일반 프로그래밍 코딩 점수는 4/100 수준으로 급감했습니다. 소프트웨어 개발이나 스크립트 작성에는 사용하지 않아야 합니다.
무검열 HiMitsuba LoRA 결합과 거부율 대폭 완화
함께 배포된 HiMitsuba-Uncensored-LoRA.gguf(0.07GB)는 기본 모델이 예술적 묘사나 성인용 콘텐츠(NSFW) 작업 시 겪는 검열 및 거부 반응을 해소하기 위한 어댑터입니다.
- 거부 반응 감소: 106개 테스트 질의 기준, 단순 거부 응답이 기존 51회에서 7회로 급감했습니다.
- 회피(Evasion) 완화: 답변을 시작했으나 핵심 묘사를 누락하는 회피율이 기존 73%에서 32%로 낮아졌으며, 거부와 회피를 합친 전체 실패율은 59건에서 13건으로 축소되었습니다.
- 무검열 점수 대폭 향상: 무검열 벤치마크 점수가 53.2점에서 89.6점으로 크게 상승했습니다.
- 규칙 준수율 향상: 시스템 조건에 맞춰 프롬프트를 작성하는 성공률은 6/10에서 8/10으로 오히려 개선되었습니다.
- PQ2_0 전용 호환성 제약: HiMitsuba LoRA는 7.32GB 크기의 PQ2_0 빌드 전용으로 제작되었으며, 초압축 PTQ1_0 빌드와의 결합은 보장되지 않습니다.
- 성능 트레이드오프: 런타임에 LoRA 연산이 병합 적용됨에 따라 RTX 5090 기준 추론 속도가 약 119 t/s에서 약 103.1 t/s로 미세하게 감소하며, 외부 도구 에러 발생 시 재시도하지 않고 첫 회에 중단하는 특성(자제력 점수 62.7 → 48.2)이 나타납니다.
PrismML llama.cpp 포크 환경과 사고 모드 비활성화 필수 수칙
Mitsuba 27B는 독자적인 1.58비트 양자화 구조를 사용하므로 런타임 환경 구성 시 반드시 지켜야 할 기술적 주의사항이 존재합니다.
- PrismML llama.cpp 포크 사용 필수: 공식 상류(upstream) llama.cpp는 아직 PQ2_0 및 PTQ1_0 포맷을 지원하지 않으므로, PrismML 포크의
prism브랜치를 빌드해 실행해야 합니다. - 사고(Reasoning) 모드 완전 비활성화: 이 모델은 순수 텍스트 생성 경로로만 튜닝되었습니다. 추론 시 사고 모드가 켜져 있으면 모델이 내부 생각 루프에서 동일한 문장을 무한 반복하며 최종 답변을 출력하지 못하는 치명적인 버그가 발생합니다.
- CLI 환경:
--reasoning off옵션 필수 지정 - API 환경:
"chat_template_kwargs": {"enable_thinking": false}매개변수 필수 전달
- CLI 환경:
공식 평가 검증에 사용된 표준 서버 기동 명령은 다음과 같습니다.
llama-server -m Mitsuba-ComfyUI-27B-v1.18-PQ2_0.gguf \
  --mmproj mmproj-Q8_0.gguf \
  --no-mmproj-offload \
  --reasoning off \
  --jinja \
  --temperature 0.6 \
  --top-k 20 \
  --top-p 0.95 \
  --ctx-size 131072 \
  --cache-type-k q4_0 \
  --cache-type-v q4_0 \
  --n-gpu-layers 99
단일 16GB GPU 환경에서 고성능 비전 역공학 엔진을 독립적으로 구축하고자 하는 ComfyUI 아티스트와 개발자에게 매우 유용한 실전 도구입니다.
출처
- Hugging Face 저장소: isichan-ai/Mitsuba_and_HiMitsuba-27B-GGUF
- Hugging Models 안내 포스트 (@HuggingModels): 2106826442864775593