NVIDIA Nemotron 3.5 Bolt E4B 공개: 10월 23일 모델 카드와 Unsloth의 엣지 구동 안내
NVIDIA 공식 모델 카드의 10월 23일 출시·텍스트 입출력 사양과 10월 24일 Unsloth의 6GB 메모리·GGUF 소개를 각각 원문에 따라 정리했습니다.
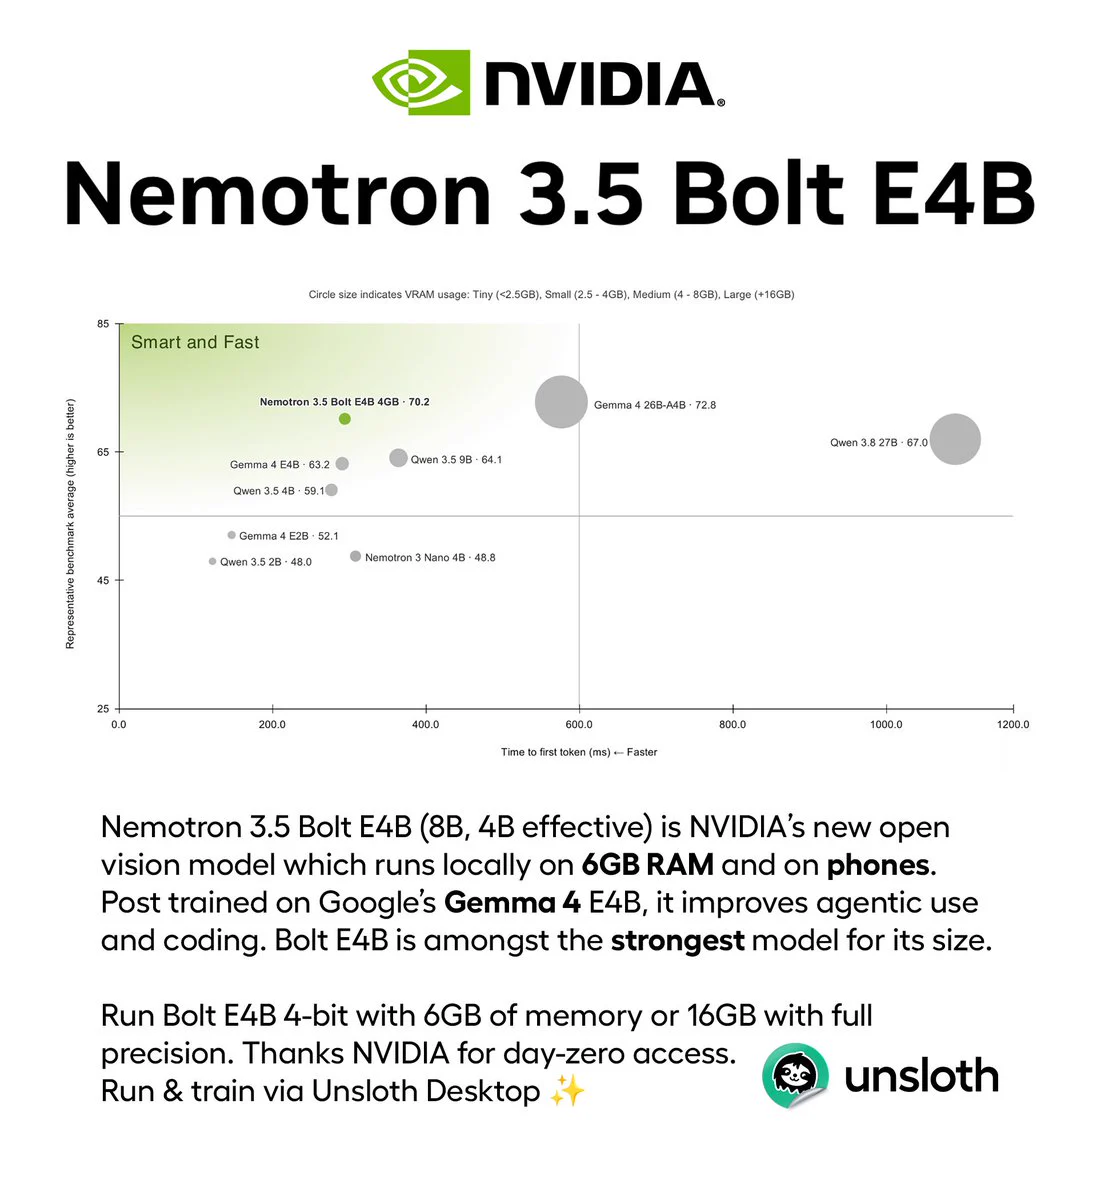
NVIDIA가 Nemotron 3.5 Bolt E4B 모델을 소개했다. 공식 모델 카드에는 NVIDIA Build와 Hugging Face 배포 날짜가 2026년 10월 23일로 기록되어 있다. 다음 날인 10월 24일에는 Unsloth AI가 X를 통해 모델의 엣지 기기 활용과 GGUF 배포 자료를 별도로 소개했다. 두 날짜는 서로 다른 발표의 날짜다.
이미지 출처: @UnslothAI
NVIDIA가 명시한 모델과 입출력 사양
NVIDIA 모델 카드가 다루는 대상은 Nemotron-3.5-Bolt-E4B-BF16이다. NVIDIA는 이 모델을 Gemma-4-E4B-it에서 추가 사후학습한 범용 추론 및 대화용 언어 모델이라고 설명한다. 카드에는 총 80억 개의 매개변수, 그중 40억 개의 유효 매개변수라는 구조가 명시되어 있다.
같은 공식 카드의 서비스 엔드포인트 규격은 입력: Text, 출력: Text로 적혀 있으며, 최대 문맥 길이는 64K 토큰으로 안내한다. 따라서 이 모델 카드만을 근거로 해당 BF16 엔드포인트의 이미지 입력 기능이 제공된다고 소개할 수는 없다. 비전 기능을 언급할 때는 어느 배포 버전과 실행 환경에 대한 설명인지 함께 살펴야 한다.
Unsloth가 소개한 6GB 구동과 GGUF
Unsloth AI의 10월 24일 게시물은 Bolt E4B가 6GB RAM의 로컬 환경과 휴대전화 같은 엣지 기기에서 실행될 수 있다고 소개했다. 또한 Gemma 4 기반과 비전 지원을 언급했다. 비전 지원은 여기에서 Unsloth의 소개 내용이며, 위의 NVIDIA BF16 서비스 엔드포인트가 이미지 입력을 받는다는 뜻으로 옮겨 해석하지 않았다.
개발자가 확인할 수 있도록 Unsloth는 GGUF 모델 배포 페이지와 모델 실행 가이드를 연결했다. 6GB 구동이라는 설명도 이 양자화 및 로컬 사용 문맥에 속한다. NVIDIA의 BF16 배포에 동일한 메모리 사용량을 그대로 적용하는 것은 적절하지 않다.
로컬 실행 전 확인할 점
모델을 선택할 때는 먼저 다운로드하려는 BF16 원본 또는 GGUF 양자화 버전을 확인하고, 실제 사용할 실행 프로그램이 요구하는 입력 형식과 메모리를 살펴보는 편이 좋다. NVIDIA의 모델 카드와 Unsloth의 안내는 모델 계열을 설명하면서도 서비스 엔드포인트와 로컬 구동이라는 서로 다른 환경을 다룬다.
공식 공개 날짜, 모델 구조, 텍스트 입출력 사양은 NVIDIA 카드에서, 6GB 엣지 구동 및 비전 소개는 Unsloth 게시물에서 각각 확인할 수 있다. 두 자료를 함께 읽으면 발표 시점과 실제 배포 구성에서 생길 수 있는 혼동을 줄일 수 있다.