VoiceStudio: ElevenLabs 대체하는 오픈소스 로컬 음성 AI 스튜디오 (646개 언어·16개 TTS 엔진)
외부 클라우드와 API 요금 없이 로컬 PC에서 646개 언어와 16개 TTS 엔진을 구동하는 오픈소스 음성 AI 도구 VoiceStudio의 핵심 기능, 워크플로우 및 라이선스 고려사항.
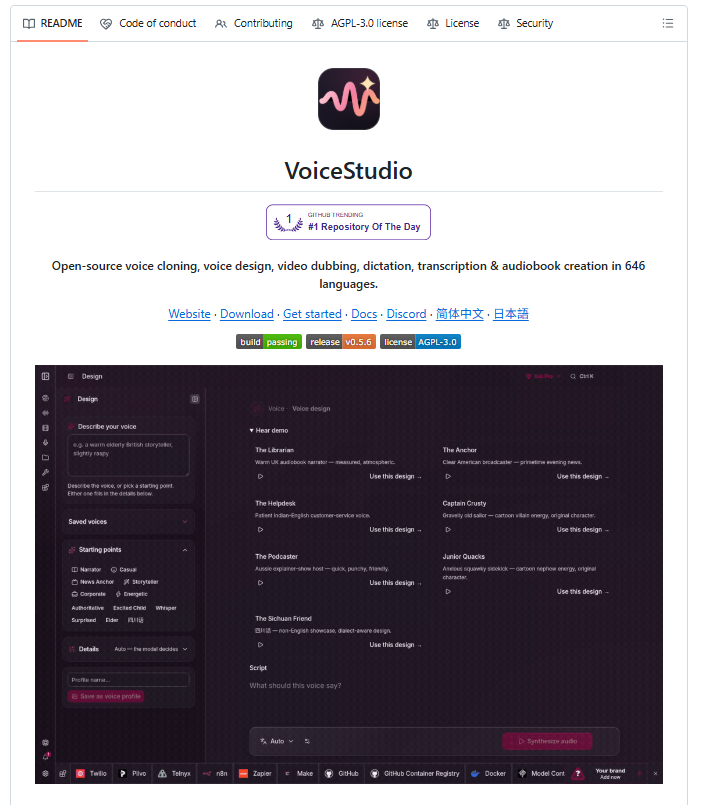
상용 클라우드 음성 합성 서비스에 대한 의존도를 낮추고 사용자 로컬 하드웨어에서 음성 생성 파이프라인 전체를 구동할 수 있는 오픈소스 데스크톱 도구 'VoiceStudio(구 OmniVoice-Studio)'가 깃허브(GitHub)와 AI 엔지니어 커뮤니티에서 주목받고 있습니다. 개발자 debpalash가 AGPL-3.0 라이선스로 공개한 VoiceStudio는 외부 API 호출이나 문자당 과금 없이, 646개 언어 카탈로그와 16개 TTS 엔진을 단일 데스크톱 인터페이스에 통합하여 제로샷 음성 복제, 영상 더빙, 실시간 받아쓰기 워크플로우를 제공합니다.
이미지 출처: @josesilesdata / GitHub debpalash/VoiceStudio
기존 상용 음성 플랫폼들이 수십 종의 언어 지원과 월 구독료 기반의 사용량 계량기(usage meter)를 적용하는 것과 달리, VoiceStudio는 오디오 데이터가 사용자의 로컬 컴퓨터 밖으로 유출되지 않는 '로컬 우선(Local-first)' 아키텍처를 표방합니다. 음성 복제부터 장편 오디오북 제작, 비디오 타임코드 동기화 더빙까지 크리에이터와 개발자가 필요로 하는 음성 AI 작업 전반을 개인 워크스테이션에서 완결할 수 있도록 설계되었습니다.
646개 언어와 16개 TTS·11개 ASR 엔진을 통합한 로컬 음성 워크벤치
VoiceStudio의 기술적 핵심은 개별 프로젝트로 흩어져 있던 다양한 오픈소스 음성 모델을 하나의 통합 데스크톱 애플리케이션으로 묶어낸 점입니다.
- 16개 TTS 엔진 및 11개 ASR 엔진 내장: 단일 엔진에 종속되지 않고, 작업 목적과 하드웨어 사양에 맞춰 다양한 텍스트 음성 변환(TTS) 및 자동 음성 인식(ASR) 백엔드를 유연하게 선택할 수 있습니다.
- 646개 언어 카탈로그: 상용 클라우드 서비스가 통상 30여 개 주요 언어에 집중하는 반면, 방대한 다국어 모델 라이브러리를 통합하여 소수 언어 및 지역 방언 작업까지 포괄합니다.
- 완전 로컬 구동 및 프라이버시 보호: 계정 생성, API 키 등록, 네트워크 연결 없이 구동되며, 사용자의 음성 샘플과 생성된 결과물이 외부 서버로 전송되지 않습니다.
- 크로스 플랫폼 지원: macOS, Windows, Linux 데스크톱 환경을 공식 지원하여 다양한 운영체제에서 동일한 워크플로우를 구축할 수 있습니다.
음성 복제부터 비디오 더빙·오디오북까지: 5대 핵심 워크플로우
VoiceStudio는 단순한 텍스트 낭독기를 넘어, 실제 콘텐츠 제작 현장에서 요구되는 5가지 주요 워크플로우를 완결형 UI로 제공합니다.
- 제로샷 음성 복제(Voice Cloning): 3초에서 15초 분량의 깨끗한 참조 오디오 클립만 입력하면, 추가 모델 훈련 없이 대상 화자의 음색과 억양을 실시간으로 복제하여 새로운 텍스트를 발화합니다.
- 파라메트릭 음성 디자인(Voice Design): 기존 음성을 복제하는 것에 그치지 않고 나이, 억양, 피치, 감정 표현, 발화 스타일 등의 속성 파라미터를 조합해 가상의 독창적인 인공지능 보이스를 합성할 수 있습니다.
- 타임코드 동기화 비디오 더빙(Video Dubbing): 원본 영상의 오디오를 전사(ASR)하고 다국어로 번역한 뒤, 원본 화자의 특징을 보존한 다국어 음성을 타이밍에 맞춰 재합성하여 완성된 비디오로 바로 내보냅니다.
- 글로벌 핫키 기반 실시간 받아쓰기(Dictation): 플로팅 위젯과 시스템 전역 단축키를 통해 어떤 앱에서든 마이크 음성을 즉시 텍스트로 변환하며, 로컬 LLM을 통한 맞춤 윤문 및 교정 파이프라인을 연결할 수 있습니다.
- 다중 화자 오디오북 및 배치 생성: 긴 호흡의 스크립트에서 여러 등장인물 화자를 배정하고, 장편 텍스트(EPUB/PDF)를 챕터별로 렌더링하여 표준 오디오북 포맷인
.m4b파일로 일괄 출력하는 대량 큐(Batch queue)를 운용합니다.
로컬 REST API·MCP 연동과 상업적 배포 시 라이선스 주의사항
VoiceStudio는 개발자와 AI 에이전트를 위한 로컬 엔드포인트를 기본 내장하고 있습니다.
애플리케이션을 구동하면 localhost:3900 포트에서 OpenAI 호환 오디오 REST API가 활성화되어 기존 OpenAI SDK나 클라이언트를 사용하는 프로그램의 엔드포인트를 로컬 주소로 간단히 변경할 수 있습니다. 또한 Claude Code나 에이전트 하네스 환경과 직접 통신할 수 있는 모델 컨텍스트 프로토콜(MCP) 서버 엔드포인트를 제공하여, 에이전트가 코딩 작업 도중 음성 합성이나 전사를 도구 형태로 호출하는 자동화 파이프라인 구성이 가능합니다.
다만 프로덕션 도입 시 라이선스와 하드웨어 요구사항에 대한 주의가 필요합니다.
- 기본 엔진 가중치 라이선스 구분: VoiceStudio 데스크톱 앱 자체는 AGPL-3.0 오픈소스이며 기본 엔진인
k2-fsa/OmniVoice의 코드도 Apache-2.0이지만, 기본 탑재된 OmniVoice 사전 훈련 가중치(weights)는 비상업용(CC-BY-NC) 라이선스로 배포됩니다. 따라서 상업적 프로젝트나 수익 창출 목적으로 음성을 생성할 경우, 카탈로그 내 상업적 이용이 허용된 대체 TTS 엔진으로 전환해 사용해야 합니다. - 활발한 베타(Active Beta) 단계: 현재 프로젝트는 기능 추가와 안정화가 빠르게 진행 중인 활발한 베타 단계입니다. 고품질 다국어 모델을 실시간에 가깝게 추론하려면 충분한 GPU VRAM이 요구되며, 플랫폼 환경에 따라 추가 의존성 패키지 구성이 필요할 수 있습니다.
출처
- GitHub 저장소: debpalash/VoiceStudio
- José Siles (@josesilesdata) X 포스트: 2026-10-05 VoiceStudio 릴리즈 소개
- SoloSoft 기술 분석: VoiceStudio 아키텍처 및 라이선스 감사 리포트