27B급 Qwen3.8을 16GB GPU에 넣은 Swift 1.5 GSQ-RCO GGUF 양자화 릴리스
UkisAI의 추론 효율화 모델 Swift 1.5 Qwen3.8-27B를 llama.cpp용 초경량 2~3비트 GSQ-RCO GGUF로 패키징한 릴리스와 IQ3_S 16GB 실측 벤치마크 소식을 정리합니다.
TAU-HOME.COM에서 llama.cpp 태그로 묶인 글입니다.
UkisAI의 추론 효율화 모델 Swift 1.5 Qwen3.8-27B를 llama.cpp용 초경량 2~3비트 GSQ-RCO GGUF로 패키징한 릴리스와 IQ3_S 16GB 실측 벤치마크 소식을 정리합니다.
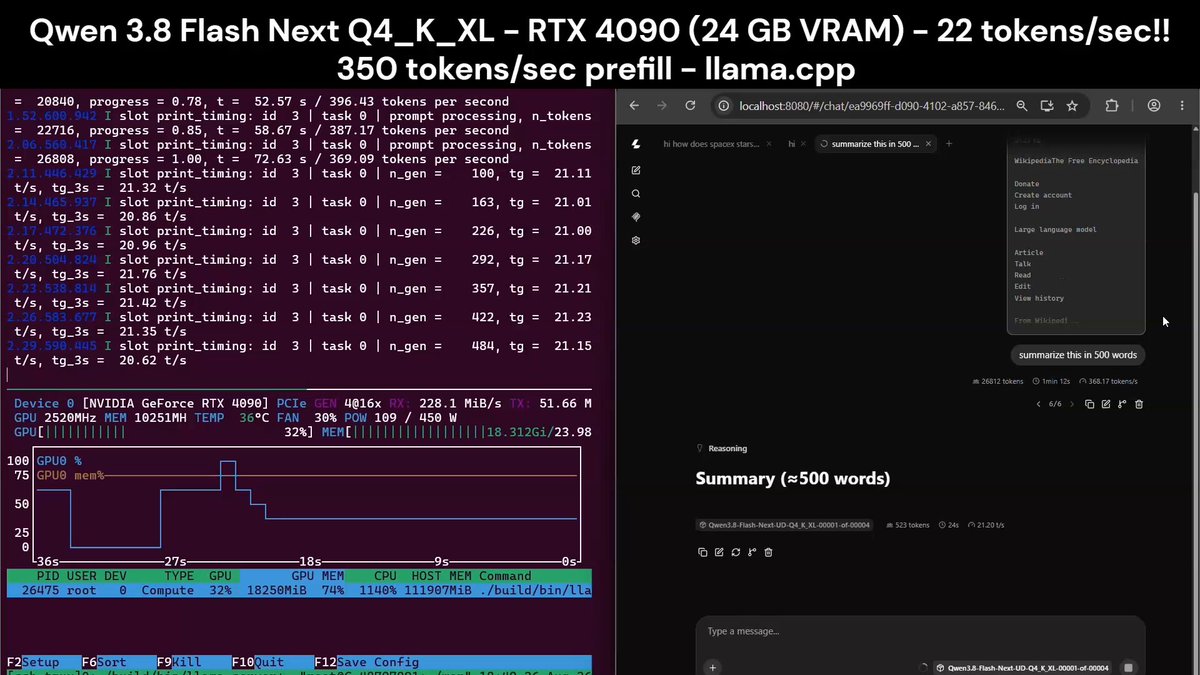
125B MoE Qwen3.8-Flash-Next를 RTX 4090 한 장과 시스템 RAM 오프로드로 구동했다는 커뮤니티 보고의 핵심 조건과 주의점을 검증했습니다.
클라우드 API 구독료 없이 개인 하드웨어에서 LLM 추론부터 이미지 생성, 음성 인식, 분산 클러스터링까지 자급자족할 수 있는 필수 오픈소스 깃허브 프로젝트 10개(llama.cpp, Jan, Ollama, ComfyUI, exo 등)를 정리합니다.
Impact-Site-Verification: 9b3ebd10-6c45-44cf-a014-5b8c19b7b285