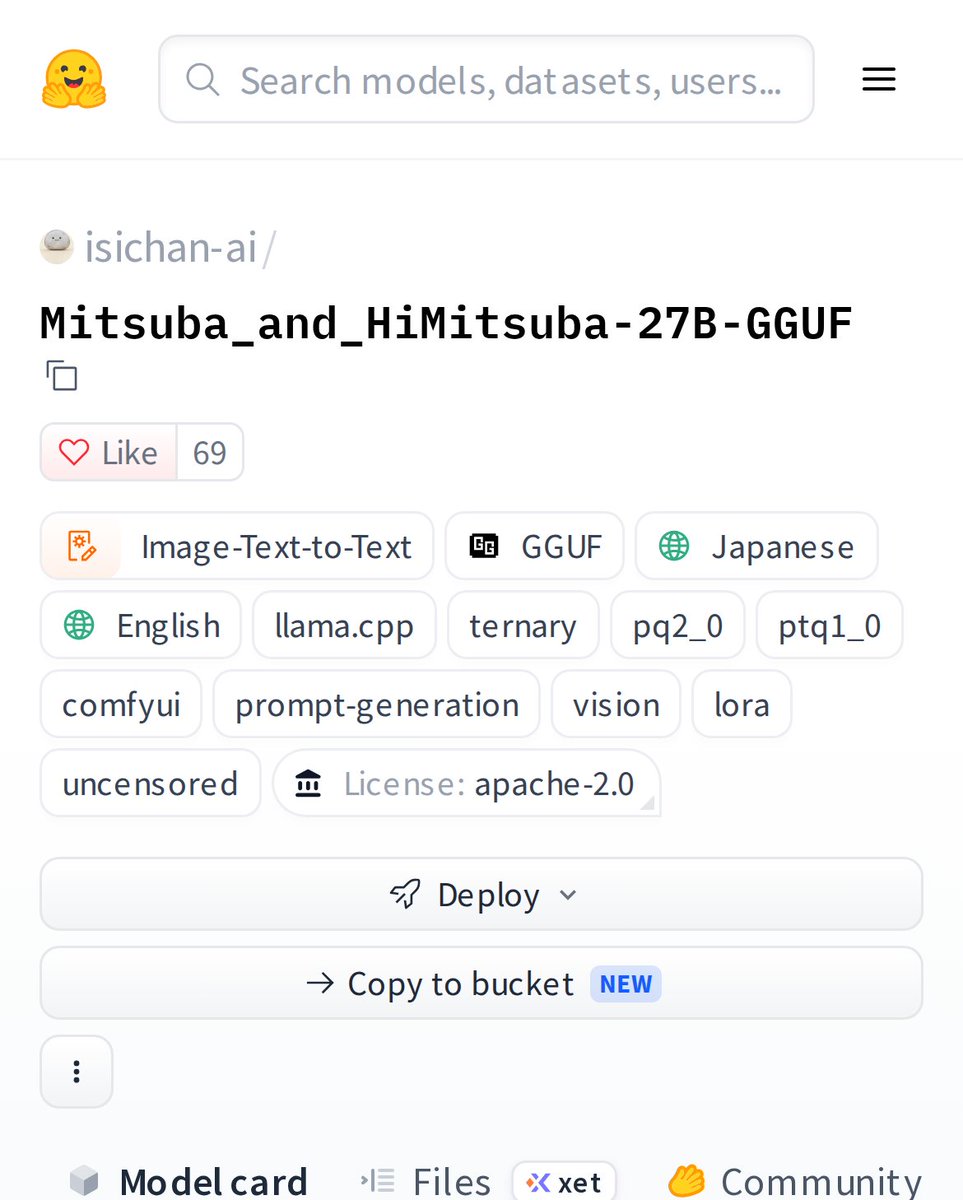
Mitsuba & HiMitsuba 27B GGUF: 16GB GPU에서 구동하는 ComfyUI 전용 1.58비트 비전 프롬프트 생성 모델
Qwen3.8-27B를 3진(1.58-bit) 양자화해 7.3GB로 압축한 비전 언어 모델 Mitsuba와 무검열 HiMitsuba LoRA가 공개되었습니다. 단일 16GB GPU 환경의 ComfyUI에서 이미지 분석과 고속 프롬프트 작성을 지원합니다.
TAU-HOME.COM에서 llamacpp 태그로 묶인 글입니다.
Qwen3.8-27B를 3진(1.58-bit) 양자화해 7.3GB로 압축한 비전 언어 모델 Mitsuba와 무검열 HiMitsuba LoRA가 공개되었습니다. 단일 16GB GPU 환경의 ComfyUI에서 이미지 분석과 고속 프롬프트 작성을 지원합니다.
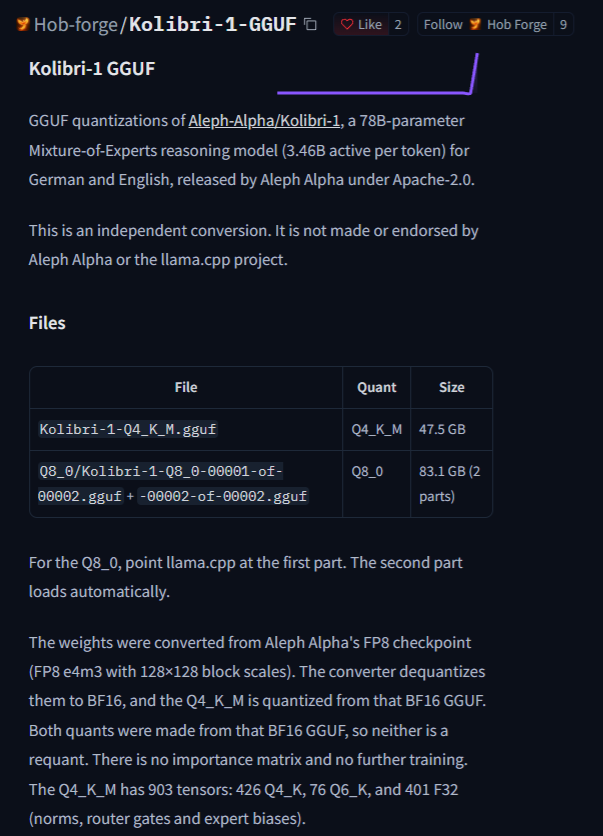
Aleph Alpha의 78B MoE Kolibri-1을 47.5GB Q4_K_M GGUF로 양자화하여 패치된 llama.cpp와 128GB RAM 환경에서 CPU 단독으로 초당 13~15 토큰을 기록한 로컬 구동 방식을 정리합니다.
RTX 5060 Ti(16GB), RTX 5090(32GB), GB10(128GB/256GB) 환경에서 Qwen3.8-27B, Qwen3.8-Flash-Next, GLM-5.3-Flash 모델의 런타임별 추론 속도(tok/s)와 첫 토큰 지연시간(TTFT)을 실측 비교한 벤치마크 결과입
거부 반응이 제거된 무검열 Nex-N2.5-mini GGUF 빌드(IQ4_XS)가 공개되어 18GB VRAM 환경에서 로컬 구동이 가능해졌습니다. 35B MoE(3.5B 활성), 262K 컨텍스트, 비전 및 llama.cpp 에이전틱 코딩 지원 사양과 활용 팁을 정리합니다.
초거대 AI 모델의 이면에서 대규모 서빙과 로컬 실행, 게이트웨이, 벡터 검색, 분산 오케스트레이션을 지탱하는 10대 핵심 오픈소스 인프라 저장소(vLLM, llama.cpp, SGLang, Ollama, LiteLLM, Milvus, Qdrant, TensorRT-LLM, Ray, K
Impact-Site-Verification: 9b3ebd10-6c45-44cf-a014-5b8c19b7b285