상태·행동 대조 학습 기반 초고속 System 1 모델 'CLM-8B' 공개: DeepSWE 81.6% 달성
Azalia Mirhoseini와 Jacky Kwok 연구팀이 상태와 액션을 대조 학습으로 연결하는 시스템 1 모델 CLM-8B를 공개했습니다. 경량 파인튜닝을 통해 DeepSWE 81.6% 및 Terminal-Bench 2.1 87.6%로 에이전틱 코딩 SOTA를 경신하고 기존 Jev
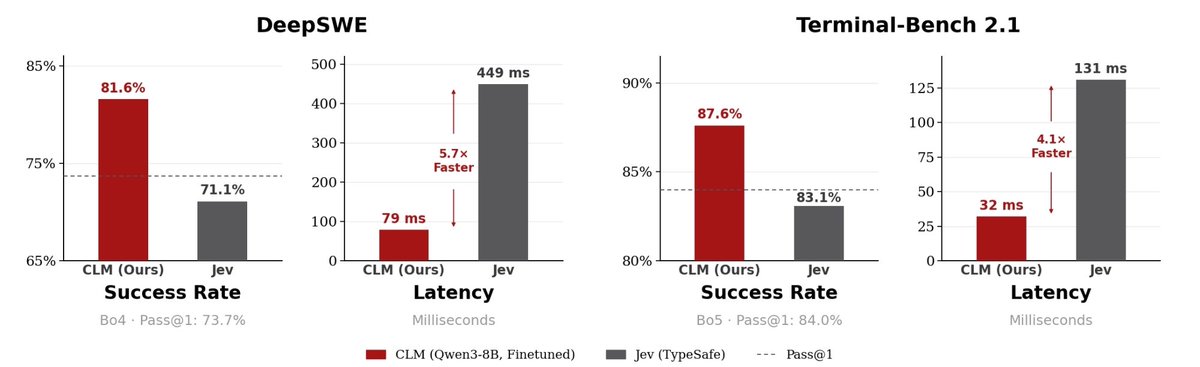
2026년 9월 24일, AI 연구자인 아잘리아 미르호세이니(Azalia Mirhoseini)와 재키 쿽(Jacky Kwok) 연구팀이 상태(State)와 행동(Action)을 대조 학습(Contrastive Learning) 목표로 직접 매핑하는 초고속 시스템 1(System 1) 모델 'CLM(Contrastive Language Model)'과 80억 파라미터 기반 가중치인 'CLM-8B', 훈련 데이터셋, 서빙 인프라를 오픈소스로 전면 공개했습니다.
이미지 출처: @Azaliamirh / X
기존 자율 에이전트 파이프라인은 화면 조작이나 터미널 제어, 도구 호출과 같은 반복적인 판단 단계마다 거대한 오토리그레시브(Autoregressive) LLM이 순차적으로 토큰을 생성해야 해 심각한 추론 병목과 지연 시간을 겪어왔습니다. 이번에 공개된 CLM-8B는 액션 선택을 텍스트 생성 문제가 아닌 상태-행동 간 대조 유사도 평가 문제로 전환하여, 대표적인 System 1 모델인 Jev와 대등한 제로샷 성능을 내면서도 최대 9배 빠른 추론 속도를 달성했습니다.
대조 학습 기반 상태-행동 분리와 액션 임베딩 캐싱
CLM-8B의 핵심 기술적 진보는 상태와 행동을 분리(Disaggregation)하여 처리하는 대조 학습 아키텍처에 있습니다. 기존 생성형 에이전트 모델이 현재 관측 상태와 가능한 행동들을 단일 프롬프트 시퀀스로 묶어 긴 텍스트를 처리하는 것과 달리, CLM은 상태 표현과 후보 액션을 독립된 임베딩 공간으로 사상합니다.
- 상태-행동 분리(State-Action Disaggregation): 환경의 관측 상태와 에이전트가 취할 수 있는 후보 행동을 독립적으로 인코딩하여 상호 대조 목표 함수로 정렬합니다.
- 액션 사전 계산 및 임베딩 캐싱: 가능한 후보 액션이 사전에 정의되어 있거나 반복되는 환경에서는 액션 임베딩을 미리 계산해 캐시로 유지할 수 있습니다. 새로운 관측 상태가 유입될 때마다 토큰을 새로 생성할 필요 없이, 상태 벡터와 캐시된 액션 벡터 간의 대조 유사도 평가만으로 최적의 행동을 즉각 선별합니다.
- 초저지연 System 1 의사결정 오프로딩: 복잡한 장기 계획과 심층 분석은 무거운 System 2 모델이 담당하고, 빈번한 UI 내비게이션, 키 입력, 단순 도구 호출 등 고속 반응이 요구되는 실행 루프는 CLM-8B가 전담하여 에이전트 전체 런타임 효율을 극대화합니다.
에이전틱 코딩 벤치마크 SOTA 경신과 Jev 대비 9배 속도 향상
연구팀은 CLM-8B의 벤치마크 평가 결과와 실측 추론 속도를 상세히 공개했습니다.
장기 실행이 요구되는 에이전틱 코딩 벤치마크에서 CLM-8B는 경량 파인튜닝(Lightweight Finetuning)을 거쳐 새로운 최고 성능(SOTA)을 수립했습니다.
- 에이전틱 코딩 벤치마크: 소프트웨어 엔지니어링 벤치마크인 DeepSWE에서 81.6%, 터미널 자율 제어 평가인 Terminal-Bench 2.1에서 87.6%의 성공률을 기록했습니다. 이는 프로세스 검증(PRM) 헤드 및 태스크 트레이젝터리에 대한 경량 파인튜닝을 통해 달성한 새로운 최고 성능입니다.
- Jev 대비 최대 9배 추론 속도: 컴퓨터 유즈(Computer-use), 게임 제어, 도구 호출(Tool-calling) 태스크의 제로샷(Zero-shot) 평가에서 Jev와 대등한 작업 성공률을 보이면서도 추론 속도는 최대 9배(up to 9x) 향상되었습니다.
- 속도 향상 조건 및 실무 유의점: 연구팀은 최대 9배의 속도 향상이 위키레이싱(WikiRacing)처럼 탐색 대상 후보 액션 수가 많거나, T-Rex 게임처럼 동일한 액션 세트가 여러 상태에 걸쳐 지속적으로 반복 재사용되는 환경에서 가장 극대화된다고 설명했습니다. 후보 행동 공간이 완전히 임의의 텍스트 생성이어야 하거나 캐시 재사용성이 낮은 환경에서는 속도 향상 폭이 달라질 수 있습니다.
오픈소스 생태계 배포 현황과 차기 35B 모델 로드맵
CLM-8B의 주요 모델 산출물은 Hugging Face를 통해 전면 오픈소스로 공개되었습니다.
- 가중치 및 데이터셋 공개: Hugging Face의
Contrastive-LM조직을 통해 PyTorch 기반 모델 체크포인트인Contrastive-LM/CLM-v0.1-8B가 공개되었습니다. 재현성 검증을 위해 DeepSWE PRM 헤드(deepswe-prm-heads-8k), 학습 및 평가 임베딩 데이터셋(deepswe-prm-embeddings-8k,tb21-clm-cv-embeddings-8k), 교차 검증 헤드(tb21-clm-cv-heads-8k)도 함께 제공됩니다. - 재현 가능한 인프라 스크립트: 공개된 릴리즈 브랜치 코드를 통해 태스크 분리 3-fold CLM 학습 및 Best-of-5 평가를 자체 환경에서 직접 수행할 수 있습니다.
- CLM-35B 추가 공개 예고: 연구팀은 향상된 일반화 역량과 더 큰 속도 향상을 지원하는 대형 파라미터 모델인 CLM-35B를 2026년 10월 초에 추가 릴리즈할 예정이라고 밝혔습니다.
초고속 System 1 대조 언어 모델에 관한 상세 가중치 및 코드베이스는 공식 저장소에서 확인할 수 있습니다.