16GB RTX 5060 Ti에서 Qwen3.5-4B 모델 성능 벤치마크: Llama.cpp, Ollama, vLLM 비교
16GB RTX 5060 Ti GPU에서 Qwen3.5-4B Q4_K_M 모델을 Llama.cpp, Ollama, vLLM으로 구동한 정밀 벤치마크 결과가 공개되었습니다. 짧은 프롬프트에서 114 tok/s, 262K 컨텍스트에서는 KV 캐시 12GB 점유로 34 tok/s까지 속도가
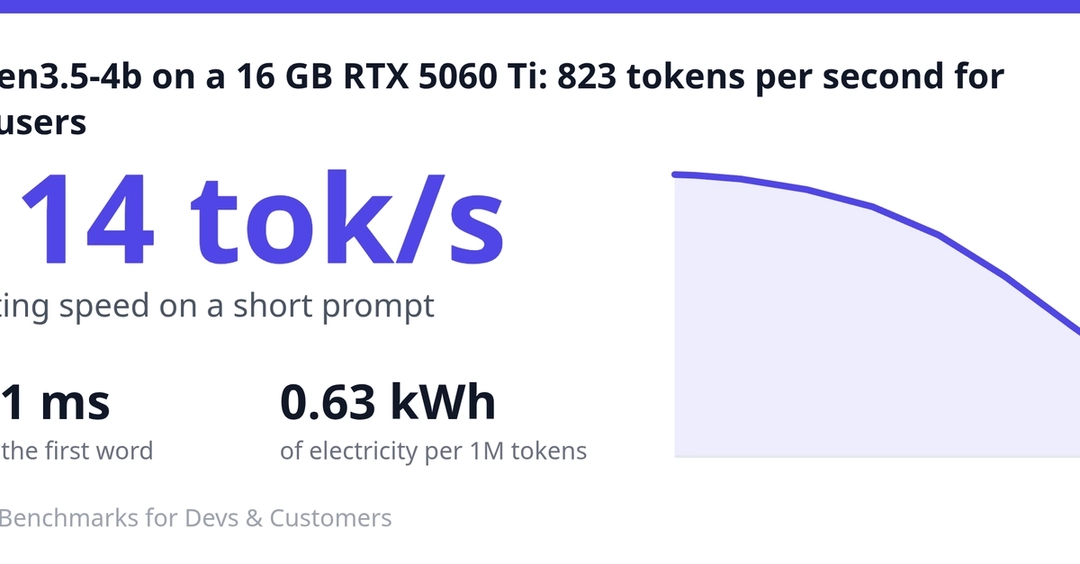
최근 16GB 비디오 메모리를 탑재한 엔비디아 지포스 RTX 5060 Ti(NVIDIA GeForce RTX 5060 Ti) 그래픽카드 환경에서 소형 언어 모델인 Qwen3.5-4B를 대상으로 진행한 교차 실측 벤치마크 결과가 공개되었습니다. 이번 테스트는 대표적인 로컬 인퍼런스(온디바이스 AI 구동) 도구인 Llama.cpp, Ollama, vLLM을 각각 활용해 동일한 하드웨어에서 모델 구동 속도와 자원 점유 양상을 비교한 상세한 성능 프로파일을 제시합니다.
이미지 출처: https://dev.to/elcances/qwen35-4b-on-a-16-gb-rtx-5060-ti-823-tokens-per-second-for-16-users-6i
40억 개(4B) 파라미터를 가진 소형 모델인 Qwen3.5-4B는 모바일 기기나 엣지 컴퓨팅 환경뿐만 아니라 개인용 데스크톱에서도 빠르게 작동하여 실사용성 측면에서 주목받고 있습니다. 이번 분석은 짧은 질의응답부터 260K(약 26만) 토큰에 달하는 긴 문맥(Context) 입력까지 다양한 시나리오에서 각 구동 도구가 보여주는 성능 한계와 효율성을 수치로 증명합니다.
단일 사용자 환경에서의 실행 도구별 성능 비교
단일 사용자가 로컬 기기에서 모델을 구동할 때, 각 도구의 아키텍처와 기본 설정에 따라 시작 시간과 토큰 처리 속도에서 뚜렷한 차이가 나타났습니다.
- Llama.cpp: 단일 사용자 환경에서 가장 직관적이고 효율적인 선택지로 평가됩니다. 프로그램 실행부터 첫 번째 토큰이 출력될 때까지의 시작 시간(Start-up time)이 1.03초로 가장 빨랐으며, 짧은 프롬프트 구간에서 Ollama와 동일한 수준의 최고 생성 속도(114 tok/s)를 기록했습니다. 별도의 서버 설정을 거칠 필요가 없다는 점도 장점입니다.
- Ollama: 사용자 친화적인 인터페이스와 관리 기능으로 널리 쓰이지만, 실행 초기 구동에 4.7초가 소요되었고 짧은 프롬프트 기준 첫 단어 대기 시간(TTFT, Time To First Token)이 165ms로 Llama.cpp나 vLLM에 비해 약간 더 긴 지연을 보였습니다. 단, 생성 속도 자체는 114 tok/s로 Llama.cpp와 대등한 수준을 유지했습니다.
- vLLM: 대규모 서버 환경에 특화된 고성능 인퍼런스 엔진으로, 초기 구동에 48초가 소요되어 단일 사용자용으로는 무거운 편이지만, 다중 사용자 동시 처리와 전력 효율 측면에서 강점을 보입니다.
컨텍스트 확장과 KV 캐시의 병목 현상
이번 벤치마크에서 가장 주목할 부분은 문맥 길이가 늘어남에 따라 발생하는 성능 저하와 메모리 점유 양상입니다.
짧은 프롬프트(512 토큰 컨텍스트 기준)에서 Llama.cpp는 초당 114개의 토큰을 생성하고 첫 토큰 출력까지 101ms의 빠른 반응 속도를 보였습니다. 그러나 문맥 길이가 32K 토큰으로 늘어나면 생성 속도가 88 tok/s로 하락하며, 전체 모델의 최대 한계인 262K 토큰의 풀 컨텍스트를 사용할 경우 생성 속도는 34 tok/s까지 급격히 떨어집니다.
이처럼 속도가 떨어지는 주된 원인은 **KV 캐시(Key-Value Cache)**가 GPU 메모리를 과도하게 점유하기 때문입니다. 262K 토큰의 방대한 문맥을 처리할 때, 16GB 용량의 RTX 5060 Ti 메모리 중 무려 12GB가 오직 KV 캐시 용도로 소모됩니다. 이로 인해 방대한 입력 프롬프트를 미리 읽어들이는 전처리에만 상당한 시간(135초 가량)이 소요되며, 실제 텍스트 생성이 시작되기 전까지 긴 대기 시간을 감수해야 합니다.
다중 사용자 동시 처리와 하드웨어 벤치마크 환경
단일 사용자용 도구들과 달리, vLLM 서버를 구축할 경우 하나의 예산형 GPU로도 팀 단위의 다중 사용자 워크로드를 소화할 수 있음이 확인되었습니다.
- vLLM 다중 접속 처리: 16명의 사용자가 동시에 요청을 보낼 때, vLLM 서버는 총 823 tok/s의 집계 처리량을 기록했습니다. 각 사용자는 개별적으로 초당 약 51 토큰의 속도를 누리면서도 첫 단어를 받기까지 약 1,210ms의 안정적인 대기 시간을 경험했습니다. 또한 전력 소비 측면에서도 1백만 토큰 생성당 0.52 kWh를 기록해 가장 뛰어난 에너지 효율을 보여주었습니다.
- 테스트 하드웨어 사양: 이번 실측은 인텔 코어 울트라 7 265K(Intel Core Ultra 7 265K) CPU, ASUS ROG MAXIMUS Z890 APEX 마더보드, 64GB DDR5-5600 RAM, 그리고 MSI 지포스 RTX 5060 Ti 16GB(GDDR7) GPU가 탑재된 리눅스 시스템에서 수행되었습니다. 모든 모델은 동일한 하드웨어에서 구동되어 공정한 비교가 이루어졌습니다.
결론적으로 RTX 5060 Ti 환경에서 혼자 작업하는 사용자라면 가볍고 빠르게 시작할 수 있는 Llama.cpp가 최적의 선택이며, 여러 사용자의 요청을 안정적으로 분산 처리해야 하는 소규모 서비스 환경에서는 vLLM의 도입을 고려할 수 있습니다. 다만, 소형 모델이라 할지라도 260K를 넘나드는 초대형 문맥을 직접 주입할 때는 메모리 한계와 긴 전처리 지연 시간을 염두에 두어야 합니다.
출처
- DEV Community (Ahmet Özel): Qwen3.5-4b on a 16 GB RTX 5060 Ti: 823 tokens per second for 16 users