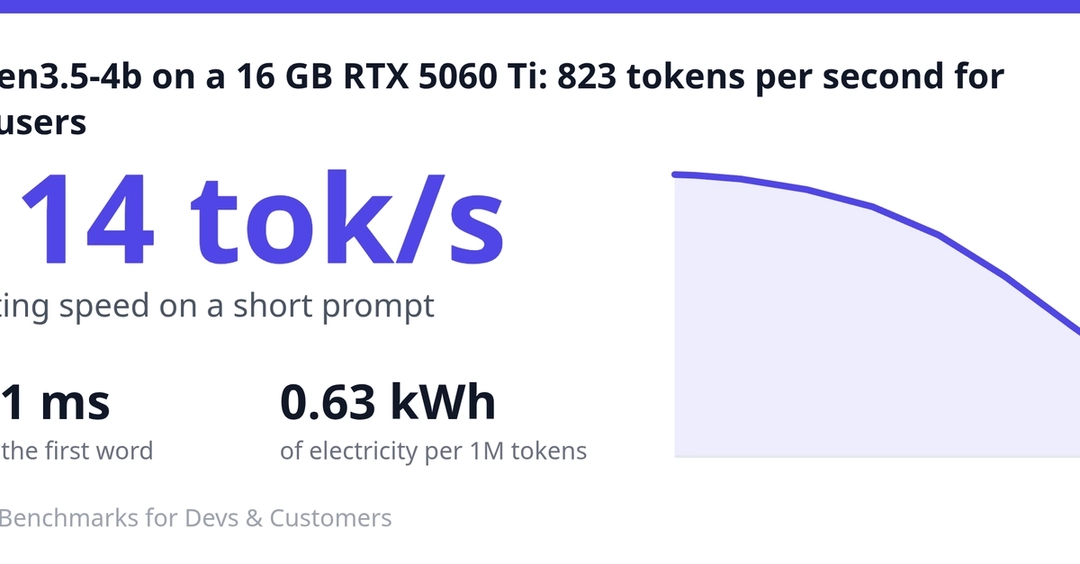
16GB RTX 5060 Ti에서 Qwen3.5-4B 모델 성능 벤치마크: Llama.cpp, Ollama, vLLM 비교
16GB RTX 5060 Ti GPU에서 Qwen3.5-4B Q4_K_M 모델을 Llama.cpp, Ollama, vLLM으로 구동한 정밀 벤치마크 결과가 공개되었습니다. 짧은 프롬프트에서 114 tok/s, 262K 컨텍스트에서는 KV 캐시 12GB 점유로 34 tok/s까지 속도가
TAU-HOME.COM에서 GPU 태그로 묶인 글입니다.
16GB RTX 5060 Ti GPU에서 Qwen3.5-4B Q4_K_M 모델을 Llama.cpp, Ollama, vLLM으로 구동한 정밀 벤치마크 결과가 공개되었습니다. 짧은 프롬프트에서 114 tok/s, 262K 컨텍스트에서는 KV 캐시 12GB 점유로 34 tok/s까지 속도가
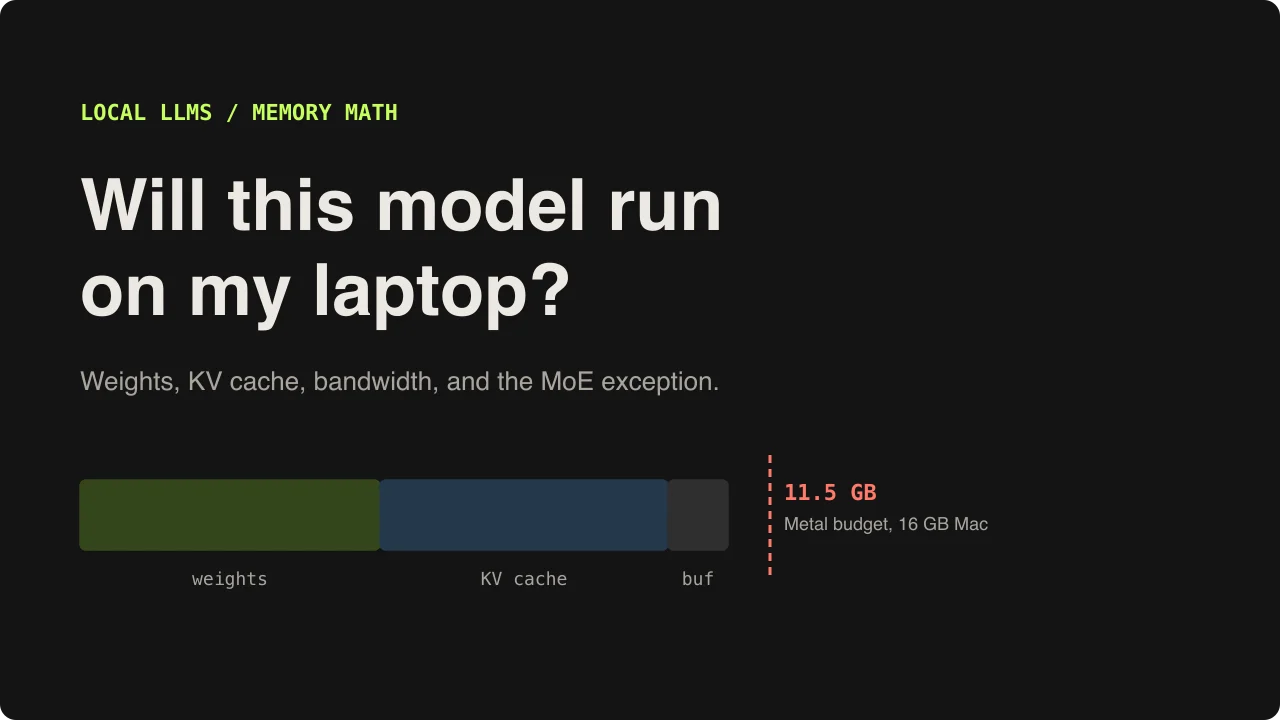
16GB 메모리 노트북에서 대형 언어 모델(LLM)을 다운로드하기 전 1분 만에 실행 가능성을 판정하는 `fit.py` 스크립트와 macOS 통합 메모리의 숨겨진 10.9GB 상한선 함정이 공개되었습니다. 가중치 계산법과 KV 캐시 산수를 통해 모델 구동 여부와 예상 토큰 속도를 사전에
SK와 GS가 추진하는 최대 17.4GW 규모 AI 데이터센터 사업을 둘러싸고 국내외 실제 연산 수요와 대규모 GPU 조달 역량, 장비 감가상각에 따른 과잉 투자 리스크를 면밀히 짚어봅니다.
로컬 GPU 환경에서 영상 내 모자이크를 정밀 복원하는 오픈소스 도구 Jasna의 하드웨어 호환성, 복원 파이프라인, 서포터 모델 운용 정책을 상세히 분석합니다.
오픈소스 LLM 추론 엔진 Project Maya의 신규 릴리스가 공개되었습니다. 최대 16개 GPU 병렬 구성을 지원하며, RTX 3090 디코드 속도 향상과 Tesla V100 프리필 성능 개선(최대 674 tok/s)이 포함되었습니다.
DeepSeek이 공개한 GPU 텐서 코어 커널 라이브러리 DeepGEMM. 런타임 JIT 컴파일로 설치 사전 컴파일을 없애고 FP8/FP4/BF16 GEMM, 통신·연산 오버랩 Mega MoE, MQA 스코어링 커널을 단일 코드베이스로 제공합니다.
Impact-Site-Verification: 9b3ebd10-6c45-44cf-a014-5b8c19b7b285