단일 에이전트 하네스 과적합을 막는 허깅페이스의 멀티 하네스 강화학습(Multi-Harness RL) 아키텍처
허깅페이스와 리퀴드 AI가 특정 에이전트 하네스 종속을 탈피하기 위해 공개한 멀티 하네스 강화학습 구조와 OpenEnv, Harbor, TRL 연동 워크플로우를 정리합니다.
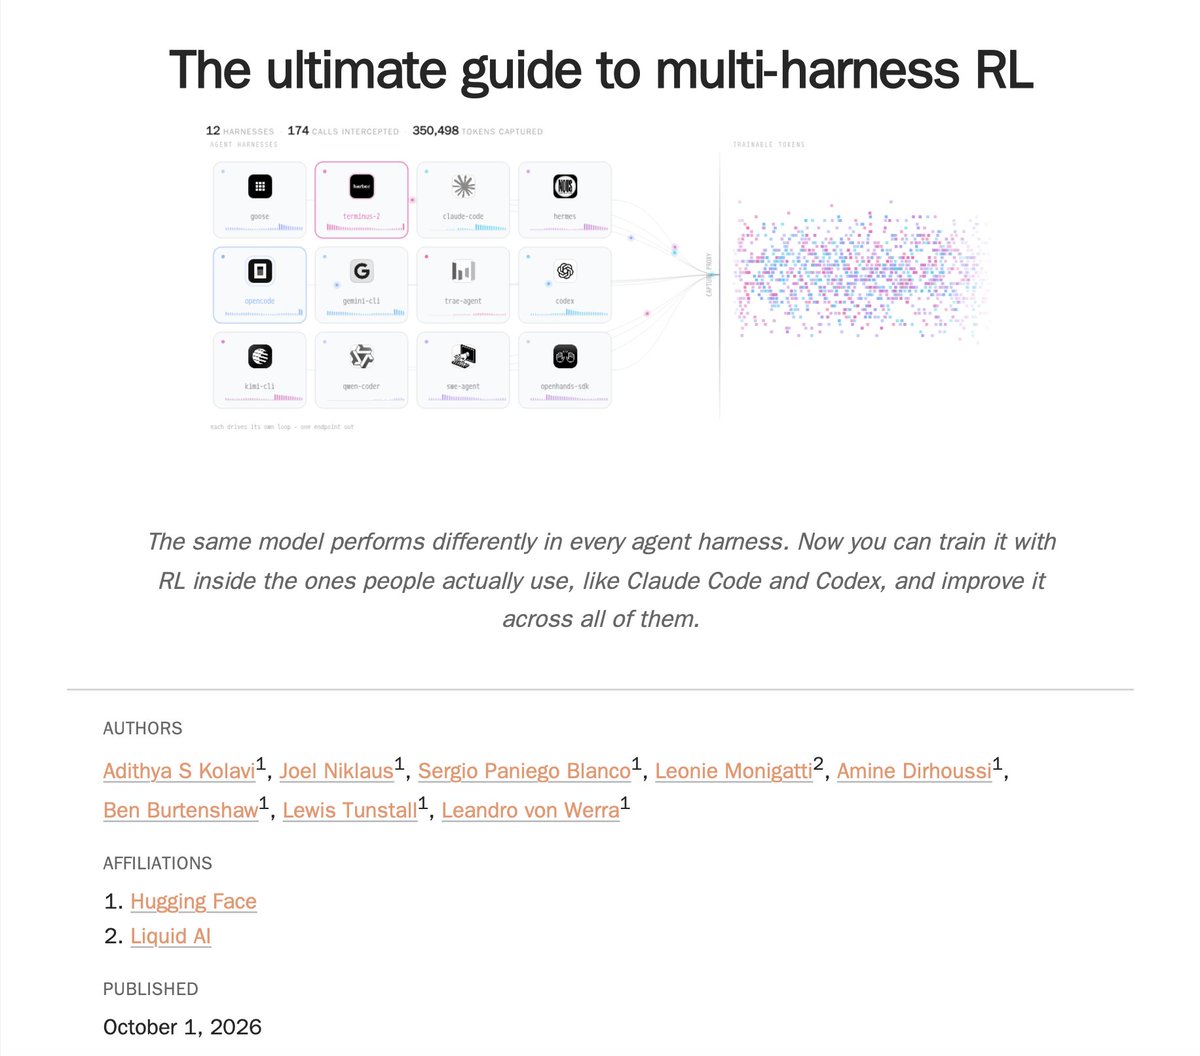
악샤이 파차르(Akshay Pachaar, @akshay_pachaar)가 2026년 10월 4일, 특정 에이전트 하네스에 과적합되는 오픈소스 언어 모델의 한계를 극복하기 위해 허깅페이스(Hugging Face) 포스트 트레이닝 팀과 리퀴드 AI(Liquid AI) 연구진이 공개한 '멀티 하네스 강화학습(Multi-Harness RL) 실전 가이드'의 핵심 아키텍처와 실험 결과를 공유했습니다.
이미지 출처: @akshay_pachaar via X
동일한 오픈소스 가중치 모델이라도 특정 에이전트 런타임에서는 뛰어난 성능을 보이다가 다른 하네스로 환경을 옮기면 급격한 정확도 하락을 겪거나 잘못된 형식의 도구 호출(Invalid tool calls)을 내뱉는 현상은 실무 개발 현장에서 빈번히 관찰됩니다. 이번에 공개된 멀티 하네스 강화학습 워크플로우는 모델이 단일 인터페이스의 조작법에 매몰되지 않고, 다양한 하네스 환경 전반에서 일관된 문제 해결 능력을 발휘하도록 학습 파이프라인을 재설계하는 구체적인 해법을 제시합니다.
특정 하네스 종속과 도구 호출 실패를 야기하는 단일 인터페이스 과적합
에이전트 하네스(Harness)는 Claude Code, Codex, OpenCode, Mini-SWE-Agent 등 모델 주변을 감싸고 있는 실행 프레임워크입니다. 하네스는 툴 호출 루프 제어, 모델에게 제공할 프롬프트와 컨텍스트 조립, 예외 처리 및 재시도 메커니즘, 실행 중단 시점 판정 등 에이전트 동작 전반을 관장합니다.
모델을 단 하나의 하네스 인터페이스 안에서만 사후 학습(Post-training)이나 강화학습을 진행할 경우 다음과 같은 구조적 문제가 발생합니다.
- 인터페이스 종속적 패턴 학습: 모델은 과제를 해결하는 본질적인 추론 규칙뿐만 아니라 특정 하네스가 요구하는 고유한 도구 명칭, 출력 포맷 스키마, 컨텍스트 계층 구조, 재시도 제어 흐름에 과적합됩니다.
- 배포 환경 변경 시 성능 붕괴: 학습 시 사용한 하네스와 다른 환경에 모델을 배포하면, 프롬프트나 파라미터 구조의 미세한 차이로 인해 유효하지 않은 도구 호출을 생성하거나 루프에 빠지게 됩니다.
즉, 모델이 '문제를 해결하는 방법'이 아니라 '특정 하네스를 조작하는 방법'만을 학습하게 되는 단일 하네스 편향(Single-harness bias)이 고착화되는 것입니다.
OpenEnv·Harbor·TRL 3단계 연동: 하네스 원형을 보존하는 궤적 수집
허깅페이스와 리퀴드 AI 연구진은 모델을 하나의 인터페이스에서만 학습시키는 대신, Claude Code, Codex, OpenCode, Mini-SWE-Agent 등 4개 하네스 환경을 동시에 아우르는 멀티 하네스 강화학습 구조를 설계했습니다. 이를 위해 세 가지 오픈소스 프레임워크를 상호 결합했습니다.
- OpenEnv: 에이전트 하네스와 강화학습 환경, 트레이너 사이를 중개하는 표준 인터페이스를 제공합니다. 핵심 구성요소인 캡처 프록시(Capture proxy)가 하네스와 모델 서빙 서버 사이에 위치하여, 학습에 필수적인 정확한 토큰 시퀀스와 생성 확률(Generation probabilities)을 실시간으로 가로채 기록합니다.
- Harbor: 에이전트를 컨테이너 기반 격리 샌드박스 환경에서 실행하는 프레임워크입니다. 작업(Task), 하네스(Harness), 샌드박스(Sandbox)를 독립적으로 분리하여 관리하므로, 동일한 테스트 과제를 매번 샌드박스를 재구축할 필요 없이 서로 다른 하네스에 유연하게 주입할 수 있습니다.
- TRL (Transformers Reinforcement Learning): 허깅페이스의 공식 사후 학습 및 강화학습 라이브러리로, OpenEnv가 수집한 다중 하네스 궤적(Trajectories) 데이터를 기반으로 모델 정책 가중치를 갱신합니다.
이 아키텍처의 결정적 장점은 데이터 수집 과정에서 각 하네스의 고유 동작을 훼손하지 않는다는 점입니다. 트레이너 내부에서 하네스 동작을 어설프게 모방하거나 단순화하지 않고, 각 하네스가 가진 네이티브 도구 체계, 시스템 프롬프트, 컨텍스트 관리(Context management), 재시도 루프를 그대로 유지한 채 OpenEnv 프록시를 통해 실제 모델 호출 흐름만을 관측하여 학습 시퀀스로 변환합니다.
LFM2.5-2.6B 벤치마크 결과: 첫 시도 해결률 54.2% 달성과 도구 호출 31% 절감
연구진은 소형 오픈소스 언어 모델인 LFM2.5-2.6B를 선정하여 4개 하네스 환경에서 멀티 하네스 강화학습을 진행하고, 미학습 검증 과제(Held-out tasks)를 대상으로 성능 변화를 측정했습니다.
- 첫 시도 해결률 향상: 4개 하네스 전체 평균 첫 시도 과제 해결률이 기존 베이스 모델의 42.2%에서 54.2%로 12.0%p 상승했으며, 4개 하네스 각각의 평가에서도 모두 성능 향상을 기록했습니다.
- 도구 호출 효율성 개선: 베이스 모델과 학습 모델이 모두 성공적으로 해결한 과제들을 기준으로 비교했을 때, 멀티 하네스 학습 모델은 도구 호출(Tool calls) 횟수를 31% 덜 사용하고도 동일한 정답에 도달했습니다. 동일 과제 해결 시 필요한 도구 호출 효율이 향상되었음을 보여줍니다.
- 단일 하네스 학습과의 비교: OpenCode 단일 하네스에서만 특화 학습을 진행한 대조군 모델 역시 OpenCode 내부에서는 성능이 향상되었으나, 대부분의 성과가 OpenCode 내부에만 집중되었고 다른 하네스로는 거의 전이되지 않는 편중 현상을 보였습니다. 반면 멀티 하네스 학습 모델은 여러 인터페이스 전반에 걸쳐 성능 향상을 고르게 확산시켰습니다.
실험의 한계점과 하네스 이식성(Portability) 확보를 위한 시사점
이번 연구는 멀티 하네스 강화학습의 실효성을 입증했으나, 실무 적용 시 몇 가지 구조적 한계와 제약 조건을 함께 고려해야 합니다.
- 단일 과제군 및 단일 시드 검증: 실험은 단일 과제 패밀리(One task family)와 단일 훈련 시드(One training seed)로 국한되어 진행되었으므로, 해당 결과를 보편적인 랭킹 지표로 단정할 수는 없습니다.
- 데이터 노출량의 불균형: 실험 과정에서 훈련 조건 간에 데이터 노출량이 균등하지 않았기(Unequal data exposure) 때문에, 단순 수치 비교 시 노출량 편차를 감안해야 합니다.
- 단일 목적 배포와의 트레이드오프: 특정 기업이나 프로젝트가 단 하나의 사내 전용 하네스만을 배포 타깃으로 삼는다면 단일 하네스 특화 학습이 최고 점수를 기록할 수 있습니다. 그러나 범용 오픈소스 모델을 다양한 클라이언트 환경에 배포해야 한다면 멀티 하네스 학습이 필수적입니다.
결론적으로 오픈소스 모델 개발자는 최종 사용자가 특정 하네스 하나만을 고정적으로 사용할 것이라 전제해서는 안 됩니다. 다채로운 에이전트 생태계에서 유효하게 작동하는 강력한 모델을 구축하고자 한다면, 인터페이스 간 이식성(Portability)을 모델 배포 단계가 아닌 강화학습 훈련 단계에서부터 직접 주입해야 한다는 사실을 이번 가이드는 명확히 보여줍니다.