xplabs에서 비검열 GLM 5.3 Flash 모델 1분 만에 무료 이용하는 팁
xplabs 웹 플랫폼을 통해 8xH100 GPU 노드와 공유 13M TPM 풀로 제공되는 320B 규모 비검열(Uncensored) GLM 5.3 Flash 모델의 1분 무료 접속 단계와 주요 주의사항을 정리합니다.
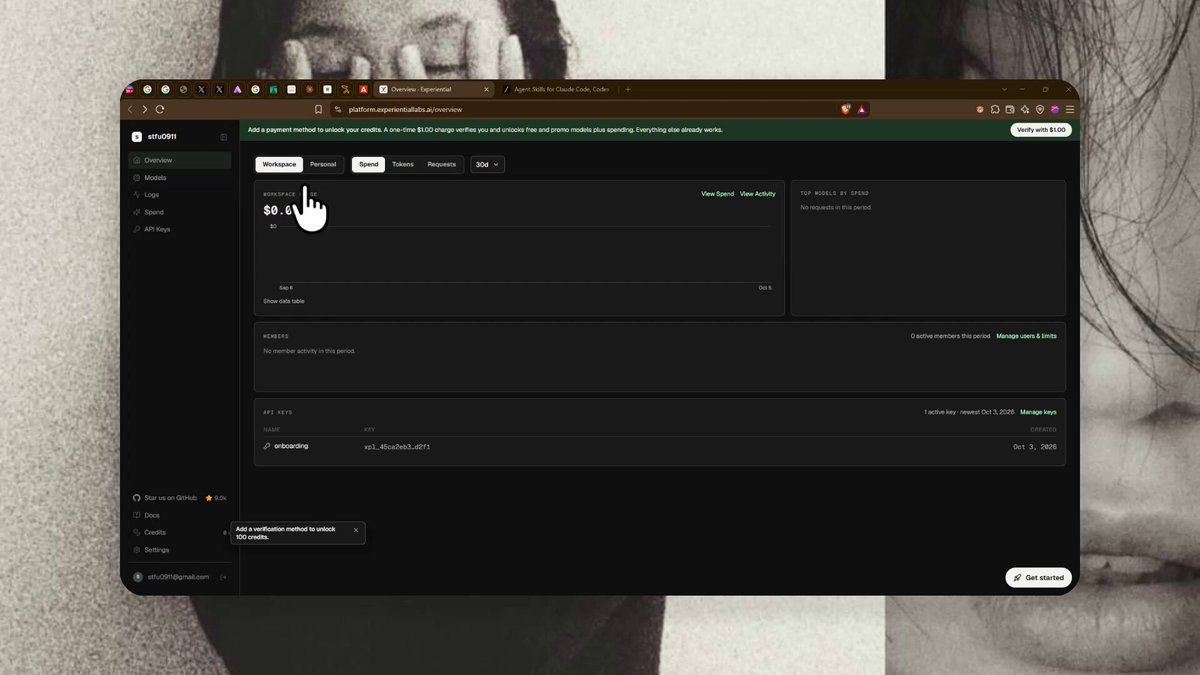
X(옛 트위터)의 AI 크리에이터 포하(Forha, @Forhanvv)가 2026년 10월 5일, 320B 규모의 대형 언어 모델 GLM 5.3 Flash의 비검열(Uncensored) 버전을 xplabs 웹 플랫폼에서 1분 만에 무료로 이용할 수 있는 빠른 접속 가이드와 핵심 주의사항을 공유했습니다.
이미지 출처: @Forhanvv / X
GLM 5.3 Flash는 Zhipu AI(Z.ai)가 공개한 320B 파운데이션 모델(활성 파라미터 약 18B의 MoE 아키텍처)을 기반으로 하며, 이번에 제공되는 버전은 dealignai가 모델 가중치 수준에서 거부(Refusal) 가드레일을 영구 제거한 FP8 비검열 릴리즈(dealignai/GLM-5.3-Flash-UNCENSORED-FP8)입니다. 독립 개발자 사일런 나이힌(Silen Naihin, @silennai)이 직접 8xH100 GPU 노드를 수개월간 임대하여 모델 최적화를 거친 뒤 xplabs 플랫폼을 통해 무료 엔드포인트로 개방했습니다.
1분 무료 접속 단계 (How to Claim)
포하(@Forhanvv)가 제시한 접속 및 이용 절차는 별도의 유료 결제나 복잡한 로컬 가중치 다운로드 없이 웹 브라우저를 통해 즉시 진행할 수 있습니다.
- 웹 브라우저에서 xplabs 공식 플랫폼 주소(
https://platform.xplabs.ai)에 접속합니다. - 접속 즉시 인터페이스에서 비검열 GLM 5.3 Flash 모델 대화를 시작합니다.
원문의 단계 표기를 그대로 유지한 이 절차는 복잡한 로컬 환경 구축이나 별도 API 키 대기 없이 웹 UI 상에서 바로 모델 추론을 테스트할 수 있도록 안내하고 있습니다.
핵심 주의사항 및 제약 조건 (Important)
무료 개방 인프라의 특성상 안정적인 활용을 위해 반드시 숙지해야 할 제약 조건들이 존재합니다.
- 성인 전용(Adults Only) 제한: 모델의 거부 가드레일이 가중치 레벨에서 제거되어 있으므로 미성년자는 이용할 수 없으며, 사용 시 안전 및 법적 책임을 준수해야 합니다.
- 공유 13M TPM 풀: 개별 사용자가 아닌 전체 접속자에게 총 13,000,000 TPM(Tokens Per Minute)의 공유 대역폭 풀이 할당되어 있습니다.
- 트래픽 급증 시 속도 저하: 단일 8xH100 GPU 노드 기반이므로 동시 접속자가 몰리는 시간대에는 토큰 생성 속도가 느려질 수 있습니다 (피크 처리량은 약 360 TPS 수준).
모델 아키텍처 및 인프라 배경
이번에 서빙되는 비검열 GLM 5.3 Flash는 단순한 프롬프트 탈옥(Jailbreak)이나 시스템 템플릿 변조가 아닌, 신경망 가중치 자체에서 거부 방향 벡터를 영구적으로 제거한 모델입니다.
- 네이티브 FP8 가속: Hopper 아키텍처(H100) GPU에서 네이티브 FP8 정밀도로 동작하여 빠른 추론 속도를 유지합니다.
- 특수 워크로드 활용: 정상적인 보안 연구나 취약점 분석, 악성코드 역공학 등 기존 정렬 모델에서 과도하게 거부(Over-refusal)되던 사이버 보안(Cybersecurity) 분석 및 전문 코딩 작업에 유용하게 활용할 수 있습니다.
- 커뮤니티 호스팅 자원: 개인이 임대한 GPU 노드 기반의 무료 개방 자원이므로, 인프라 운영 예산 및 트래픽 상황에 따라 서비스 제공 기간이 변동될 수 있습니다.
원문 출처
- Forha (@Forhanvv) X 포스트: https://x.com/Forhanvv/status/2107015032756445379