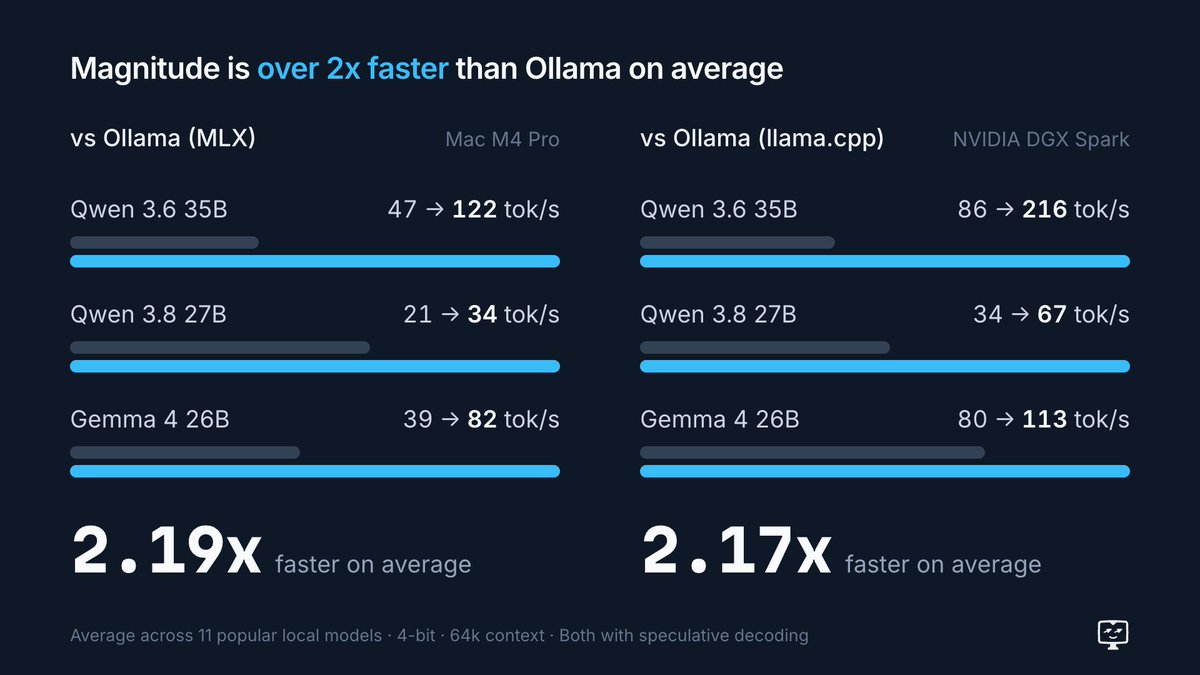
오픈소스 LLM 추론 엔진 '매그니튜드(Magnitude)' 공개… 기기별 커널 자동 튜닝으로 올라마 대비 디코드 평균 2.2배 가속
기기 칩셋에 맞춰 연산 커널을 최대 1분간 자동 튜닝해 올라마(Ollama) 대비 디코드 속도를 11개 모델 평균 2.19배(Mac M4 Pro 기준) 가속하는 오픈소스 로컬 LLM 추론 엔진 '매그니튜드(Magnitude)'가 발표되었습니다. 양자화 KV 캐시와 코딩 에이전트 연동을
TAU-HOME.COM에서 Magnitude 태그로 묶인 글입니다.
기기 칩셋에 맞춰 연산 커널을 최대 1분간 자동 튜닝해 올라마(Ollama) 대비 디코드 속도를 11개 모델 평균 2.19배(Mac M4 Pro 기준) 가속하는 오픈소스 로컬 LLM 추론 엔진 '매그니튜드(Magnitude)'가 발표되었습니다. 양자화 KV 캐시와 코딩 에이전트 연동을
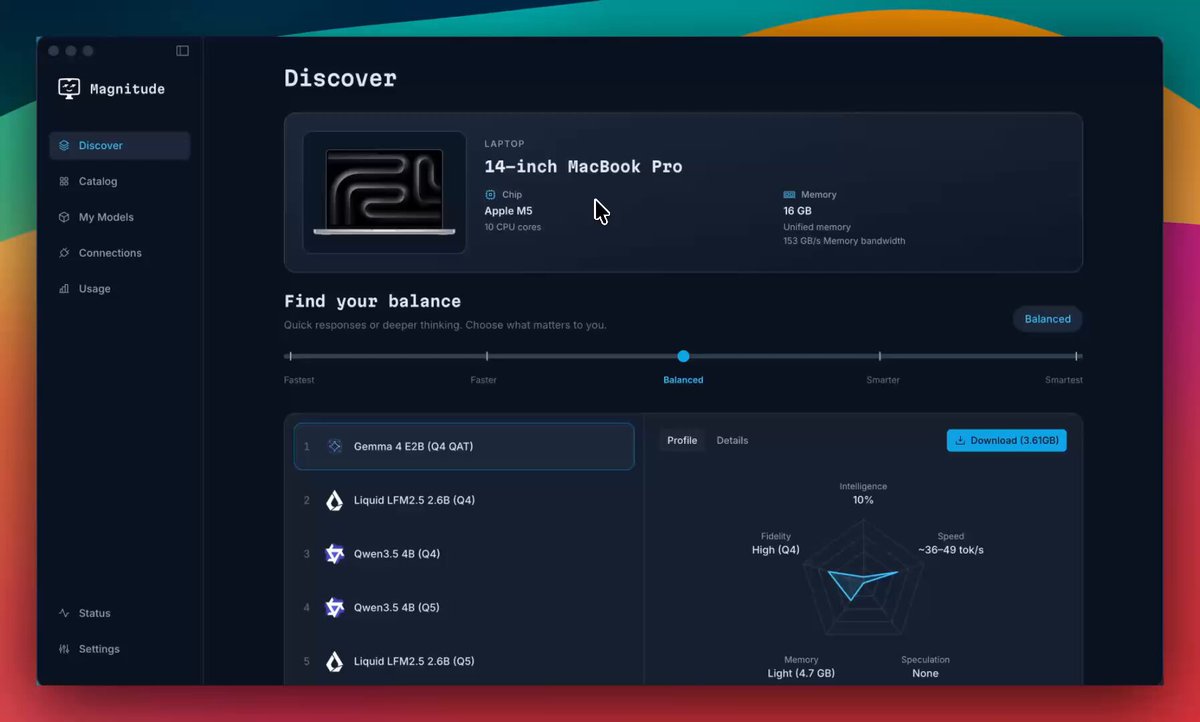
하드웨어 사양을 분석해 최적의 로컬 모델과 예상 토큰 속도를 추천하고, 투기적 디코딩 튜닝과 Pi·OpenCode·Claude Code 등 주요 하네스 원클릭 연동을 지원하는 오픈소스 도구 Magnitude를 분석합니다.
Impact-Site-Verification: 9b3ebd10-6c45-44cf-a014-5b8c19b7b285