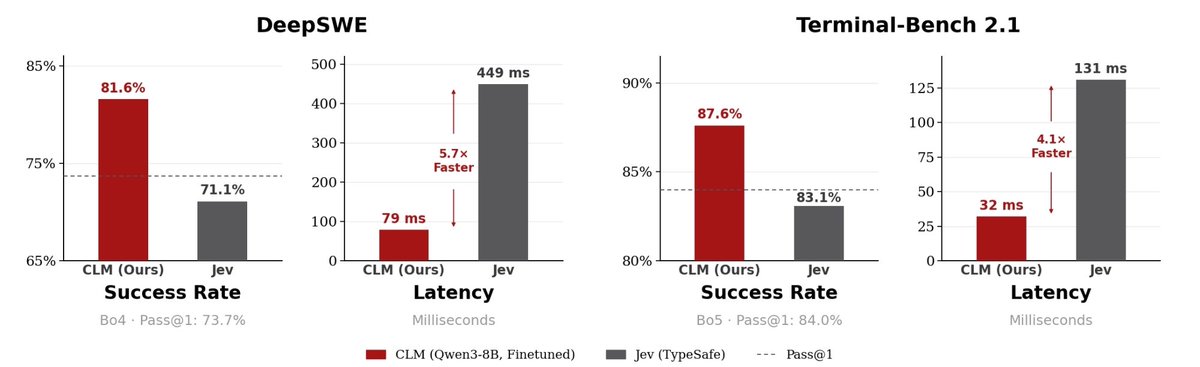
상태·행동 대조 학습 기반 초고속 System 1 모델 'CLM-8B' 공개: DeepSWE 81.6% 달성
Azalia Mirhoseini와 Jacky Kwok 연구팀이 상태와 액션을 대조 학습으로 연결하는 시스템 1 모델 CLM-8B를 공개했습니다. 경량 파인튜닝을 통해 DeepSWE 81.6% 및 Terminal-Bench 2.1 87.6%로 에이전틱 코딩 SOTA를 경신하고 기존 Jev
TAU HOME에서 CLM 태그로 묶인 글입니다.
Azalia Mirhoseini와 Jacky Kwok 연구팀이 상태와 액션을 대조 학습으로 연결하는 시스템 1 모델 CLM-8B를 공개했습니다. 경량 파인튜닝을 통해 DeepSWE 81.6% 및 Terminal-Bench 2.1 87.6%로 에이전틱 코딩 SOTA를 경신하고 기존 Jev
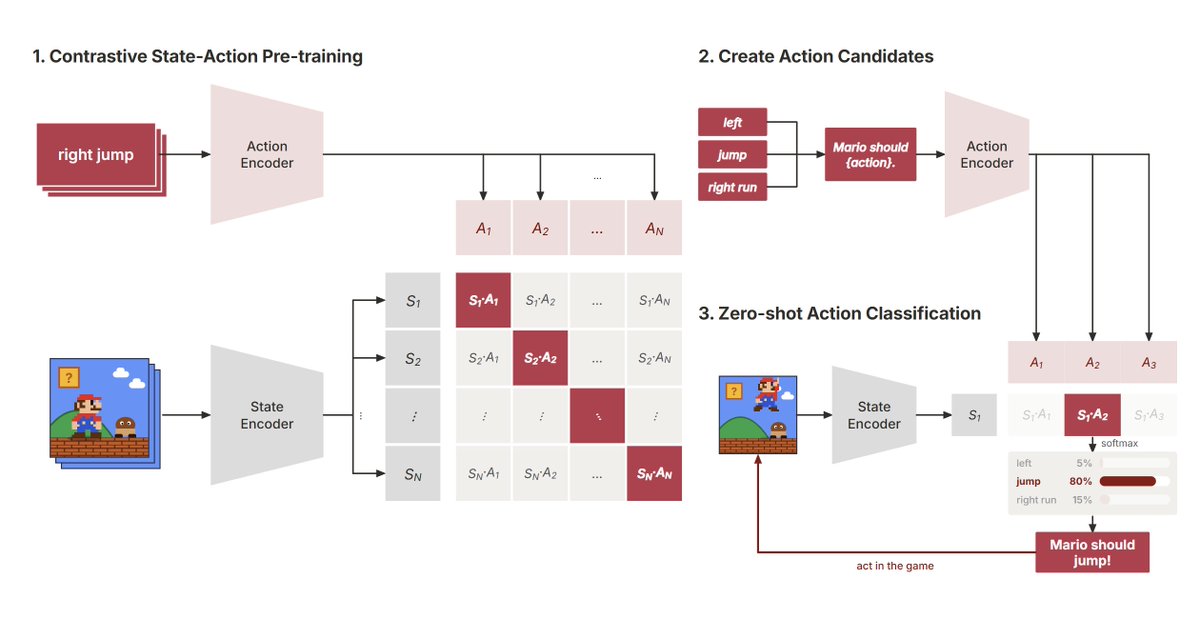
스탠퍼드 Hazy Research가 상태-행동 임베딩 분리 캐싱과 대조 학습을 적용한 시스템 1 결정 모델 CLM-8B의 가중치와 코드를 오픈소스로 공개했습니다. 제브(Jev) 대비 최대 9~13배 빠른 추론과 DeepSWE 등 에이전트 벤치마크 SOTA를 보고했습니다.