스탠퍼드 Hazy Research, Jev 대비 최대 9배 빠른 대조 언어 모델 'CLM-8B' 오픈 가중치 공개
스탠퍼드 Hazy Research가 상태-행동 임베딩 분리 캐싱과 대조 학습을 적용한 시스템 1 결정 모델 CLM-8B의 가중치와 코드를 오픈소스로 공개했습니다. 제브(Jev) 대비 최대 9~13배 빠른 추론과 DeepSWE 등 에이전트 벤치마크 SOTA를 보고했습니다.
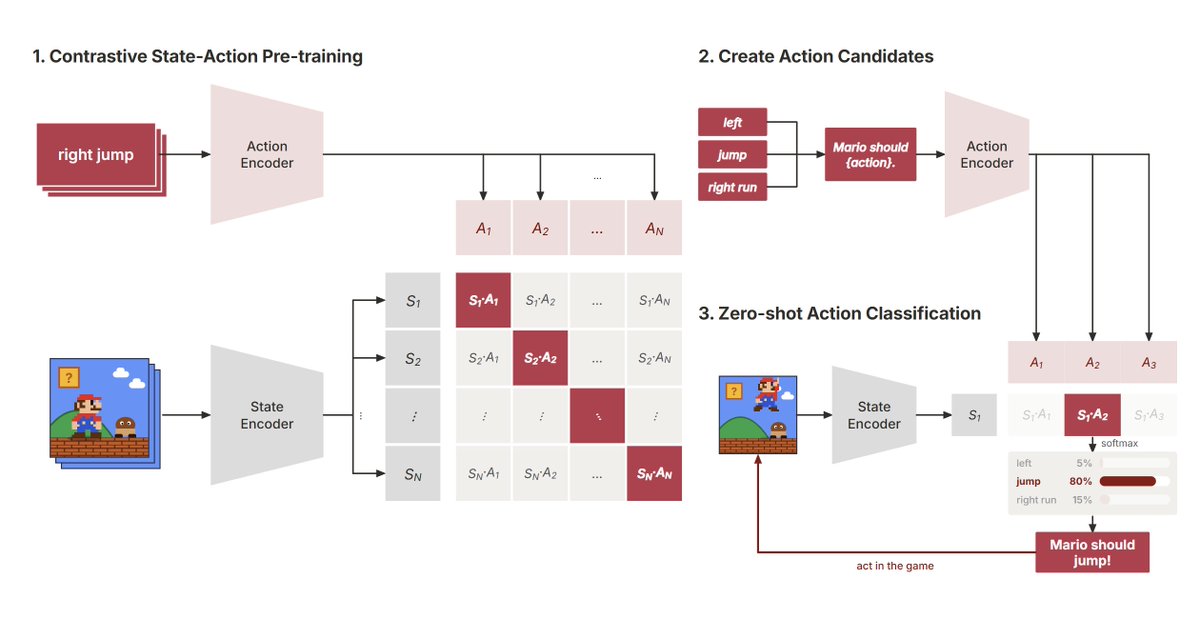
2026년 9월 24일, 스탠퍼드 대학교 컴퓨터과학과 산하 헤이지 리서치(Hazy Research) 연구팀의 재키 쿽(Jacky Kwok)과 연구진이 상태와 행동을 분리하여 대조 학습(Contrastive Learning)을 수행하는 새로운 시스템 1(System 1) 의사결정 모델 'CLM(Contrastive Language Model)'을 발표하고, 80억 파라미터 규모의 기본 모델인 'CLM-8B'의 모델 가중치와 소스코드를 오픈소스로 전격 공개했습니다.
이미지 출처: Jacky Kwok (@jackyk02) / Stanford Hazy Research / X
듀얼 인코더 구조와 상태·행동 임베딩 독립 캐싱의 원리
에이전트 워크플로우와 자율형 컴퓨터 사용(Computer-use) 환경에서는 대형 추론 모델(System 2)이 전체 계획을 수립하고, 경량화된 고속 결정 모델(System 1)이 구체적인 도구 선택이나 UI 클릭 등 개별 액션을 실시간으로 판정하는 분업 구조가 빠르게 확산되고 있습니다. 기존의 대표적인 시스템 1 모델인 타입세이프(TypeSafe)의 제브(Jev)는 이전 턴의 상태 임베딩을 보존하는 상태 캐싱(state caching)을 지원해 왔으나, 가능한 행동 후보군이 수백~수천 개로 늘어나는 워크로드에서는 여전히 지연 시간과 연산량의 한계가 존재했습니다.
헤이지 리서치가 제시한 CLM은 대규모 데이터셋에서 상태 인코더(State Encoder)와 행동 인코더(Action Encoder)를 분리해 훈련하는 듀얼 인코더 아키텍처를 채택했습니다. 대조 학습 목표(Contrastive Learning Objective)를 통해 현재 상태 벡터를 정답 행동(ground-truth action) 벡터와 가깝게 끌어당기고, 다른 모든 오답 행동 벡터와는 멀어지도록 학습시키는 방식입니다. 학습이 완료된 두 인코더는 그 자체로 고속 제로샷 행동 분류기(Zero-shot Action Classifier)로 동작합니다.
이러한 구조적 분리의 핵심 강점은 상태와 행동 임베딩을 각각 독립적으로 캐싱하고 재사용할 수 있다는 점입니다. 운영체제 GUI 조작, 웹 탐색, 고정 도구 세트 호출 등 행동 공간이 사전에 정의된 환경에서는 수많은 액션 후보의 임베딩을 미리 연산해 메모리에 올려두고, 상태가 바뀔 때마다 상태 임베딩만 새로 계산해 내적(dot product) 유사도를 구함으로써 극적인 속도 향상을 이끌어냅니다.
제로샷 추론 9배 가속과 에이전틱 벤치마크 SOTA 성과
연구진이 공개한 자체 벤치마크 평가 결과에 따르면, CLM-8B는 컴퓨터 유즈(Computer-use), 게임 플레이, 툴 콜링 등 다양한 의사결정 태스크의 제로샷(Zero-shot) 평가에서 제브(Jev)와 동등한 분류 정확도를 유지하면서도 최대 9배 빠른 추론 속도를 기록했습니다.
특히 후보 행동의 수가 방대하거나 동일한 행동 세트가 여러 상태에 걸쳐 반복 재사용되는 워크로드에서 성능 격차가 두드러졌습니다. 수천 개의 링크 후보 중 다음 이동 대상을 골라야 하는 위키레이싱(WikiRacing) 태스크와 같이 후보 행동이 약 1,000개에 달하는 환경에서는 Jev 대비 최대 13배 빠른 지연 시간을 달성했습니다. 크롬 T-Rex 러너 게임과 같이 제한된 조작키를 밀리초 단위로 반복 결정해야 하는 환경에서도 행동 임베딩 재사용을 통해 지연 시간을 획기적으로 단축했습니다.
장기 추론과 검증이 필요한 복합 에이전틱 코딩 벤치마크에서도 인상적인 결과를 보고했습니다. 연구진은 긴 호라이즌(Long-horizon)의 태스크에서 기존 Jev가 검증기(Verifier) 역할을 제대로 수행하지 못해 무작위 선택(Pass@1) 기준선 이하로 성능이 하락하는 현상을 관찰했다고 밝혔습니다. 반면 CLM은 경량 파인튜닝(Lightweight Fine-tuning)을 적용했을 때 난도 높은 에이전트 벤치마크인 DeepSWE에서 81.6%, Terminal-Bench 2.1에서 87.6%의 정확도를 기록하며 SOTA(State-of-the-Art) 성능을 달성했으며, 이 과정에서 Jev 대비 4~6배 빠른 추론 속도를 보였습니다.
3단계 데이터 레시피와 오픈소스 릴리스 및 실무 고려사항
CLM-8B의 학습은 체계적인 3단계 데이터 레시피를 바탕으로 진행되었습니다. 사전학습(Pre-training) 단계에서 6,000만 개의 네모트론(Nemotron) Q&A 쌍을 학습했고, 미드트레이닝(Mid-training) 단계에서 모델의 변별력을 끌어올리기 위한 3,000만 개의 합성 하드 네거티브(Synthetic Hard Negatives)를 주입했습니다. 이후 포스트트레이닝(Post-training) 단계에서 100만 개의 실제 에이전트 실행 궤적(Agentic Trajectories)을 반영해 정책 완성도를 높였습니다. 연구팀은 훈련 연산량, 데이터셋 크기, 모델 파라미터가 증가함에 따라 검증 손실(InfoNCE loss)이 거듭제곱 법칙(Power Law)을 따라 일정하게 감소하는 스케일링 법칙을 실증했다고 덧붙였습니다.
CLM-8B의 모델 가중치는 허깅페이스(Contrastive-LM/CLM-v0.1-8B)를 통해 내려받을 수 있으며, 추론 코드와 인터랙티브 플레이그라운드는 깃허브(Contrastive-LM/CLM) 저장소에 공개되었습니다. 연구팀은 현재 학습 중인 멀티모달 확장 모델 'CLM-35B'를 다음 달 초 추가 배포하여 일반화 역량과 처리 속도를 한 단계 더 끌어올리겠다고 예고했습니다.
다만 실무 도입 관점에서는 몇 가지 명확한 기술적 전제 조건을 구분해야 합니다. DeepSWE 81.6% 및 Terminal-Bench 2.1 87.6%의 고득점은 제로샷이 아닌 태스크별 경량 파인튜닝을 거친 결과입니다. 또한 9~13배에 달하는 대규모 속도 향상은 액션 공간이 사전에 고정되어 임베딩을 선제적으로 캐싱할 수 있는 워크로드에 집중되어 있으며, 매 턴마다 예측할 수 없는 임의의 액션 텍스트가 새롭게 생성되는 가변적 환경에서는 캐싱 이득이 상대적으로 제한될 수 있습니다. 아울러 Jev 대비 우위 지표는 연구팀의 자체 측정치인 만큼, 향후 제3자 개발자들의 독립적인 재현 및 엔터프라이즈 환경에서의 안정성 검증이 이어져야 할 것으로 평가됩니다.
출처
- Jacky Kwok 공식 X (@jackyk02): CLM 공식 발표 스레드
- Contrastive-LM GitHub 저장소: Contrastive-LM/CLM
- Hugging Face 모델 저장소: Contrastive-LM/CLM-v0.1-8B