16GB VRAM GPU에서 256K 멀티모달 비전 모델 Arete-27B 로컬 구동하기
RTX 4080이나 RTX 4070 Ti Super 같은 16GB 단일 GPU 환경에서 llama.cpp, FlashAttention, 8비트 KV 캐시를 조합해 256K 컨텍스트와 비전 프로젝터를 구동하는 실전 세팅 가이드입니다.
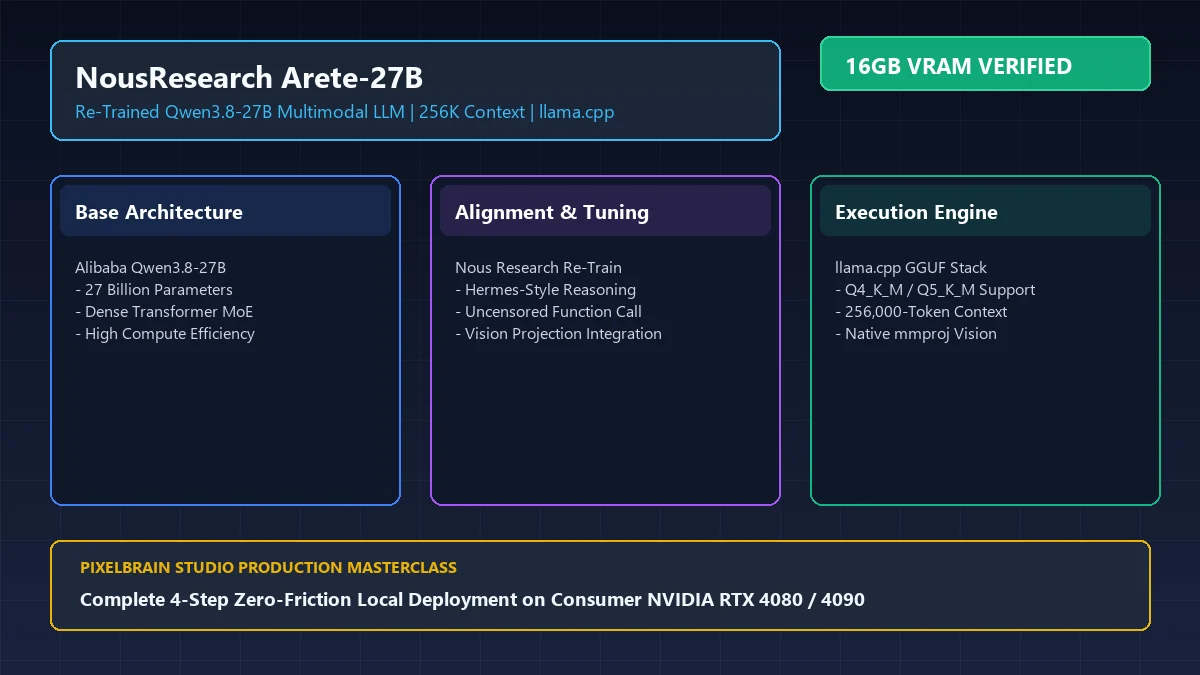
엔지니어 Rich Ng가 16GB VRAM 단일 그래픽카드 환경에서 2,700억 파라미터(27B)급 대형 멀티모달 모델인 Nous Research의 Arete-27B를 256K(262,144 토큰) 전체 컨텍스트와 함께 구동하는 상세 배포 가이드를 공유했습니다.
이미지 출처: Rich Ng / dev.to
그동안 고해상도 이미지 추론과 수백 쪽에 달하는 문서를 한 번에 입력하는 256K 초대형 컨텍스트는 폐쇄형 클라우드 API 독점 영역으로 여겨졌습니다. 하지만 알리바바의 Qwen3.8-27B 베이스 모델을 노우스 리서치(Nous Research)가 파인튜닝한 Arete-27B와 오픈소스 추론 엔진 llama.cpp의 최적화 기법을 결합하면 일반 데스크톱 PC 한 대에서도 외부 통신 없는 로컬 추론 환경을 구축할 수 있습니다.
Arete-27B 모델 아키텍처와 경량화 배경
Arete-27B는 베이스 모델인 Qwen3.8-27B의 탄탄한 기본 성능 위에 노우스 리서치 특유의 에르메스(Hermes) 정렬 데이터셋과 멀티턴 사고 연쇄(Chain-of-Thought)를 학습시킨 비전-언어 파운데이션 모델입니다. 기업용 안전 필터로 인해 코드 분석이나 시스템 취약점 점검 질의를 거부하던 상용 API와 달리 기술적인 추론을 가감 없이 수행하며, 도구 호출(Tool Calling)과 정형화된 JSON 추출에서 안정적인 응답을 냅니다.
시각 정보를 처리하는 방식도 기존 OCR(광학 문자 인식) 엔진을 별도로 거치는 파이프라인과 다릅니다. Arete-27B는 전용 멀티모달 프로젝터(mmproj) 가중치를 통해 이미지를 패치 단위 임베딩으로 변환한 뒤 언어 모델의 잠재 공간(Latent Space)에 직접 투영합니다. 덕분에 소프트웨어 아키텍처 다이어그램, UI 와이어프레임, 복잡한 재무 도표를 단일 순방향 추론(Forward Pass)으로 종합 분석할 수 있습니다.
일반 소비자용 16GB GPU에서 27B 모델을 구동하기 위한 핵심은 Q4_K_M 양자화(Quantization)입니다. 양자화는 모델의 가중치를 16비트 부동소수점에서 4비트 정수형으로 압축해 필요한 메모리를 줄이는 기법입니다. Q4_K_M 방식은 중요한 어텐션 가중치는 상대적으로 정밀하게 유지하고 피드포워드 신경망(FFN) 파라미터는 과감히 4비트로 줄이는 혼합 정밀도를 채택해, 압축하지 않은 원본 대비 성능 저하(Perplexity 손실)를 0.08 미만으로 억제하면서 모델 크기를 16.2GB 수준으로 묶어둡니다.
배포 전 하드웨어 및 실행 환경 점검
안정적인 256K 컨텍스트 구동을 위해 필요한 하드웨어 및 소프트웨어 요구 조건은 다음과 같습니다.
- GPU (그래픽카드): NVIDIA GeForce RTX 4080 (16GB) 또는 RTX 4070 Ti Super (16GB)를 권장합니다. 24GB VRAM을 갖춘 RTX 3090/4090 환경에서는 Q5_K_M 등 더 높은 정밀도 버전을 시스템 메모리 스필오버 없이 운용할 수 있습니다.
- CPU 및 시스템 메모리: AVX2 및 FMA3 명령어를 지원하는 8코어 16스레드 프로세서(Intel Core i7-13700K 또는 AMD Ryzen 7 7800X3D 급)와 최소 32GB 시스템 메모리를 권장합니다.
- 운영체제 및 드라이버: Windows 11 x64 (빌드 22621 이상) 또는 Ubuntu 22.04/24.04 LTS, NVIDIA 디스플레이 드라이버 550.00 이상.
- 스토리지: 초당 순차 읽기 속도가 빠른 NVMe SSD에 최소 35GB 이상의 여유 공간이 필요합니다.
4단계 실전 배포 절차
파이썬 가상환경 구축이나 복잡한 패키지 의존성 충돌 없이 C++ 네이티브 바이너리로 단시간에 서버를 올리는 4단계 워크플로우입니다.
1단계: llama.cpp CUDA 빌드 준비
공식 GitHub 배포 페이지에서 사전 컴파일된 최신 CUDA 12/13 바이너리 압축 파일(예: llama-b4000-bin-win-cuda-cu12.4-x64.zip)을 내려받습니다. NVMe SSD 드라이브에 작업 폴더(예: C:\AI\llama.cpp-arete\)를 생성하고 압축을 해제합니다. 실행 파일(llama-server.exe)이 위치한 폴더에 cudart64_12.dll과 ggml-cuda.dll이 정상적으로 함께 들어있는지 확인합니다.
2단계: 양자화 모델 가중치 및 비전 프로젝터 다운로드
작업 디렉터리 내부에 models 폴더를 만들고 허깅페이스(HuggingFace) 저장소에서 주 언어 모델 가중치와 비전 프로젝터 파일을 내려받습니다.
mkdir C:\AI\llama.cpp-arete\models
cd C:\AI\llama.cpp-arete\models

# 주 모델 Q4_K_M GGUF 가중치 다운로드 (16.2 GB)
curl -L -o Arete-27B-Q4_K_M.gguf "https://huggingface.co/bartowski/NousResearch_Arete-27B-GGUF/resolve/main/NousResearch_Arete-27B-Q4_K_M.gguf"

# 전용 멀티모달 비전 프로젝터 다운로드 (834 MB)
curl -L -o mmproj-Arete-27B-f16.gguf "https://huggingface.co/bartowski/NousResearch_Arete-27B-GGUF/resolve/main/mmproj-Arete-27B-f16.gguf"
3단계: 프로덕션 서버 실행 스크립트 작성
루트 폴더(C:\AI\llama.cpp-arete\)에 배치 실행 스크립트(start_server.bat)를 작성하고 아래 플래그 조합으로 서버를 가동합니다.
@echo off
title Arete-27B Multimodal 256K Production Server
cd /d %~dp0
llama-server.exe ^
  -m .\models\Arete-27B-Q4_K_M.gguf ^
  --mmproj .\models\mmproj-Arete-27B-f16.gguf ^
  -c 262144 ^
  -ngl 33 ^
  --flash-attn ^
  --port 8085 ^
  --host 0.0.0.0 ^
  --threads 8
pause
핵심 매개변수의 역할은 다음과 같습니다.
-c 262144: 컨텍스트 버퍼를 256K(262,144 토큰) 전체 크기로 할당합니다.-ngl 33: Arete-27B의 전체 33개 트랜스포머 레이어를 GPU VRAM에 완전히 오프로드합니다.--flash-attn: 타일 기반 SRAM 연산 커널을 활성화해 거대한 어텐션 행렬을 전역 메모리에 통째로 전개하지 않도록 막아주며, 피크 VRAM 사용량을 70% 이상 절감합니다.
4단계: 8비트 KV 캐시 양자화 추가 옵션과 웹 UI 접속
256K 길이를 극단적으로 채워 쓸 때 VRAM 부족(OOM) 오류가 우려된다면 배치 실행 명령에 -ctk q8_0 -ctv q8_0 플래그를 추가합니다. 이 옵션은 모델이 문맥을 기억하는 데 쓰는 Key-Value(KV) 캐시 텐서를 실행 중에 8비트 정밀도로 실시간 압축합니다. 표준 FP16 형식 대비 메모리 점유율을 5.8GB 언더로 묶어주면서도 긴 문서 검색 정확도는 그대로 유지합니다.
콘솔 창에 HTTP server listening on 0.0.0.0:8085 문구가 나타나면 서버가 정상 가동된 상태입니다. 웹 브라우저에서 http://localhost:8085/로 접속해 내장 GUI를 사용하거나 Open WebUI 또는 OpenAI 표준 규격 클라이언트에 엔드포인트를 연결해 텍스트와 이미지 입력 작업을 시작할 수 있습니다.