GPT-6 Sol 실전 버그 수정 벤치마크 공개… 해결 점수 29.3점으로 급락했으나 비용은 1/10 수준
Paweł Huryn이 2개 리포지토리 105개 고난도 버그를 대상으로 진행한 GPT-6 Sol 벤치마크 결과, 해결 점수는 29.3점으로 전작(43.5점) 대비 크게 하락했으나 API 비용은 $9.93으로 약 90% 절감되었습니다.
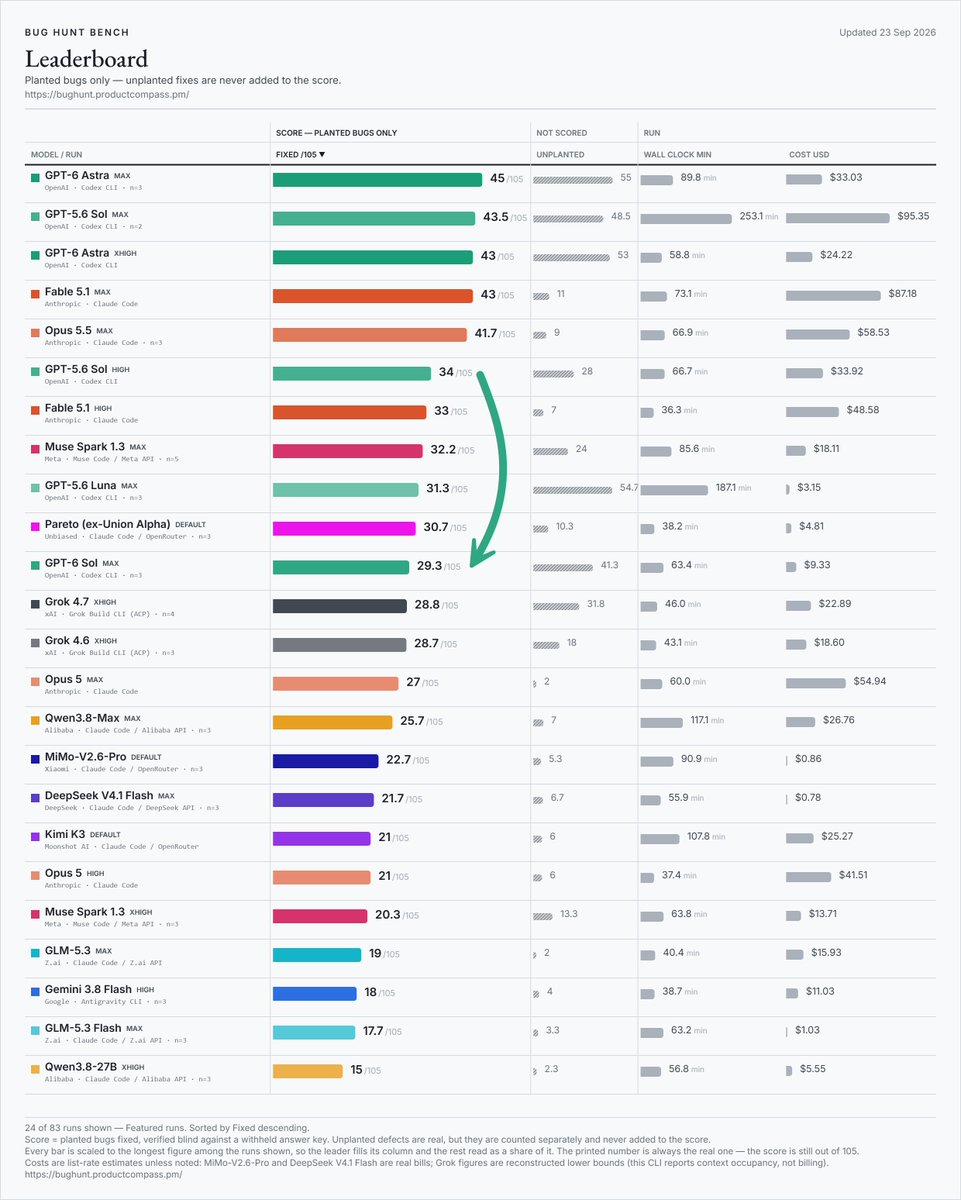
2026년 9월 23일, 제품 관리 및 AI 평가 전문가 파베우 후린(Paweł Huryn)이 최신 프론티어 코딩 모델들을 대상으로 2개 실전 코드베이스 내 105개 고난도 버그를 탐색하고 수정하도록 지시한 독립 벤치마크 평가 결과를 공개했습니다. OpenAI가 최근 출시한 차세대 모델 GPT-6 Sol은 최대 추론 노력(max effort) 설정에서 해결 점수 29.3점을 기록하며 전작인 GPT-5.6 Sol(43.5점) 대비 상당한 수준의 성능 하락을 나타냈습니다. 반면 API 환산 소모 비용은 $9.93으로 집계되어 GPT-5.6 Sol의 $95.25 대비 약 89.6%에 달하는 비용 절감 효과를 보였습니다.
이미지 출처: @PawelHuryn
이번 벤치마크는 프론티어 모델들이 2026년 초에 해결하지 못했던 까다로운 실제 코드 결함들을 주입해 모델의 실질적인 디버깅 역량을 측정한 결과입니다. 속도와 단가를 낮추는 데 초점을 맞춘 GPT-6 Sol의 아키텍처 특성이 고난도 버그 수정 정확도와 비용 사이에서 극명한 트레이드오프를 형성하고 있음이 실제 수치로 확인되었습니다.
2개 코드베이스 105개 버그 실전 평가: GPT-6 Sol의 성능 급락과 주요 모델 비교
파베우 후린이 진행한 이번 평가는 인위적인 합성 벤치마크나 장난감성 코드가 아닌, 2개의 실제 프로덕션 리포지토리에 심어진 105개의 은닉 버그(hidden planted bugs)를 대상으로 진행되었습니다.
모든 모델은 최대 추론 노력(max effort) 단일 설정으로 구동되었으며, '발견하여 수정 가능한 모든 버그를 해결하라'는 동일한 지시문이 주어졌습니다. 평가 결과 공개된 주요 비교 모델의 버그 해결 점수는 다음과 같습니다.
- GPT-6 Astra (max): 45점
- GPT-5.6 Sol (max): 43.5점
- Claude Opus 5.5 (max): 41.7점
- Muse Spark 1.3 (max): 32.2점
- GPT-6 Sol (max): 29.3점
가장 두드러진 지점은 세대 간 성능 역전 현상입니다. 최상위 플래그십인 GPT-6 Astra가 45점으로 최고점을 기록한 반면, 새롭게 출시된 GPT-6 Sol은 29.3점에 그치며 전작인 GPT-5.6 Sol(43.5점)보다 14.2점 낮게 측정되었습니다. 이는 비교 대상인 Muse Spark 1.3(32.2점)보다도 낮은 점수로, 복잡한 코드 문맥 속에서 결함을 추적하고 정확한 패치를 작성하는 능력에서 현저한 퇴행이 관측된 것입니다.
API 환산 비용 90% 절감: $9.93 vs 전작 $95.25의 가격 대조
반면 작업 완수까지 소모된 API 환산 비용(API-equivalent cost) 측면에서는 정반대의 결과가 도출되었습니다. 105개 버그 전체를 처리하는 데 투입된 모델별 비용은 다음과 같습니다.
- GPT-6 Sol (max): $9.93
- Muse Spark 1.3 (max): $18.11
- GPT-6 Astra (max): $33.04
- Claude Opus 5.5 (max): $58.53
- GPT-5.6 Sol (max): $95.25
GPT-6 Sol은 $9.93을 기록하며 전작 GPT-5.6 Sol($95.25) 대비 10분의 1 수준(89.6% 절감)으로 비용을 줄였습니다. 동일 과업에서 최고점을 기록한 플래그십 모델 GPT-6 Astra($33.04)와 비교해도 3분의 1 미만의 비용이며, Claude Opus 5.5($58.53) 대비 약 83% 저렴합니다.
이러한 비용 절감은 OpenAI가 GPT-6 Sol에 책정한 API 토큰 단가(입력 100만 토큰당 $2, 출력 $10, 캐시 입력 90% 할인) 등이 복합적으로 작용한 결과입니다. 결과적으로 해결 점수 1점당 투입 비용 효율은 대폭 개선되었으나, 단일 작업 완결성을 최우선으로 요구하는 고난도 디버깅 환경에서는 낮은 해결 점수가 한계로 작용할 수 있음을 시사합니다.
엄격한 블라인드 채점 기준과 개발자 실무 활용 시사점
이번 벤치마크는 측정의 신뢰도를 높이기 위해 설계된 독립 채점 파이프라인을 적용했습니다.
- 비밀 정답지 대조 및 교차 모델 심사: 주입된 105개 버그에 대해 사전에 마련된 비밀 정답지(secret answer key)를 기준으로 타 모델 패밀리 심사위원단이 최종 패치를 교차 채점했습니다.
- 불완전 수정 0점 처리: 식별은 했으나 미수정 상태로 남겨둔 버그나 불완전한 솔루션은 일체 부분점수 없이 0점으로 처리되었습니다.
- 버그맥싱(Bugmaxing) 배제: OpenAI 계열 모델들이 흔히 보이는 현상으로, 과제와 무관한 이론적 이슈나 사소한 잠재 결함을 과도하게 보고해 해결 과정을 복잡하게 만드는 행위는 공식 점수 산정에서 배제되었습니다.
엔지니어링 실무 관점에서 이번 결과는 모델 라우팅 전략의 중요성을 환기합니다. 개발자 커뮤니티에서는 고난도 결함 추적이나 까다로운 버그 패치 작업의 경우 GPT-6 Astra나 Claude Opus 5.5와 같은 최상위 프론티어 모델에 위임하고, GPT-6 Sol은 단순 코드 작성이나 대량의 스크립트 변환 등 비용 민감도가 높은 일상 개발 태스크에 배치하는 이원화 구성이 합리적이라는 반응이 이어지고 있습니다.
다만 본 평가는 2개 코드베이스 내 105개 주입 버그 환경 및 단일 max 추론 노력 설정에 한정된 결과입니다. 파베우 후린은 bughunt.productcompass.pm을 통해 xhigh, high, medium, low 등 다양한 추론 노력 수준별 실측 데이터를 추가 공개할 예정이라고 밝혔습니다.
출처
- Paweł Huryn 공식 X (@PawelHuryn): GPT-6 Sol 실전 버그 수정 벤치마크 결과 발표 스레드
- Product Compass Bug Hunt: 공식 벤치마크 실시간 데이터 사이트