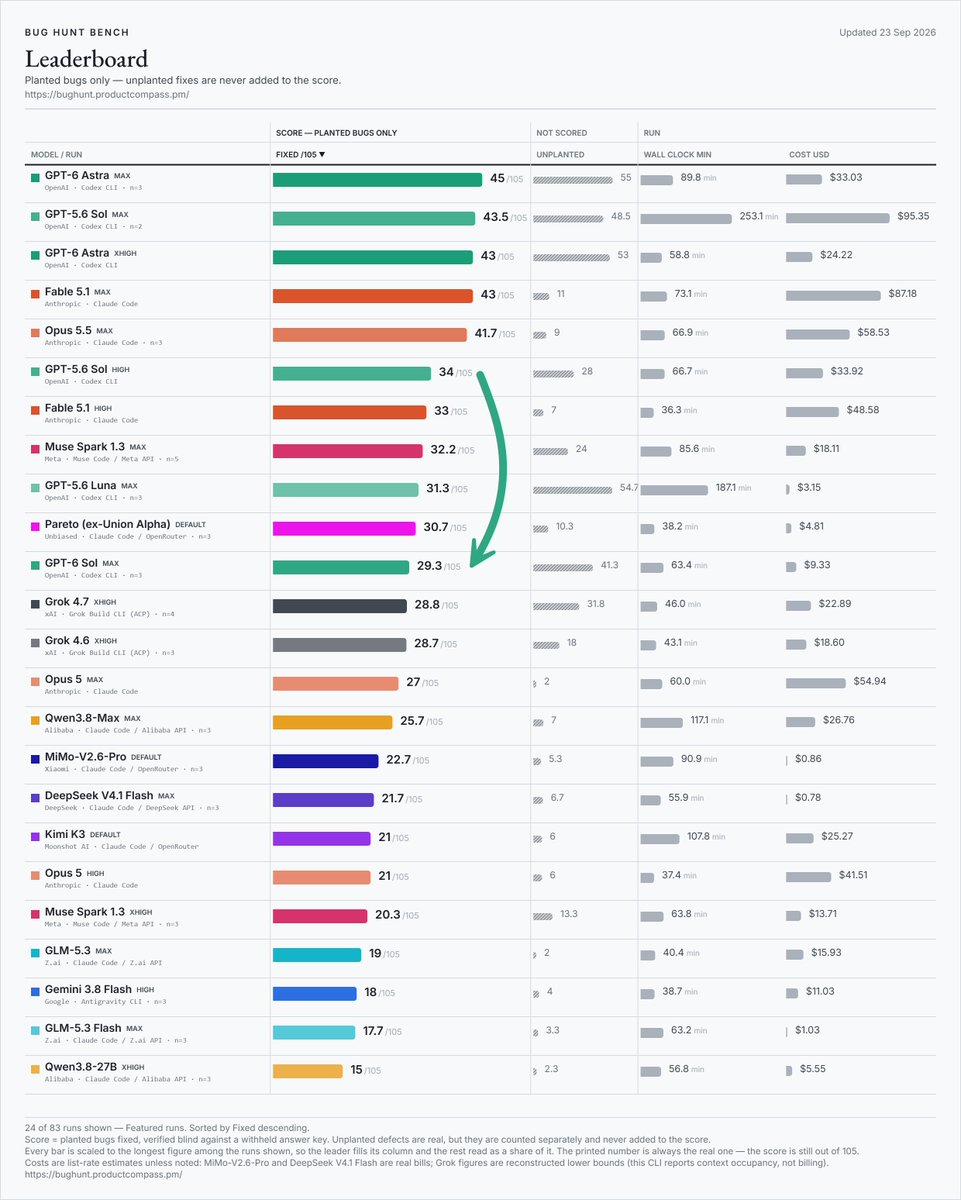
GPT-6 Sol 실전 버그 수정 벤치마크 공개… 해결 점수 29.3점으로 급락했으나 비용은 1/10 수준
Paweł Huryn이 2개 리포지토리 105개 고난도 버그를 대상으로 진행한 GPT-6 Sol 벤치마크 결과, 해결 점수는 29.3점으로 전작(43.5점) 대비 크게 하락했으나 API 비용은 $9.93으로 약 90% 절감되었습니다.
TAU HOME에서 GPT6Sol 태그로 묶인 글입니다.
Paweł Huryn이 2개 리포지토리 105개 고난도 버그를 대상으로 진행한 GPT-6 Sol 벤치마크 결과, 해결 점수는 29.3점으로 전작(43.5점) 대비 크게 하락했으나 API 비용은 $9.93으로 약 90% 절감되었습니다.
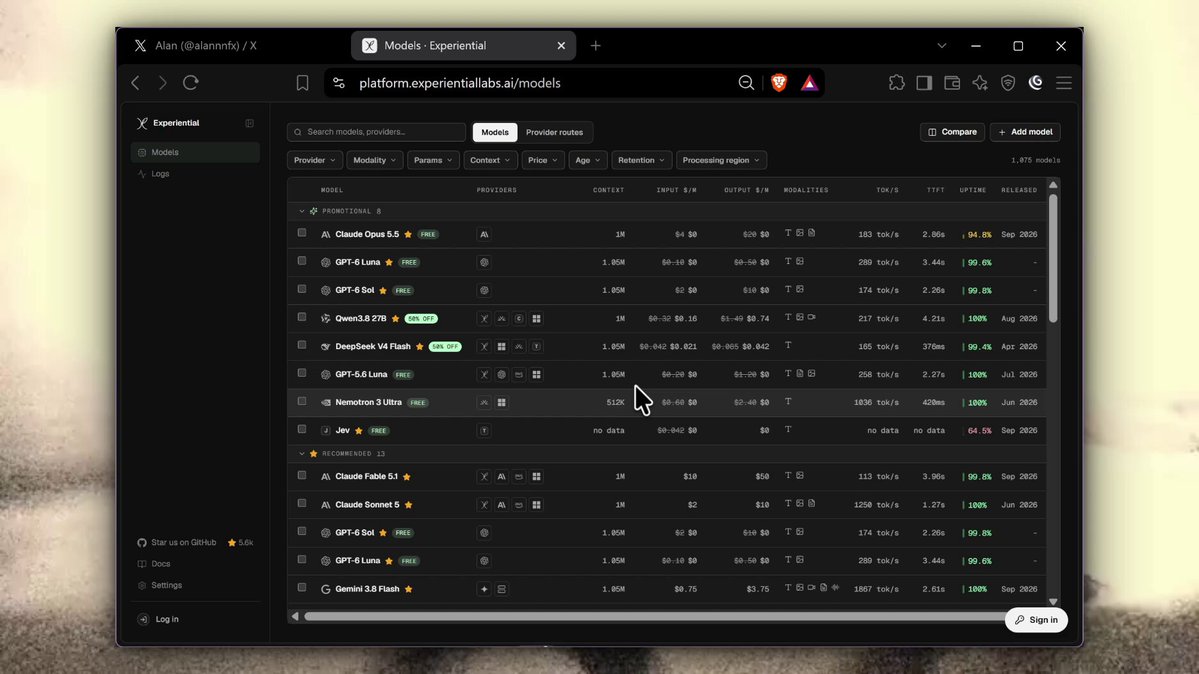
Anthropic의 신규 Claude Opus 5.5와 OpenAI GPT-6 Sol 및 Luna 모델을 Experiential Labs 플랫폼에서 OpenAI 호환 클라이언트로 무료 연결하여 테스트하는 3단계 실전 팁입니다.
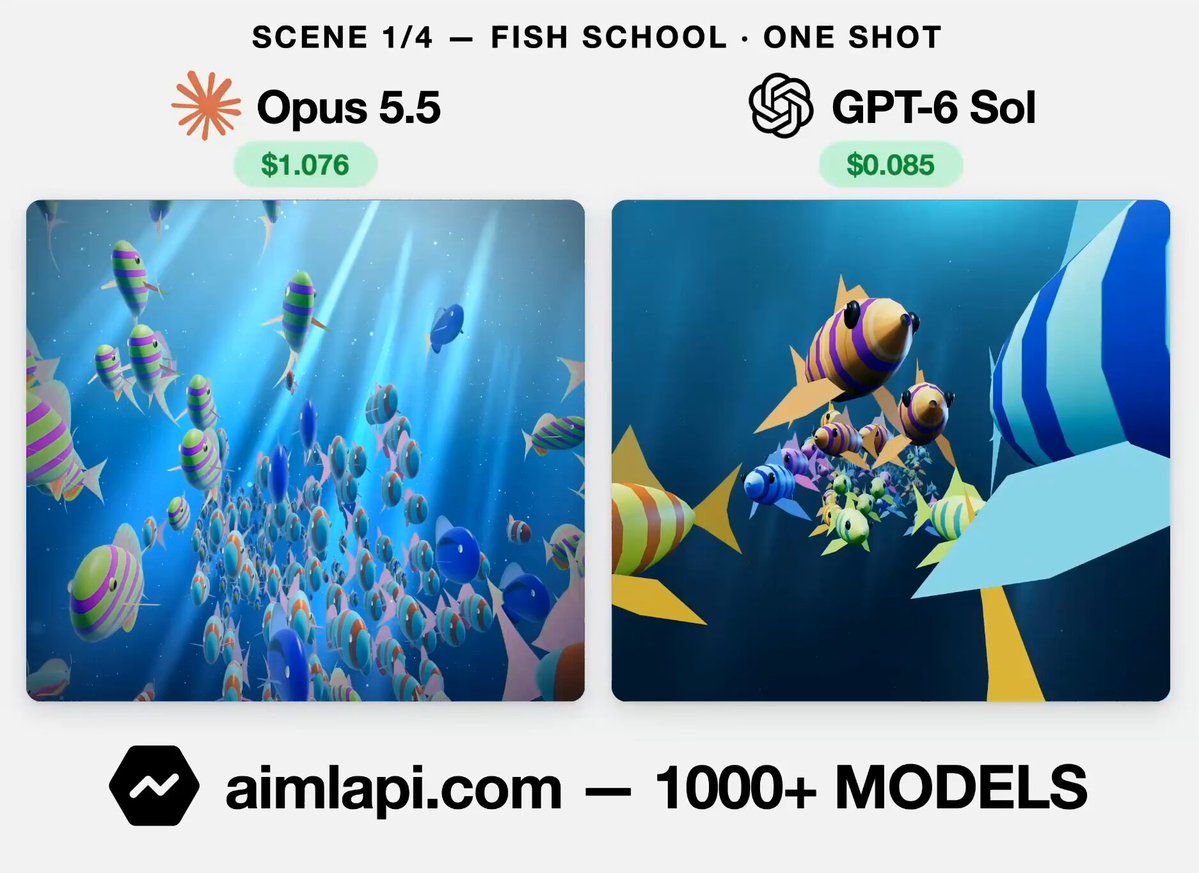
AI/ML API 팀이 진행한 원샷 3D 씬 생성 테스트에서 Claude Opus 5.5는 4개 씬 4.37달러로 정교한 렌더링을 산출한 반면, GPT-6 Sol은 0.34달러를 기록했습니다. 3D 그래픽 품질과 추론 비용 간의 실측 트레이드오프를 분석합니다.