30개 이상 의사결정 모델을 13만 개 문항으로 검증한 'Decision Index 0.1' 벤치마크 리더보드 공개
허깅페이스의 @multimodalart가 Jev와 30개 이상의 오픈웨이트 의사결정 모델을 37개 벤치마크와 모델당 130K 결정으로 심층 평가한 'Decision Index 0.1' 리더보드를 공개했습니다.
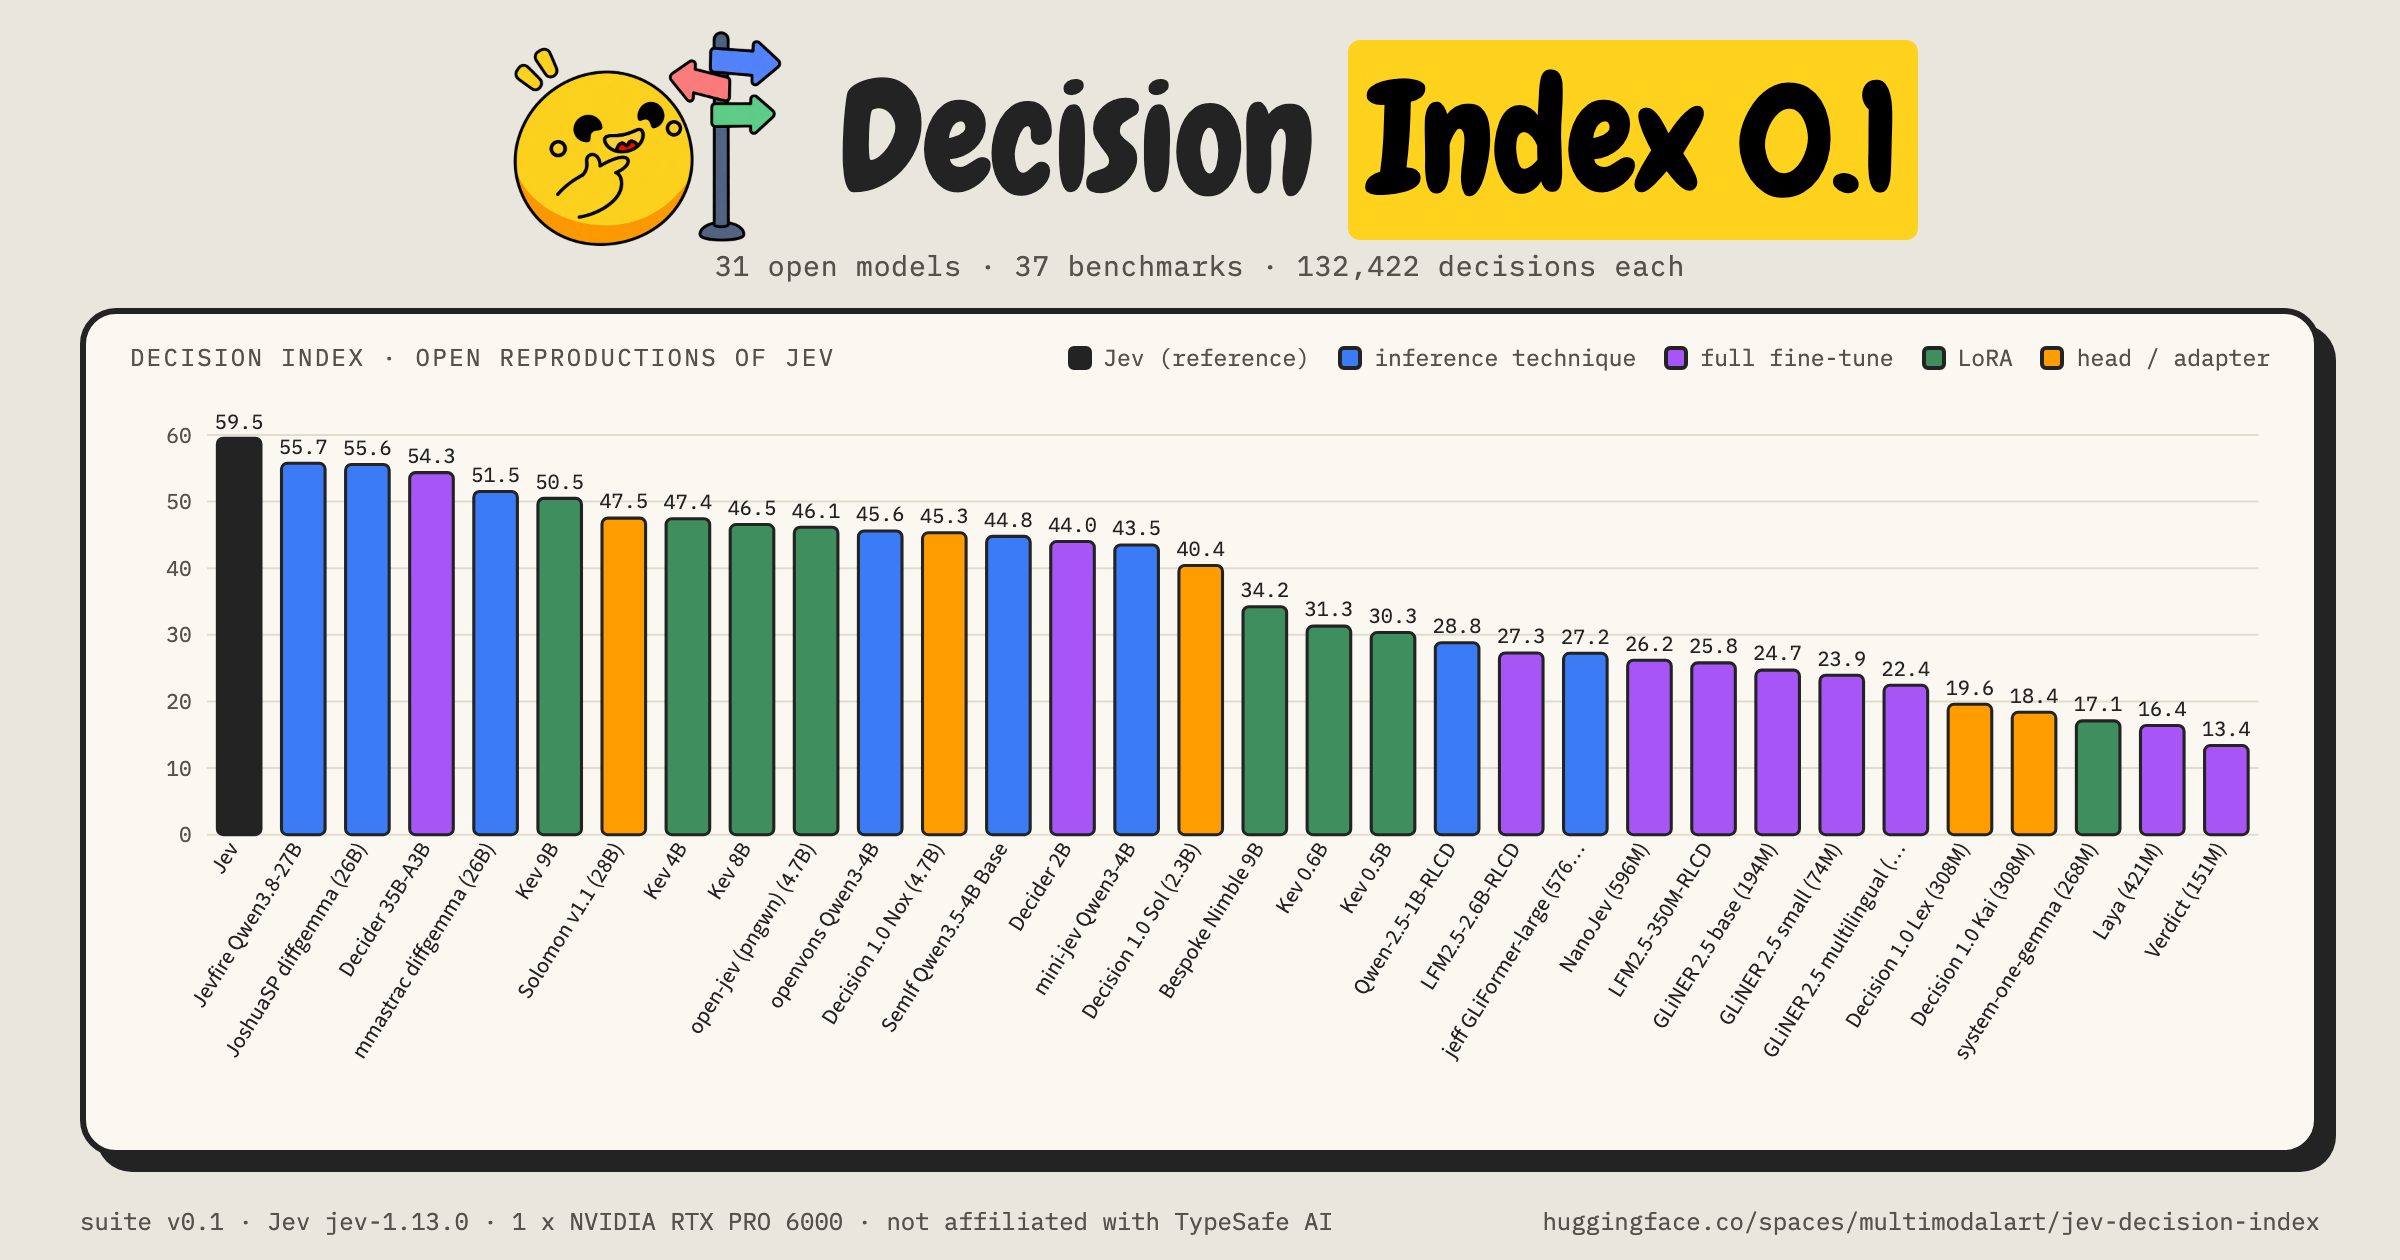
2026년 9월 22일, 허깅페이스(Hugging Face)의 머신러닝 리서처인 아폴리나리오 파소스(@multimodalart, Apolinário Passos)가 상용 의사결정 모델인 Jev와 30개 이상의 오픈웨이트(Open-weights) 의사결정 모델을 다각도로 비교 평가한 벤치마크 리더보드 'Decision Index 0.1'을 전격 공개했습니다. 이번 벤치마크는 5개 핵심 범주에 걸친 37개 세부 지표를 바탕으로 각 모델당 13만 건(130K)에 달하는 의사결정 질의를 수행하여 실전 도구 호출과 시스템 자동화 역량을 엄밀하게 검증했습니다.
이미지 출처: apolinario (@multimodalart) / Hugging Face
이번 리더보드는 기존 텍스트 생성 중심의 LLM 평가와 달리, 구조화된 함수 호출, 에이전트 라우팅, 경량 자동화 등 '의사결정 특화 모델'의 실질적 성능을 집중 분석하기 위해 구축되었습니다.
37개 벤치마크와 13만 회 결정: RTX 6000 PRO 단일 환경의 엄격한 비교
Decision Index 0.1의 가장 큰 방법론적 특징은 하드웨어와 실행 조건의 철저한 표준화, 그리고 초기 벤치마크 포화(saturation)를 차단하기 위한 고난도 설계입니다.
공정한 성능 비교를 위해 모든 참가 모델은 단일 하드웨어 규격인 1대의 엔비디아 RTX 6000 PRO 환경에서 동일하게 구동되었습니다.
- 5대 평가 범주와 37개 벤치마크: 지식(Knowledge), 자동화 및 도구 사용(Automation & Tool Use), 이해력(Comprehension), 창의성(Creativity)을 포함한 5개 범주를 망라하며, 각 모델은 총 130,000건의 의사결정 질의를 거쳤습니다.
- 포화 방지형 고난도 설계: 모델들이 손쉽게 만점을 기록하여 변별력을 잃지 않도록 벤치마크의 초기 난이도를 높게 설정했습니다.
- 재현성 및 투명성: 벤치마크의 전체 방법론 문서(
methodology.html), 소스 코드, 평가 데이터셋과 모델 확률 예측의 신뢰도를 측정하는 캘리브레이션(Calibration) 지표까지 모두 오픈소스로 공개되어 누구나 결과를 검증하고 재현할 수 있습니다.
지식 우위와 좁혀진 도구 실행 격차: 단일 패스 Qwen3.8과 Decider 35B
13만 건의 벤치마크 집계 결과, 종합 지식 영역에서는 Jev가 여전히 오픈 모델 진영에 대해 유의미한 점수 격차로 선두를 유지했습니다. 아폴리나리오는 이것이 Jev의 베이스 모델 규모가 더 큰 영향일 것으로 추정했습니다. 특히 Jev는 대학원 수준의 지식 기반 질의, 파이썬 함수 선택(Python function choosing), 도구 호출(Tool calling), 에이전트 모델 라우팅(Model routing) 과제에서 매우 탁월한 판단력을 보였습니다.
그러나 에이전트 실무에서 가장 중요한 도구 사용(Tool use), 자동화(Automation), 정보 검색(Retrieval), 데이터 분류(Classification) 영역에서는 오픈웨이트 모델들과의 성능 격차가 급격히 좁혀진 것으로 나타났습니다.
- Jev 뒤를 잇는 최상위 오픈 기법: 추가 파인튜닝 없이 단일 패스(One-pass) 추론을 가능하게 한 Jevfire의 Qwen3.8-27B 구현체와 디퓨전 젬마(Diffusion Gemma) 기반 기법이 Jev의 바로 뒤를 추격하며 최상위권을 형성했습니다.
- 3위 Decider 35B-A3B: Qwen3.5-35B 베이스 모델을 정밀하게 파인튜닝한 Decider 35B-A3B가 3위에 안착하며 강력한 의사결정 역량을 입증했습니다.
파라미터 체급별 선두 모델과 의사결정 모델의 도전 과제
이번 평가는 모델 파라미터 규모별 세부 구간에 따른 최적의 오픈 의사결정 모델 라인업도 함께 제시했습니다.
- 350M 미만 초소형 구간: Fastino(@fastinoAI)의 GLiNER 2.5가 선두를 차지하며 초경량 엣지 환경에 적합한 성능을 기록했습니다.
- 350M
700M 및 3B10B 구간: Jared Palmer(@jaredpalmer)의 Kev 패밀리가 두 개 구간 모두에서 1위를 기록했습니다. - 3B 미만 구간: @notmapika의 Decider 2B가 3B 미만 최적점(sweet spot)으로 꼽혔습니다.
- 성능 대 지연 시간(Pareto Frontier): 뛰어난 속도와 체급 대비 우수한 결정을 겸비한 openvons의 Qwen3-4B와 Matthew Mastracci(@mmastrac)의 디퓨전 젬마 Jev-like 구현체가 파레토 최적선에 올랐습니다.
반면 벤치마크 과정에서 드러난 특정 과제 영역의 한계도 함께 공유되었습니다.
- Jev가 어려움을 겪은 과제 영역: Jev는 체스와 같은 퍼즐 및 전략 게임에서 여전히 큰 어려움을 겪었습니다. 또한 심층적인 추론 모델이 요구되는 고난도 문서 검색, 악보 기반 코드 인식, 정밀한 감정 분석 과제에서도 상대적으로 취약한 성능을 나타냈습니다.
- 동일 하드웨어 기준: 모든 평가 수치는 참가 모델 전원에 대해 단일 RTX 6000 PRO 환경에서 동일하게 측정되었습니다.
출처
- Hugging Face Spaces: Decision Index 0.1 Leaderboard
- Hugging Face Methodology: Decision Index Methodology
- Apolinário Passos Official X (@multimodalart): Decision Index 0.1 Announcement Thread