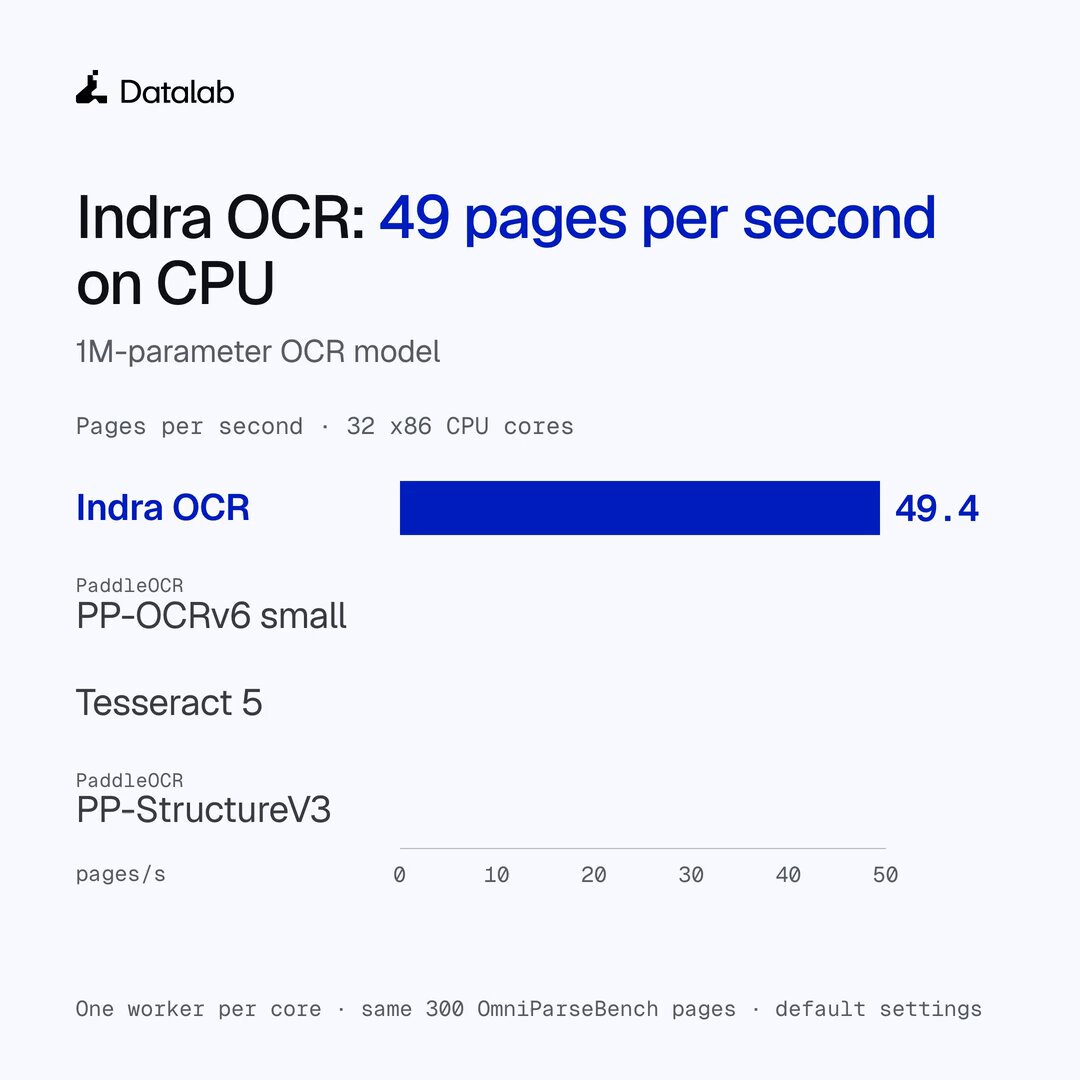
초경량 1M 파라미터 OCR 모델 'Indra' 공개… CPU서 초당 49페이지 처리
Vik Paruchuri가 100만 파라미터 크기의 초경량 OCR 모델 Indra를 공개했습니다. CPU 환경에서 초당 49페이지를 처리해 PaddleOCR 대비 11배 빠르며, 60개 언어와 수식 모드를 지원해 RAG 및 실시간 인덱싱 파이프라인에 최적화되었습니다.
TAU-HOME.COM에서 RAG 태그로 묶인 글입니다.
Vik Paruchuri가 100만 파라미터 크기의 초경량 OCR 모델 Indra를 공개했습니다. CPU 환경에서 초당 49페이지를 처리해 PaddleOCR 대비 11배 빠르며, 60개 언어와 수식 모드를 지원해 RAG 및 실시간 인덱싱 파이프라인에 최적화되었습니다.
구글이 텍스트·코드·이미지·비디오·오디오를 단일 모델에서 임베딩하는 740M 파라미터 경량 오픈 모델 EmbeddingGemma 2를 발표하고 허깅페이스에 가중치를 공개했습니다.
LlamaIndex가 문서 파싱 모델 10종을 하나의 API로 묶은 OpenDocRouter를 출시했습니다. 한 줄로 모델을 교체하고 ParseBench 점수로 품질과 비용을 비교하는 구조를 정리합니다.
X 사용자 @DivyanshT91162가 공유한 문서 파싱 저장소 목록 중 공식 저장소로 확인된 Unstructured와 Docling의 실제 기능과 설치법을 정리했습니다.
Node.js 및 Python 기반 Crawlee부터 Scrapy, Crawl4AI까지 대규모 데이터 수집과 봇 탐지 우회, LLM 파이프라인 연계를 위한 핵심 오픈소스 스크래핑 도구 10종의 특성과 아키텍처를 비교 분석합니다.
Perplexica, SearXNG, Meilisearch, Qdrant, Weaviate 등 자체 AI 검색 및 RAG 시스템 구축에 활용할 수 있는 핵심 오픈소스 10가지 저장소 정리.
수백 페이지 분량의 대형 PDF 문서를 Claude Code 컨텍스트에 직접 넣어 발생하는 막대한 토큰 비용과 환각을 방지하기 위해, 구글 NotebookLM에 문서를 업로드하고 MCP로 연결하여 소스 기반 검색을 수행하는 단계별 팁입니다.
1M 토큰 창을 무작정 채우지 않고 에이전트의 결정에 꼭 필요한 최소 컨텍스트만 주입하기 위한 Context7, Serena, Repomix 등 10개 오픈소스 도구 분류와 목적별 파이프라인 조합 가이드.
FastAPI, OpenSearch 2.19 하이브리드 검색, Docling 논문 파싱, Airflow 파이프라인, LangGraph 에이전틱 라우팅과 Langfuse 모니터링까지 실무 RAG 아키텍처를 단계별로 구현하는 오픈소스 엔지니어링 시스템입니다.
클론하여 즉시 배포 가능한 100개 이상의 오픈소스 AI 에이전트, RAG 앱, 에이전트 스킬을 제공하는 저장소입니다. 다양한 LLM을 지원하며 Apache-2.0 라이선스로 배포됩니다.
텐센트의 오픈소스 LLM 지식 플랫폼 WeKnora가 v0.8.0을 발표했습니다. 세션별 샌드박스 격리 런타임, 사용자 확인 기반 크로스 세션 장기 기억, 테넌트 스킬 카탈로그 자산화 등 에이전틱 RAG로 진화한 핵심 변경 사항을 정리합니다.
Impact-Site-Verification: 9b3ebd10-6c45-44cf-a014-5b8c19b7b285