초경량 1M 파라미터 OCR 모델 'Indra' 공개… CPU서 초당 49페이지 처리
Vik Paruchuri가 100만 파라미터 크기의 초경량 OCR 모델 Indra를 공개했습니다. CPU 환경에서 초당 49페이지를 처리해 PaddleOCR 대비 11배 빠르며, 60개 언어와 수식 모드를 지원해 RAG 및 실시간 인덱싱 파이프라인에 최적화되었습니다.
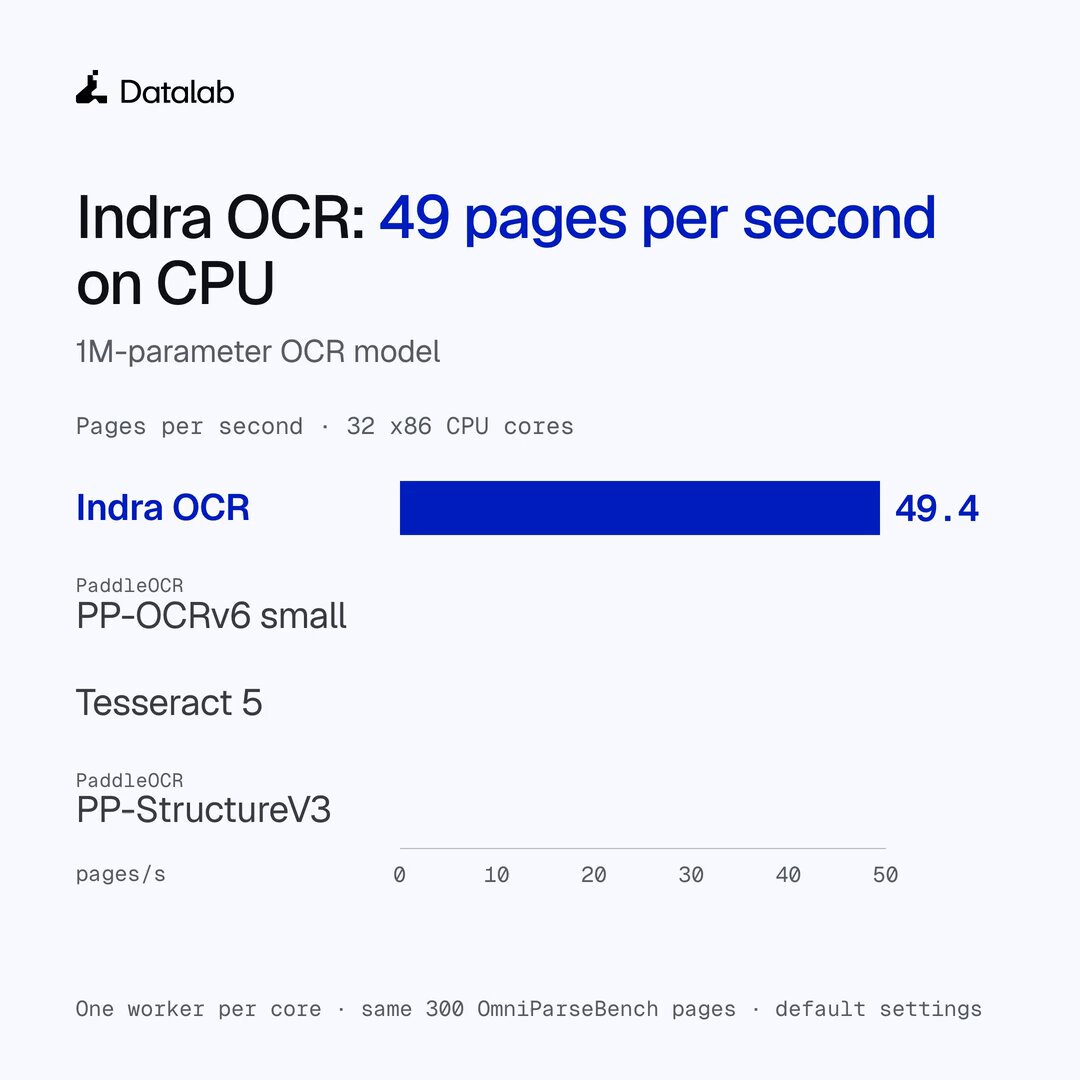
2026년 10월 14일, 머신러닝 개발자이자 연구자인 빅 파루추리(Vik Paruchuri)가 단 100만(1M) 개의 파라미터로 구동되는 초경량 광학 문자 인식(OCR) 모델 '인드라(Indra)'를 오픈소스로 전격 공개했습니다. 이번 모델은 고가의 GPU 인프라 없이 일반 CPU 환경에서도 초당 49페이지의 고속 문서 처리가 가능하도록 설계되었습니다.
이미지 출처: @VikParuchuri (X)
인드라는 검색 증강 생성(RAG) 데이터 수집, 실시간 검색 인덱싱, 대규모 비전-언어 모델(VLM) 투입 전 문서 선별(triage) 등 초저지연 처리가 필수적인 프로덕션 파이프라인을 정조준한 모델입니다. 허깅페이스(Hugging Face)와 깃허브(GitHub)에 가중치와 소스코드가 완전 공개되어 누구나 로컬 환경에서 즉시 구동할 수 있습니다.
CPU 환경 초당 49페이지 처리: PaddleOCR 대비 11배 빠른 저지연 아키텍처
인드라의 가장 핵심적인 강점은 극도로 작은 파라미터 크기(1M)에서 비롯되는 압도적인 추론 속도입니다.
개발자가 공개한 벤치마크 결과에 따르면, 인드라는 표준 CPU 환경에서 초당 49페이지(49 pages/s)를 처리하는 성능을 기록했습니다. 이는 기존 오픈소스 OCR 진영에서 널리 활용되던 패들OCR(PaddleOCR) 대비 11배, 테서랙트(Tesseract) 대비 17배 빠른 처리 속도입니다.
- 속도 비교: CPU 환경 초당 49페이지 처리 (PaddleOCR 대비 11배, Tesseract 대비 17배)
- 텍스트 인식 정확도(OmniParseBench text): 41.3점을 기록하여 PaddleOCR(35.8점) 및 Tesseract(19.3점)를 모두 상회
- 구조화 데이터 추출: 단순 텍스트 추출에 그치지 않고, 전체 문서 레이아웃 분석 및 행(line) 단위 바운딩 박스(Bounding Box) 좌표를 동시 산출
이러한 특성 덕분에 방대한 양의 PDF나 스캔 문서를 벡터 데이터베이스에 실시간으로 적재해야 하는 대규모 RAG 인제스천 환경에서 CPU 부하를 최소화하면서 파이프라인 처리량을 비약적으로 끌어올릴 수 있습니다.
6개 문자 체계·60개 언어 지원과 전용 수식(Math) 모드 탑재
극소형 경량화 모델임에도 불구하고 다국어 지원 범위와 특수 포맷 대응력도 체계적으로 갖추었습니다.
인드라는 6개 주요 문자 체계(라틴 문자, 키릴 문자, 그리스 문자, 데바나가리 문자, 벵골 문자, 중국어)를 포함해 총 60개 언어의 텍스트 인식을 지원합니다. 아울러 PDF 파일의 내장 텍스트 레이어에 포함된 모든 문자 스크립트를 파싱할 수 있는 유연성을 제공합니다.
- 지원 문자 체계: Latin, Cyrillic, Greek, Devanagari, Bengali, Chinese 등 6대 스크립트 기반 60개 언어 지원
- 수식 전용 모드(Math Mode): 과학·공학 학술 논문 및 기술 문서에 빈번히 등장하는 수학 수식을 정밀하게 파싱할 수 있는 특화 모드 제공
- 로컬 뷰어 및 설치 편의성:
pip install indra-ocr명령어 하나로 파이썬 환경에 설치할 수 있으며, 함께 제공되는 GUI 도구인indra-ocr-viewer를 실행해 즉시 속도 측정 및 세부 설정을 시각적으로 테스트 가능
1M 파라미터의 한계와 실무 파이프라인 활용 가이드
100만 파라미터라는 초경량 크기는 속도 면에서 강력한 이점을 제공하지만, 모델 체급에 따른 현실적인 성능 한계도 명확히 존재합니다.
빅 파루추리는 공식 발표를 통해 인드라가 모든 복잡한 문서 작업을 대체하기 위한 모델이 아니라는 점을 분명히 밝혔습니다.
- 인식 한계 영역: 복잡한 손글씨(handwriting), 다중 열과 병합 셀이 얽힌 복합 표(complex tables), 대형 페이지 처리에서는 텍스트 인식률이 저하될 수 있습니다.
- 다중 페이지 문맥 미반영: 단일 페이지 단위 분석 구조로 인해, 여러 페이지에 걸쳐 이어지는 대형 표의 헤더 유지나 페이지 간 연결 문맥은 파악하지 못합니다.
- 다단계 선별(Triage) 파이프라인 권장: 일상적인 문서, 정형화된 본문, 대량 스캔 데이터는 인드라를 통해 CPU에서 저비용·초고속으로 1차 처리하고, 인식 신뢰도가 낮거나 복잡도가 높은 페이지에 한해 상위 모델인 찬드라(Chandra-OCR-2) 등 대형 OCR·VLM 모델로 라우팅하는 2단계 파이프라인 구성이 권장됩니다.
현재 모델과 소스코드는 허깅페이스(datalab-to/indra-ocr)와 깃허브(datalab-to/indra)를 통해 자유롭게 이용할 수 있으며, 개발팀은 향후 지원 언어 확장과 인식 정확도 개선을 위한 후속 업데이트를 이어갈 예정입니다.
출처
- Vik Paruchuri 공식 X (@VikParuchuri): Indra OCR 릴리즈 공지
- DataLab 공식 블로그: Indra OCR Announcement
- Hugging Face 모델 저장소: datalab-to/indra-ocr
- GitHub 코드 저장소: datalab-to/indra
- 고난도 문서용 상위 모델: datalab-to/chandra-ocr-2