RTX 4090 한 장으로 125B MoE 돌리기: Qwen3.8-Flash-Next 하이브리드 추론 보고
125B MoE Qwen3.8-Flash-Next를 RTX 4090 한 장과 시스템 RAM 오프로드로 구동했다는 커뮤니티 보고의 핵심 조건과 주의점을 검증했습니다.
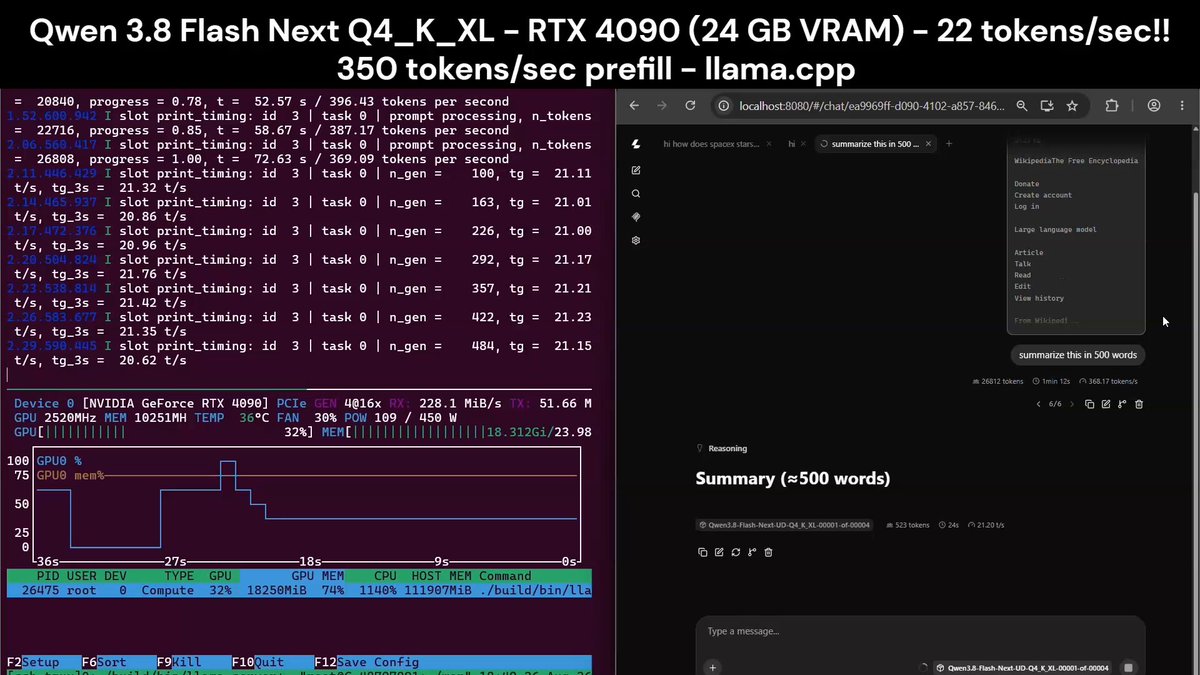
X 사용자 @Oluwaphilemon1(FHILY)이 2026년 10월 3일, 125B급 MoE 모델 Qwen3.8-Flash-Next를 RTX 4090 한 장과 시스템 RAM 오프로드로 구동했다는 커뮤니티 보고를 정리했습니다. 보고된 수치는 약 21 tok/s 디코드, 약 364 tok/s 프리필, 250K 컨텍스트이며, 이는 공식 벤치마크가 아닌 제3자 보고입니다.
이미지 출처: X @Oluwaphilemon1 게시물 첨부 영상
이 보고가 말하는 핵심은 "125B 전체가 4090 안에 들어간다"가 아니라, 희소 MoE 구조와 하이브리드 추론 조합입니다. Qwen 공식 README와 기술 보고서에 따르면 Qwen3.8-Flash-Next는 메인 모델 125B 파라미터에 51B N-gram 임베딩 테이블이 추가된 구조이며, 토큰당 활성화되는 파라미터는 약 6B입니다. GPU는 연산과 메모리 대역폭이 중요한 부분을 맡고, MoE 엑스퍼트는 시스템 RAM에 두는 방식이라는 것이 원저자의 설명입니다.
보고된 구성과 수치: 그대로 재현하지 말고 조건부터 확인
원 게시물이 전한 구성은 다음과 같습니다.
- GPU: RTX 4090 24GB 한 장
- 시스템 RAM: 110GB DDR4
- 컨텍스트: 250K
- 디코드: 약 21 tok/s, 프리필: 약 364 tok/s
- 미사용: MTP, DFlash, KV-cache 양자화 없음
여기서 주의할 점이 두 가지 있습니다. 첫째, 모든 처리량 수치는 원저자가 인용한 제3자 구동 보고이며 공식 측정값이 아닙니다. 둘째, 댓글에서 Jatin Garg가 "KV-cache 없이 250K 컨텍스트에서 TTFT(Time to First Token)는 어땠느냐"고 물었지만, 수집된 증거 범위 내에는 작성자의 답변이 없습니다. 긴 컨텍스트 첫 응답 지연을 궁금해하는 독자라면 이 부분이 아직 비어 있다는 점을 감안해야 합니다.
커뮤니티의 별도 실측 기록도 같은 방향을 가리킵니다. ryan4yin의 gist는 RTX 4090 24GB + 96GB DDR5 환경에서 UD-IQ3_XXS 약 82GB GGUF 양자화 모델을 llama.cpp로 구동한 설정을 문서화했고, indrasmirror.au는 단일 4090에서 GPU 상주 엑스퍼트 캐시와 로드 모드 조정으로 MoE 디코드 속도를 23 t/s대에서 65 t/s대로 끌어올렸다고 보고했습니다. 즉 "4090 한 장 + 대용량 시스템 RAM + 저비트 양자화 + 오프로드"가 재현의 출발선이라는 점은 여러 출처가 일치합니다.
맥에서 돌리는 갈래: Sushi 2비트 팩과 디스크 스트리밍
같은 작성자의 후속 게시물은 32GB 통합 메모리 맥에서의 실용화 흐름을 다룹니다. Sushi의 2비트 팩이 모델 전체를 메모리에 올리는 대신 디스크에서 직접 스트리밍하도록 지원하며, M1부터 M6까지 대응한다는 내용입니다.
- 모델: Qwen3.8-Flash-Next, Sushi 2bpw 팩
- 하드웨어: 32GB 통합 메모리 맥
- 컨텍스트: 약 66K, 디스크 스트리밍 방식
- 보고 성능(M1 Max 기준): 프리필 약 200 tok/s, 생성 약 18 tok/s
이 수치 역시 제3자 보고이며, 정상 정밀도 로딩이 아니라 2비트 저비트 팩 + 디스크 스트리밍이라는 제약을 함께 봐야 합니다. 맥에서 여유 메모리가 부족한 독자라면 이 갈래가 현실적인 대안이지만, 속도보다는 "돌아간다"에 초점이 맞춰져 있습니다.
이 보고를 실전에 쓸 때의 체크리스트
- 모델 정체는 희소 MoE입니다. 전체 125B와 토큰당 활성 약 6B, 별도 51B N-gram 임베딩이라는 구조를 먼저 이해해야 설정이 해석됩니다.
- RTX 4090 한 장 구동에는 최소 96GB급 시스템 RAM이 전제되는 것으로 여러 커뮤니티 기록이 일치합니다. 110GB DDR4 보고도 그 연장선입니다.
- MTP, DFlash, KV-cache 양자화를 쓰지 않았다는 점이 보고의 조건입니다. 속도를 더 올리려면 indrasmirror.au처럼 엑스퍼트 캐시나 스페큘러티브 디코딩을 추가 검토할 수 있지만, 그건 별도 튜닝 영역입니다.
- 250K 같은 극단 컨텍스트에서는 TTFT가 관건인데, 이 보고에는 해당 답이 없습니다. 긴 문서 투입 전에 짧은 컨텍스트부터 점진적으로 검증하는 편이 안전합니다.
- 공식 서빙 레시피(sglang 기준)는 여전히 TP 분산과 262,144 네이티브 컨텍스트를 전제로 합니다. 소비자용 GPU 한 장 구동은 어디까지나 커뮤니티 우회로임을 구분해야 합니다.
원문 출처
- @Oluwaphilemon1 원 게시물 (RTX 4090 보고): X 게시물
- @Oluwaphilemon1 후속 게시물 (32GB 맥 + Sushi 2비트): X 게시물
- Qwen3.8-Flash-Next 공식 저장소: QwenLM/Qwen3.8-Flash-Next