벡터 RAG를 대체하는 'Retriever-Free Retrieval': Decision Model 기반 3단계 문서 검색
@mm_0824_kb가 소개한 논문 'Retriever-Free Retrieval'을 살펴봅니다. 이 방식은 벡터 RAG 대신 Decision Model을 활용하는 3단계 문서 검색 절차입니다.
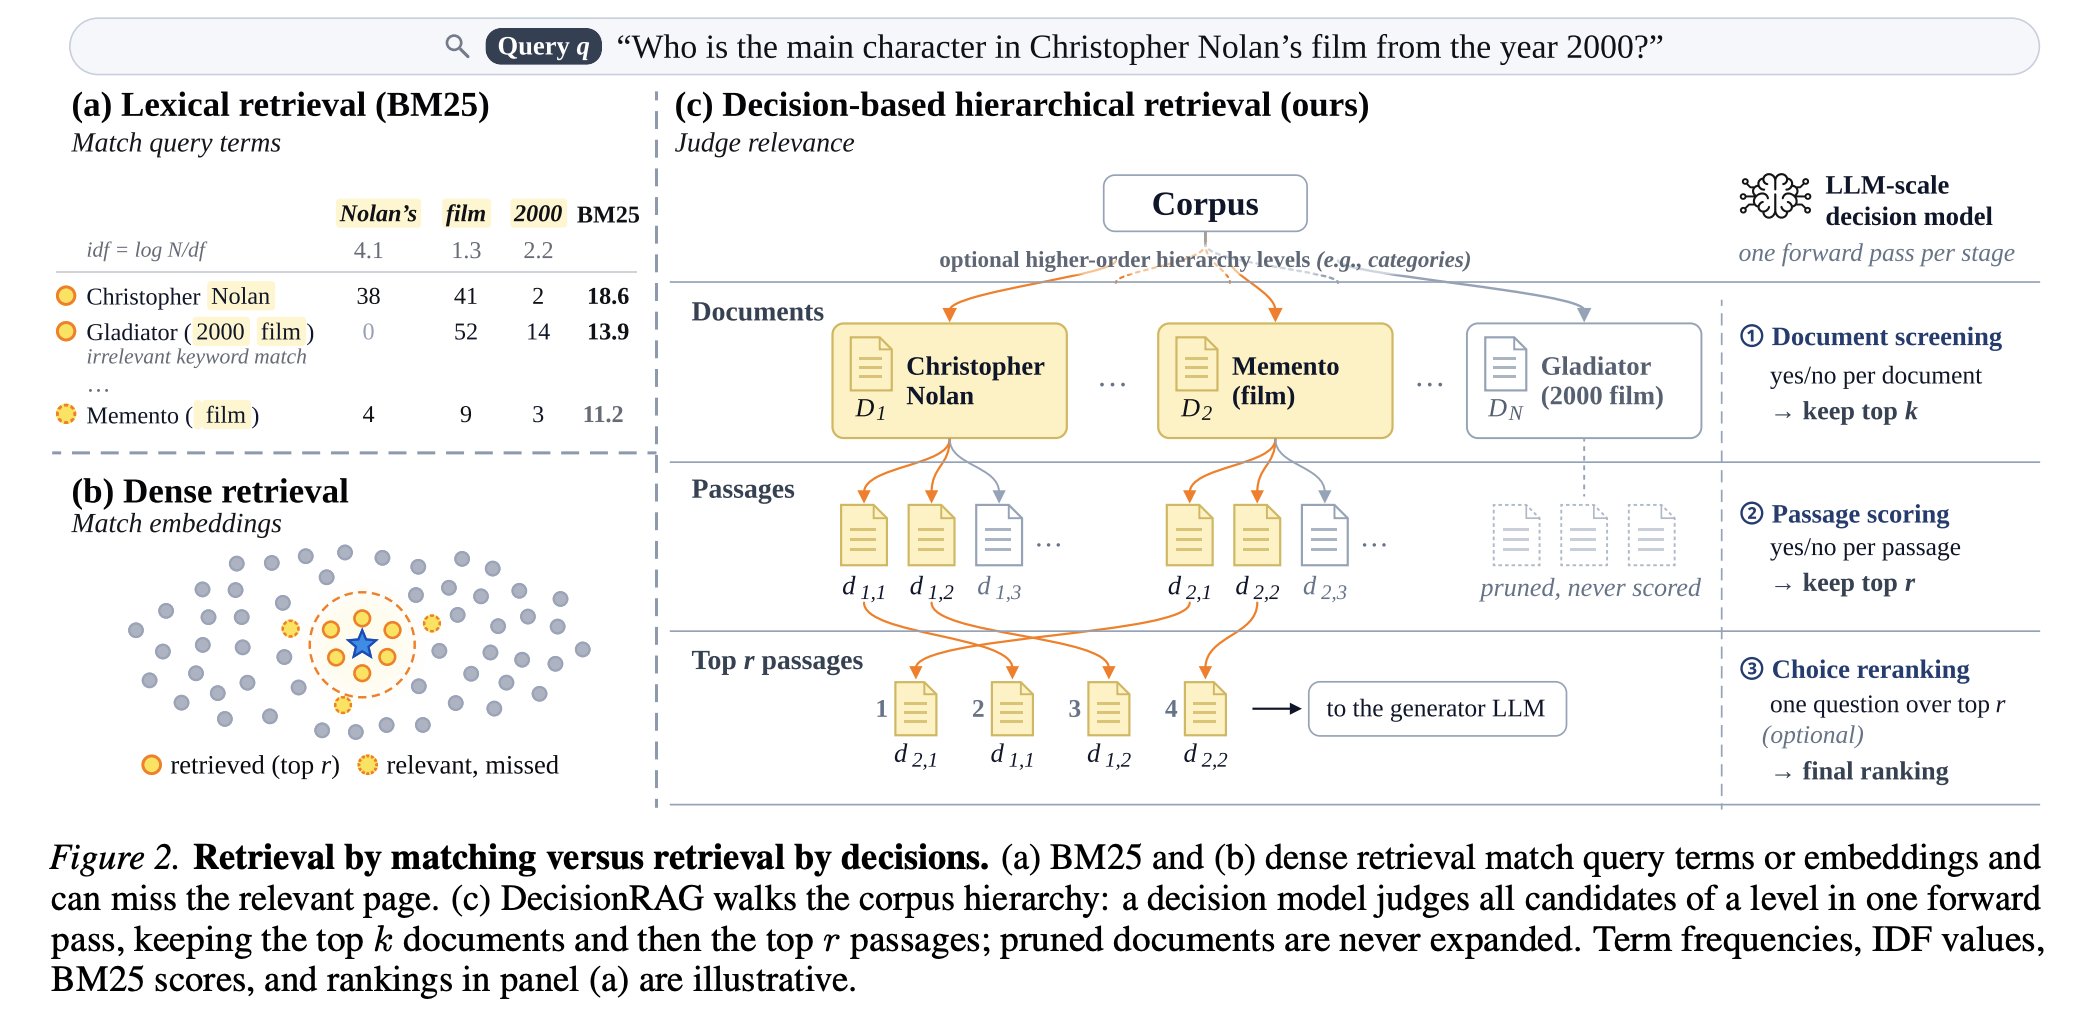
@mm_0824_kb의 X 게시물은 논문 「Retriever-Free Retrieval: Navigating Documents with Decision Models」을 벡터 RAG 대신 Decision Model로 문서를 검색하는 접근법으로 소개합니다.
이미지 출처: @mm_0824_kb
@mm_0824_kb에 따르면 이 방법은 속도가 빠르고 비용도 비교적 저렴합니다.
Retriever-Free Retrieval의 3단계 작동 메커니즘
게시물은 핵심 검색 파이프라인을 세 단계로 요약합니다.
- 1단계 (Yes/No 필터링): 문서 단위로 쿼리와의 관련성을 Yes/No로 판정하여 상위 $k$개 문서(top $k$)를 선택합니다.
- 2단계 (단락 추출): 선별된 문서 내의 개별 단락을 평가하여 관련성이 높은 상위 $r$개 단락(top $r$)을 추출합니다.
- 3단계 (객관식 재랭킹): 최종 추출된 후보군을 대상으로 Multiple Choice(객관식) 방식으로 최종 재랭킹을 수행합니다.
게시물의 한 답글은 Yes/No 필터링 후 단락을 재랭킹하면 추론을 필요한 부분에 집중할 수 있고, top $k$와 top $r$로 정확도와 속도, 비용의 균형을 조절할 수 있다고 설명합니다.
설계 시 고려사항과 실무적 의의
@mm_0824_kb는 초기 top $k$에서 정답 문서를 제외하면 후단에서 복구할 수 없으므로, 어디까지 후보를 줄일지가 중요하다고 설명합니다.
해당 스레드에서 @mm_0824_kb는 계층적이고 규모가 제한된 데이터라면 Decision Model만 사용할 수 있지만, 큰 데이터에는 하이브리드 방식이 더 적합할 수 있다고 설명합니다.