구글 리서치, 지속 학습 위한 슬립 프레임워크 공개: 망각 완화와 1,000만 토큰 장문 평가
구글 리서치가 LLM의 치명적 망각을 완화하고 단기 컨텍스트를 장기 파라미터로 통합하는 Sleep Framework를 공개했습니다. MoE 구조와 오프라인 통합을 통해 1,000만 토큰 규모의 장문 평가와 수학 추론 성능을 실험했습니다.
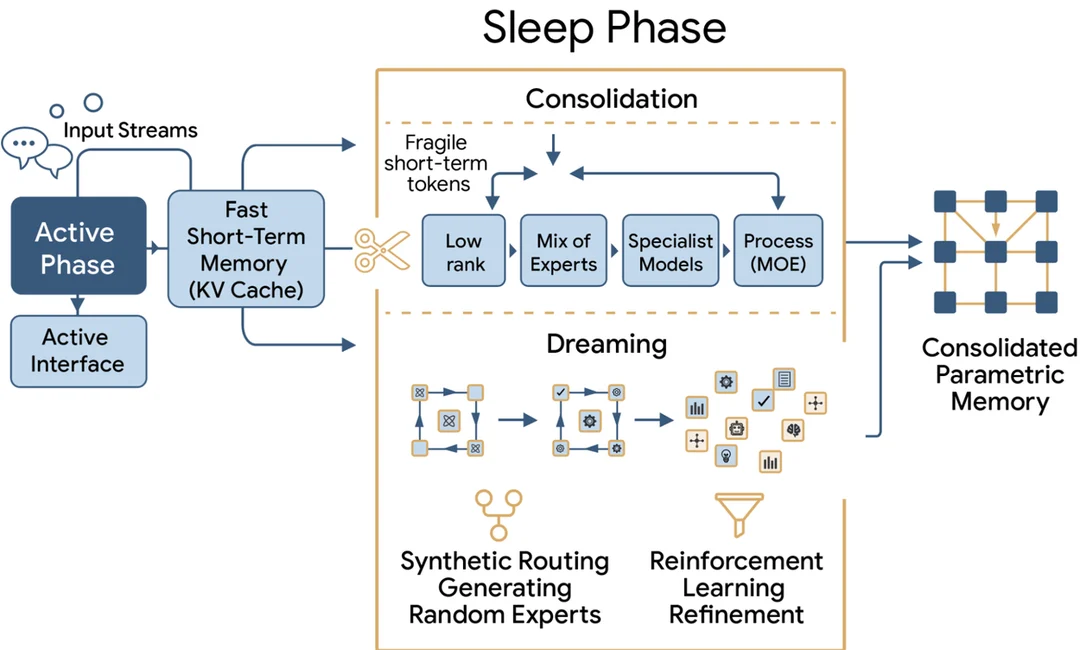
구글 리서치(Google Research)가 2026년 10월 27일, 대규모 언어 모델(LLM)이 기존 지식 손실을 줄이면서 새로운 정보를 지속 학습하도록 돕는 '슬립 프레임워크(Sleep Framework)' 연구를 공개했습니다. 인간의 수면 주기에서 착안한 이 방식은 대화나 입력으로 들어온 단기 기억을 모델 내부 장기 파라미터로 통합하는 학습 패러다임을 제시합니다.
배포된 LLM은 대체로 고정된 지식 시점을 유지하며, 새 데이터로 파라미터를 계속 업데이트하면 기존 학습 성능이 크게 저하되는 '치명적 망각(Catastrophic Forgetting)'이 종종 발생합니다. 인컨텍스트 학습(ICL)은 세션이 종료되면 지식이 휘발되는 한계가 있었습니다. 구글 리서치는 활동(Wake)과 휴식(Sleep) 상태를 주기적으로 교대하는 파이프라인으로 이 문제를 완화하는 접근을 제시했습니다.
각성·수면 주기 분리와 MoE 기반 메모리 통합 메커니즘
슬립 프레임워크의 핵심은 모델 동작 상태를 입력을 처리하고 상호작용하는 '각성(Wake)' 단계와 메모리 통합을 수행하는 오프라인 '수면(Sleep)' 단계로 분리한 점입니다.
각성 단계에서 모델은 입력을 처리하며 빠른 고빈도 레이어에 단기 정보를 임시 보관합니다. 이후 오프라인 수면 단계로 전환되면 새로운 입력 처리를 중단하고 저장된 단기 기억을 장기 파라미터로 이전하는 '메모리 통합(Memory Consolidation)'을 진행합니다.
- 파라미터 확장과 MoE 구조: 과거 지식을 덮어쓰지 않도록 Hope 아키텍처와 Mixture-of-Experts(MoE) 블록을 활용합니다. 사전에 배정된 저순위(Low-rank) 신규 전문가를 안정적인 저빈도 메모리 모듈에 연결해 신규 지식을 흡수합니다.
- 일반화 지식 증류(GKD)와 모방 학습: 고빈도 레이어의 단기 기억을 새로 확장된 장기 파라미터로 옮기기 위해 온폴리시(On-policy) 증류와 레벤슈타인 거리 기반 모방 학습(LTI)을 병행합니다.
- 시냅스 가지치기(Synaptic Pruning): 장기 파라미터 저장이 완료되면 임시 저장소로 쓰인 고빈도 모듈을 초기화해 다음 각성 주기를 위한 용량을 확보합니다.
드림(Dreaming) 단계를 통한 자율 추론 강화와 벤치마크 성과
수면 단계의 두 번째 축은 렘(REM) 수면을 모사한 '드림(Dreaming)' 단계입니다. 단순 기억 저장을 넘어 모델 스스로 합성 연습 문제를 생성하고 상이한 지식 영역을 결합해 추론 역량을 개선합니다.
드림 단계에서 MoE 라우터는 평소 함께 활성화되지 않던 이종 전문가를 무작위로 호출합니다. 이를 통해 서로 다른 지식 도메인을 결합하고 잠재 패턴을 탐색하는 합성 데이터를 만듭니다. 이후 그래디언트 기반 데이터 선별을 거쳐 학습 가치가 높은 샘플에 지도 미세조정을 적용하고 후속 성능을 평가합니다.
실험 평가 결과, BABILong 벤치마크에서 최대 1,000만(10M) 토큰 구간까지 거의 완벽한 장문 처리 확장 성능을 보이며 GPT-4 및 Titans 등 비교 기준보다 높은 성과를 보고했습니다. 만주어(Manchu)와 칼라망어(Kalamang) 등 처음 접하는 언어의 순차 번역 평가에서도 기존 지도 미세조정(SFT)과 달리 성능 저하가 거의 발생하지 않았습니다. 수학 추론 평가에서는 AIME 24 79.2%, AIME 25 69.0%, HMMT 25 46.1%의 정확도를 보고했습니다.
연구 범위와 실무 고려사항
이번 슬립 프레임워크는 이론적 분석과 실험 평가를 제시한 연구 접근입니다.
X의 @yumamaeda1210은 이 프레임워크가 아직 연구 단계이며 제미나이(Gemini)에 그대로 탑재된 것은 아니라고 설명했습니다. 오프라인 수면 단계에서 모델은 새로운 입력 처리를 중단하고, 사전에 할당된 MoE 메모리 블록을 열어 메모리 통합과 자기 개선을 위한 내부 연산을 수행합니다.
출처
- Google Research: The sleep framework: A new way for LLMs to retain knowledge in continual learning
- X (@yumamaeda1210): Sleep Framework 소개 포스트