엔비디아, 30B MoE 음성인식 모델 '네모트론 3.5 트랜스크라이브' 공개
엔비디아가 약 340억 개의 전체 매개변수와 43억 개의 활성 매개변수로 40개 언어 전사와 화자 구분을 지원하는 오픈 웨이트 음성 모델 네모트론 3.5 트랜스크라이브를 공개했습니다.
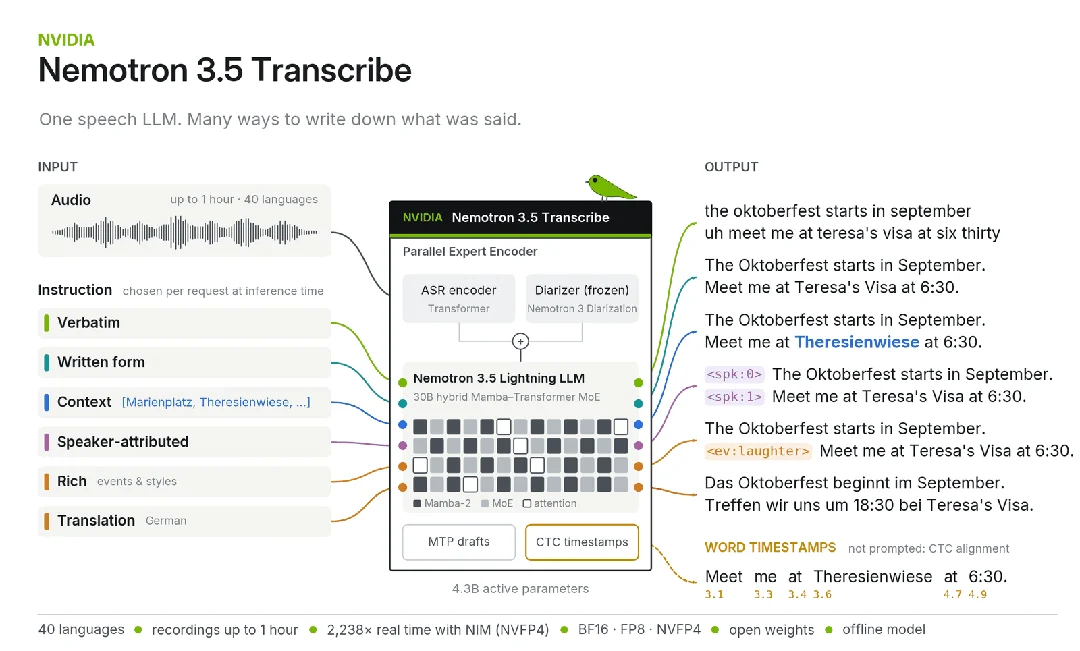
엔비디아(NVIDIA)가 2026년 10월 28일(현지 시각), 약 300억 개(30B) 매개변수의 언어 모델에 음성 인코더를 결합해 전체 약 340억 개(34B), 활성 약 43억 개(4.3B)의 매개변수를 사용하는 오픈 웨이트 음성인식 모델 '네모트론 3.5 트랜스크라이브(Nemotron 3.5 Transcribe)'를 공식 발표했습니다.
이미지 출처: NVIDIA / Hugging Face official model repository
이번 모델은 가중치(weights), 학습 데이터셋, 미세조정 레시피가 함께 허깅페이스(Hugging Face)에 개방되었으며, 대규모 음성 처리 파이프라인에서 다국어 전사와 화자 분할 작업을 단일 체크포인트로 통합 처리할 수 있도록 설계되었습니다.
40개 언어 전사와 화자 분할·오디오 이해의 단일 체크포인트 통합
네모트론 3.5 트랜스크라이브의 핵심 아키텍처는 전문가 혼합(Mixture of Experts, MoE) 구조입니다. 언어 모델 본체는 약 30B, 음성 인코더 등을 포함한 전체 모델은 약 34B이며 실제 추론 시에는 약 4.3B의 매개변수를 활성화합니다.
기존 음성 파이프라인이 전사, 화자 분할(diarization), 번역, 개인식별정보(PII) 마스킹 등을 위해 여러 독립 모듈을 파이프라인으로 연결했던 것과 달리, 이번 릴리즈는 이를 단일 체크포인트 안에서 프롬프트 기반으로 완결합니다.
- 통합 멀티태스크 처리: 40개 언어 음성 전사, 화자 레이블링(누가 언제 발언했는지 추적), 스페인어 및 일본어 등 다국어 번역, 문맥 프롬프팅 지원.
- 오디오 이해 및 PII 처리: 녹음본 내 개인식별정보(PII)를 탐지하여 텍스트 상에서 마스킹하거나 특정 서식 지시를 따르는 문맥 이해 지원.
- 다자 대화 추적: 여러 화자가 동시에 발언하는 회의 녹음 환경에서도 음성을 분리해 발언자별 텍스트를 정리합니다.
오픈 ASR 리더보드 1위 및 4B 활성 파라미터 벤치마크 지표
엔비디아가 공개한 벤치마크 결과에 따르면, 네모트론 3.5 트랜스크라이브는 허깅페이스 오픈 ASR 영어 리더보드(Open ASR English leaderboard)에서 오픈 웨이트 모델 중 1위를 기록했습니다. 엔비디아의 허깅페이스 블로그에 실린 리더보드 화면은 평균 단어 오류율(Word Error Rate, WER) 5.33%를, 연구 페이지의 별도 9개 테스트셋 집계는 4.71%를 제시합니다.
또한 음성 평가 전문 플랫폼인 보이스아레나(VoiceArena)의 14개 시스템 비교(화자 분할+ASR) 및 David AI의 다국어 화자 분할 벤치마크에서도 각각 1위를 기록했습니다.
아티피셜 애널리시스(Artificial Analysis)의 비스트리밍(non-streaming) 벤치마크에서 엔비디아가 자체 측정한 수치에 따르면, 네모트론 3.5 트랜스크라이브는 약 4B의 활성 매개변수로 2.81%의 단어 오류율을 기록했습니다. 이는 24B 활성 매개변수를 사용하는 복스트랄 스몰(Voxtral Small)의 2.77%와 비교해 활성 파라미터 규모를 6분의 1 수준으로 줄이면서 유사한 전사 정확도를 유지한 결과입니다.
도메인 파인튜닝 지원과 오프라인 전사 한계점
엔비디아는 모델 가중치 공개와 함께 그레이너리 v2(Granary v2) 오픈 음성 데이터와 네모 스피치(NeMo Speech) 파인튜닝 도구 세트를 함께 제공했습니다.
특화 도메인 적응 사례로 제시된 의료 ASR 연구에서는 사전 학습 모델 대비 미세조정을 통해 미학습 화자에 대한 단어 오류율을 최적 프롬프트 대비 45.8% 추가 감축했습니다. vLLM 및 SGLang 프로젝트와의 연동 지원도 함께 공개되었습니다.
도입 시 고려해야 할 기술적 제약 사항도 명시되었습니다:
- 오프라인 전사 전용: 실시간 스트리밍 처리가 아닌 사전 녹음된 오디오 파일에 대한 오프라인 전사 방식으로 작동합니다.
- 평가 길이 제한: 공식 평가 및 권장 입력 길이는 최대 1시간 분량의 녹음 파일 기준입니다.
- 자체 측정 수치: 성능 비교 지표 중 일부는 엔비디아의 자체 테스트 결과에 기반합니다.
출처
- NVIDIA AI 공식 X (@NVIDIAAI): Nemotron 3.5 Transcribe Announcement
- NVIDIA 연구팀: Nemotron 3.5 Transcribe 공식 연구 페이지
- NVIDIA 연구진의 Hugging Face 공식 블로그: Nemotron 3.5 Transcribe and Granary v2
- Hugging Face 모델 저장소: NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
- Hugging Face Open ASR 리더보드: Open ASR English Leaderboard