구글, 검증기 없이 테스트 타임에 자체 진화하는 에이전트 프레임워크 'Harness^2' 발표
구글 연구진이 외부 검증기 없이 실행 시점에 에이전트 하네스를 재귀적으로 수정·비교 검증하여 최적 조합을 유지하고 다음 작업으로 진화시키는 'Harness^2' 연구를 공개했습니다. GLM-5와 Gemini 3.5 Flash에서 성능 향상을 확인했습니다.
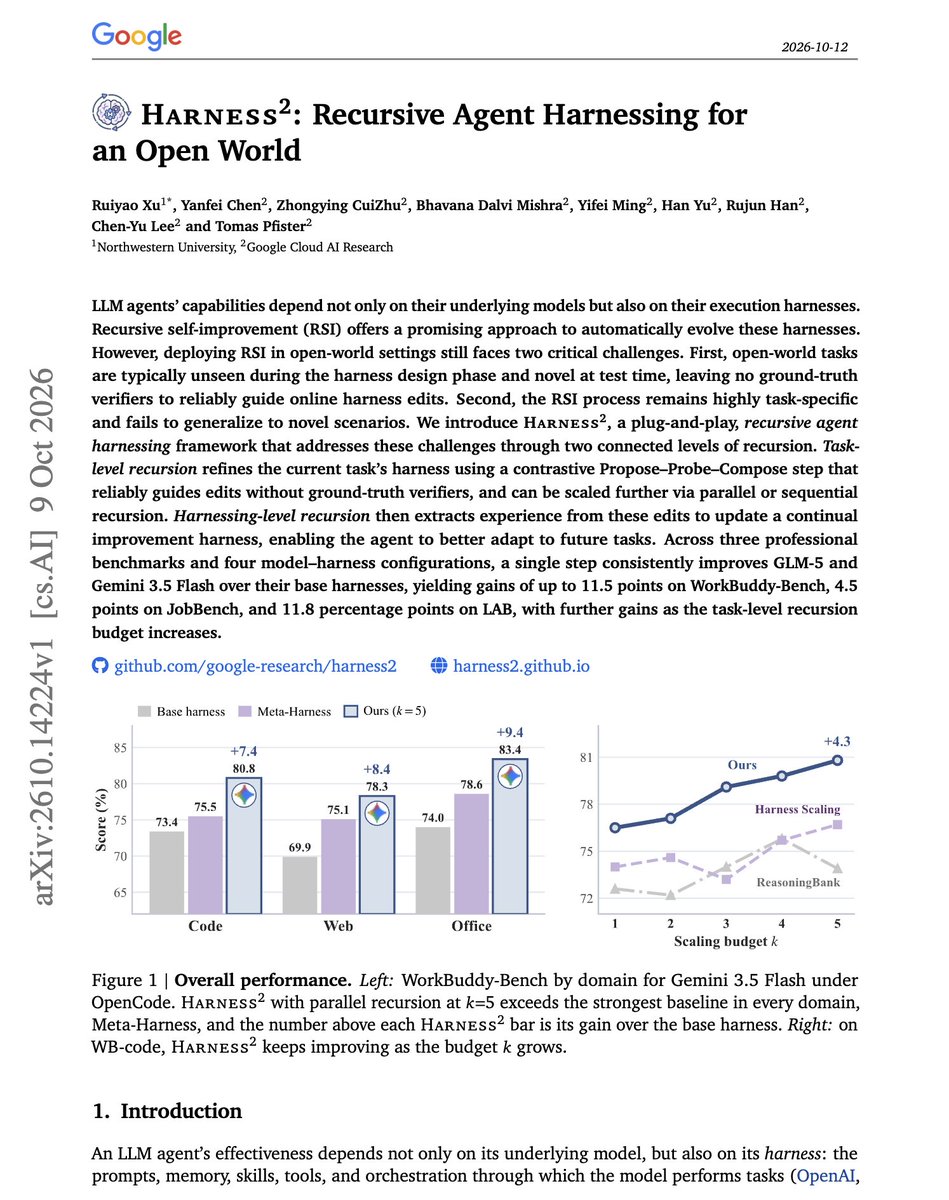
구글(Google) 연구진이 외부의 정답 검증기(verifier) 없이도 실행 시점(test time)에서 에이전트 하네스를 재귀적으로 개선하는 연구 논문 'Harness^2(Harness Squared)'를 공개했습니다. AI 리서치 커뮤니티 DAIR.AI 등을 통해 알려진 이번 연구는 정답 라벨이 주어지지 않는 복잡한 개방형 실무 작업(open-world tasks) 환경에서 에이전트가 자체적으로 실행 하네스를 진화시키며 성능을 확장할 수 있는 메커니즘을 제시합니다.
이미지 출처: DAIR.AI (@dair_ai) via X
기존의 에이전트 성능 개선 기법은 대부분 사전에 정의된 정답 검증기나 보상 모델에 의존해 왔습니다. 하지만 실제 배포 환경이나 복합 도메인 작업에서는 정답 여부를 즉시 판정해 줄 외부 검증기를 두기 어렵습니다. Harness^2는 이러한 구조적 병목을 해결하기 위해 현재 작업 환경에서 하네스 수정안을 상호 비교 검증하고, 도출된 교훈을 향후 작업에 전달할 두 번째 하네스에 반영하는 재귀 구조를 도입했습니다.
외부 검증기 없는 테스트 타임 자체 개선 메커니즘
Harness^2의 핵심 아이디어는 에이전트가 현재 직면한 구체적인 작업 컨텍스트에 맞춰 하네스 수정안을 동적으로 생성하고 자체 선별하는 데 있습니다.
- 후보 하네스 수정안 생성 및 상호 비교: 현재 작업이 주어지면 프레임워크는 하네스에 대한 복수의 수정안(edits)을 제안합니다. 제안된 수정안들은 상호 비교 테스트(test against each other)를 거쳐 성과를 평가받으며, 이 과정에서 가장 효과적인 조합(combination)만이 최종 선택되어 유지됩니다.
- 교훈 축적과 2차 하네스 갱신: 테스트를 통과한 수정안에서 도출된 실무적 교훈(lessons)은 에이전트가 내부적으로 유지하는 '두 번째 하네스(second harness)'에 반영됩니다. 에이전트는 이 2차 하네스를 다음 작업으로 이월하여 향후 문제 해결에 지속적으로 활용합니다.
이 방식은 정답 검증기가 없는 개방형 환경에서도 테스트 타임 연산량을 활용해 에이전트 동작 신뢰성을 체계적으로 끌어올릴 수 있는 스케일링 경로를 제공합니다.
GLM-5·Gemini 3.5 Flash 벤치마크 검증 및 성능 향상 결과
연구진은 다중 실무 환경 벤치마크인 WorkBuddy-Bench, JobBench, LAB을 대상으로 프레임워크의 유효성을 검증했습니다.
- 파운데이션 모델 전반의 일관된 성능 향상: GLM-5와 Gemini 3.5 Flash를 대상으로 테스트된 모든 하네스 구성에서 성능이 고르게 개선되었습니다.
- 병렬 테스트 타임 스케일링: WorkBuddy-Bench 평가에서 5개의 후보 하네스 수정안을 병렬로 실행했을 때 2.9점에서 3.9점의 추가 점수 향상을 기록했습니다.
- 메모리 베이스라인과의 비교 우위: 코딩 작업 비교군에서 대표적인 메모리 기반 베이스라인인 ReasoningBank는 기본 하네스 대비 점수가 최대 6.6점 하락하는 불안정성을 보였으나, Harness^2는 성능 저하 없이 일관된 우위를 유지했습니다.
이는 단순히 이전 작업 이력을 메모리에 저장해 두는 베이스라인 방식에 비해, 실행 하네스 자체를 재귀적으로 수정하고 검증하여 진화시키는 방식이 작업 완수에 더 안정적인 성능을 보장함을 시사합니다.
실무 적용 시 고려 사항과 연산·규칙 관리 한계
테스트 타임 하네스 진화는 강력한 잠재력을 지니지만, 실제 운영 환경 도입 시 몇 가지 구조적 비용과 제약 사항을 동반합니다.
- 자체 비교 평가의 편향 위험: 외부 정답 검증기 없이 후보 수정안을 자체 비교 평가하므로, 초기 생성된 수정안의 품질 편차나 자체 비교 평가 메커니즘의 편향(bias)이 누적될 위험을 통제해야 합니다.
- 테스트 타임 연산 및 토큰 비용 증가: 5개의 후보 수정안을 병렬 실행하는 등 테스트 타임 스케일링 과정에서 모델 호출 횟수와 토큰 소비량이 크게 증가합니다. 응답 지연(latency)과 비용 제약이 엄격한 환경에서는 적절한 후보 수 조정이 필요합니다.
- 작업 도메인 전환 시 망각(forgetting) 메커니즘 필요: 이전 작업에서 누적된 하네스 규칙을 다음 작업으로 무조건 전파할 경우, 성격이 완전히 다른 도메인으로 전환될 때 기존 규칙이 오히려 오작동을 유발할 수 있습니다. 축적된 규칙 중 불필요한 항목을 선별 폐기하는 규칙 망각 절차가 병행되어야 합니다.
출처
- DAIR.AI 공식 X (@dair_ai): Google Research 'Harness^2' Paper Discussion