웹캠을 실시간 AI 감지기로 변환하는 로컬 VLM 하네스 'glance-vlm speedlab' 오픈소스 공개
오픈소스 VLM의 토큰 생성을 생략하고 단일 순전파 로짓 판독으로 웹캠 영상을 실시간 감정·카운트·객체 감지기로 변환하는 glance-vlm speedlab 및 벤치마크가 공개되었습니다.
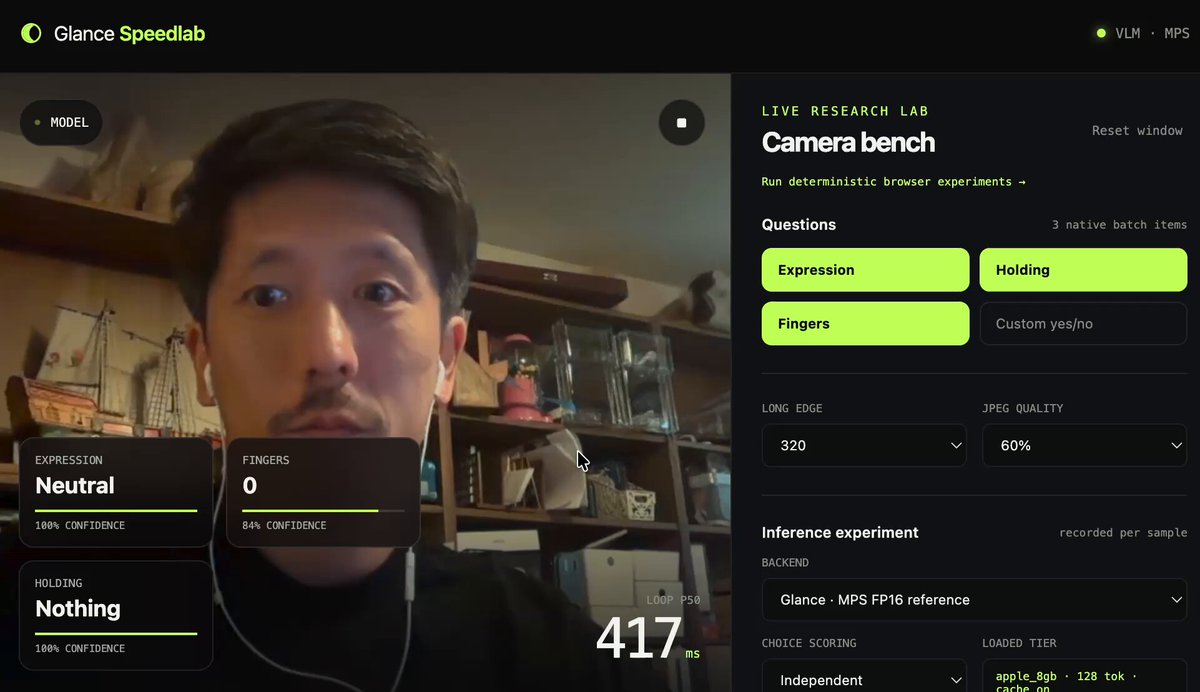
일반 웹캠 영상을 실시간 다중 AI 감지기(감정, 인원 카운트, 객체 인식)로 변환하고 로컬 환경에서 160ms 대 레이턴시로 구동하는 오픈소스 VLM(비전-언어 모델) 벤치마크 하네스 'glance-vlm speedlab'이 2026년 9월 24일 공개되었습니다.
이미지 출처: Yohei Nakajima (@yoheinakajima)
오픈소스 AI 개발자 요헤이 나카지마(Yohei Nakajima)가 공개한 이 프로젝트는 오픈소스 비전-언어 모델에서 느린 텍스트 토큰 생성(generation) 헤드를 과감히 생략하고, 단 한 번의 순전파(forward pass)에서 도출되는 로짓(logit)을 직접 판독하여 Yes/No, 다지선다(pick-one), 평점(rating) 판단을 실시간으로 내리는 경량 하네스 구조를 제시합니다.
토큰 생성을 생략한 로짓 판독 구조와 160ms 실시간 추론
전통적인 멀티모달 VLM 파이프라인은 입력된 비디오 프레임에 대해 JSON 구조체나 자연어 서술 토큰을 순차 생성(autoregressive generation)하는 방식을 취합니다. 이로 인해 단일 판별에도 수 초 이상의 지연 시간과 높은 GPU 자원 소모가 발생하여 라이브 웹캠 스트림 처리에 한계가 있었습니다.
glance-vlm은 이러한 생성 헤드 연산을 완전히 건너뜁니다. 동결된(frozen) 오픈소스 VLM의 출력 레이어 로짓에서 지정된 타입 질문의 확률 분포를 직접 추출함으로써, 추가적인 모델 파인튜닝이나 재학습 없이도 고속 판별 분류기로 활용합니다.
실제 Apple M5 하드웨어 환경에서 단일 질문 루프를 실행한 벤치마크 결과는 다음과 같습니다.
- PyTorch / MPS (FP16): p50 기준 약 210ms 레이턴시를 기록했습니다.
- MLX 8-bit 양자화: p50 기준 약 160ms의 고속 로컬 레이턴시를 달성했으며, 종합 시각 참/거짓(True/False) 질문 테스트에서는 161ms를 기록했습니다.
기본 모델로는 Apache-2.0 라이선스의 오픈 가중치 모델인 Qwen3-VL-4B(약 9GB 가중치 다운로드)를 지원합니다. 텍스트 토큰 생성 단계를 거치지 않고 1회 순전파 로짓에서 Yes/No, 다지선다, 평점 확률을 즉시 판독하므로, 로컬 머신 외부로 이미지를 전송하지 않으면서도 안정적이고 빠른 로컬 시각 판별이 가능합니다.
9개 질문 제어 벤치마크와 27.6% 레이턴시 단축 검증
speedlab 프로젝트는 9개의 서로 다른 시각 질문을 동시에 평가하는 통제된 신규 프레임 벤치마크 환경을 구축해 실효성을 검증했습니다.
동일 하드웨어 조건에서 기존 파이프라인의 p50 레이턴시가 358.5ms였던 반면, glance-vlm speedlab 적용 시 259.6ms로 27.6%의 레이턴시 단축을 기록했습니다. 특히 속도 향상 과정에서 판단 왜곡이나 신뢰도 저하가 발생하지 않았으며, 통제 실험에 포함된 84개 판단 중 84개 전수(84/84)가 기준 판정 결과와 완벽하게 일치했습니다.
요헤이 나카지마는 이번 릴리즈와 함께 21개의 상세 실험 데이터, 재현 가능한 벤치마크 스크립트, 연구 논문 요약, 실패한 아키텍처 사례 분석을 GitHub(yoheinakajima/glance-speedlab)에 모두 공개했습니다. 커뮤니티에서는 200ms 이하의 로컬 추론 성능이 확보됨에 따라 외부 클라우드 의존 없이 로컬 게임 NPC 시각 인식이나 프라이빗 엣지 모니터링 등 저지연 비전 워크플로우에 응용될 수 있을 것으로 기대하고 있습니다.
설치 환경과 실전 웹캠 구현 시 주의할 점
glance-vlm은 개발자가 즉시 로컬 워크플로우에 통합할 수 있도록 패키지화되어 제공됩니다.
- 패키지 설치 및 라이선스: Apache-2.0 라이선스로 배포되며
pip install glance-vlm명령어로 설치할 수 있습니다. - 실행 환경: Python
>=3.11, <3.12환경을 공식 지원합니다. - 하드웨어 가속 의존성: 160ms 대의 실시간 추론 속도는 Apple Silicon(M5, MLX/MPS)과 같은 최신 칩셋의 하드웨어 가속 환경에 직접적으로 의존합니다.
연속적인 웹캠 비디오 스트림을 처리할 때 주의해야 할 엔지니어링 고려 사항도 릴리즈 과정에서 제기되었습니다. 무의미한 반복 추론을 줄이기 위해 화면 변화량을 감지하는 템포럴 게이트(temporal gate)를 구성할 경우, 검사 프레임을 직전 카메라 프레임(previous camera frame)과 단순 비교해서는 안 된다는 점이 기술 구현 시 주의사항으로 지적되었습니다.
카메라 앞 피사체가 매우 천천히 움직이거나 조명이 서서히 변하는 점진적 변화(slow drift) 상황에서는 매 프레임 간 차이가 임계값을 넘지 못해 이전 감지 결과가 영구히 갱신되지 않는 교착 상태가 발생할 수 있습니다. 따라서 실무 파이프라인에서는 신규 프레임을 직전 프레임이 아닌 '마지막으로 스코어링된 프레임(last scored frame)'과 비교하도록 설계해야 안정적인 실시간 갱신이 보장됩니다.