클라우드 기반 연구실 논문 위키 시스템 오픈소스 '벼리(byeori)' 공개
13,000여 편의 논문을 관리하던 연구실의 AWS 기반 LLM-Wiki '벼리(byeori)'가 오픈소스로 공개되었습니다. Fargate, Bedrock Claude, Lambda, MCP 인터페이스를 결합한 클라우드 아키텍처와 특징을 정리합니다.
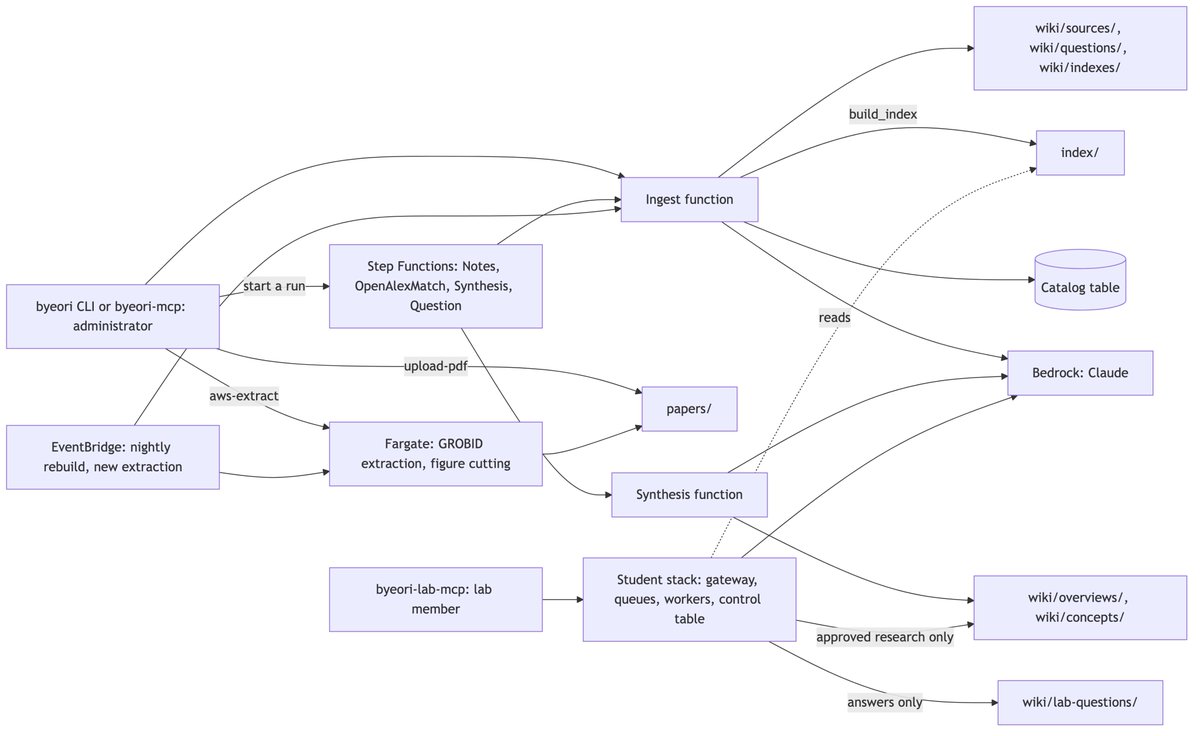
연구실이나 학술 조직에서 수천 편 이상의 논문을 체계적으로 정리하고 구성원 전체가 지식을 공유하는 작업은 오랜 과제였습니다. 최근 안드레이 카파시가 제시한 LLM-Wiki 개념이 로컬 환경을 중심으로 확산되고 있으나, 이를 다수의 연구원이 상시 접근하고 수만 편 규모의 논문을 지속적으로 수집·색인하는 클라우드 환경으로 확장하는 데는 인프라 설계의 장벽이 존재했습니다. 실제 연구실에서 13,000여 편의 논문과 200 GB 이상의 데이터를 운용해 온 AWS 기반 논문 위키 시스템 '벼리(byeori)'가 오픈소스로 공개되었습니다.
이미지 출처: Joon An (@joonomics) on X
서버리스 중심의 AWS 인프라와 역할 분담 구조
벼리(byeori)는 상시 가동되는 무거운 서버 인스턴스를 유지하는 대신, 작업 요청이 발생할 때만 필요한 만큼 자원을 할당하는 서버리스 및 관리형 AWS 서비스를 조합하여 인프라 비용을 최소화하도록 설계되었습니다.
-
저장소 및 상태 관리 계층
- Amazon S3: 원본 논문 PDF, 추출된 본문 텍스트, 문서 내 표와 그림 이미지, 생성된 위키 마크다운 페이지, 전문 검색 인덱스가 모두 안전하게 보관되는 중앙 데이터 저장소 역할을 수행합니다.
- Amazon DynamoDB: 수집된 각 논문이 텍스트 추출, 증거 노트 작성, 위키 합성 등 처리 파이프라인 중 어느 단계까지 진행되었는지를 추적하는 상태 장부 역할을 담당합니다.
-
작업 실행 및 AI 모델 계층
- AWS Lambda: 신규 논문 처리 트리거를 수신하여 노트를 작성하고, 합성 페이지를 생성하며, 학생과 연구원의 질의에 실시간으로 응답하는 핵심 애플리케이션 런타임입니다. 평상시에는 유휴 상태로 대기하며 호출 시에만 동작하므로 대기 비용이 발생하지 않습니다.
- AWS Fargate: PDF 문서에서 본문 텍스트를 추출하고 그림과 표를 정밀하게 잘라내는 연산 집약적 작업을 논문 한 편마다 개별 컨테이너로 격리하여 실행하며, 작업 완료 즉시 종료됩니다.
- Amazon Bedrock: 논문 정독, 정형화된 증거 노트 작성, 주제별 합성, 사용자 질문 응답을 전담하는 Claude 모델이 가동되는 공간으로, 시스템 전체 운영 비용의 가장 큰 비중을 차지합니다.
-
오케스트레이션 및 거버넌스 계층
- AWS Step Functions: 수천 편 이상의 대규모 논문 배치를 안정적으로 순차 처리할 수 있도록 파이프라인 실행 흐름을 제어합니다.
- AWS Systems Manager Parameter Store: LLM 및 외부 서비스 연동에 필요한 API 키와 민감 설정을 안전하게 중앙 관리합니다.
- Amazon EventBridge: 야간 등 유휴 시간대를 활용해 검색 인덱스를 정기적으로 자동 재구축하는 스케줄링을 담당합니다.
- AWS CloudTrail: 위키 내 마크다운 페이지 수정 및 생성 내역을 투명하게 감사 로그로 기록합니다.
- AWS IAM: 세분화된 권한 관리를 통해 관리자는 논문 등록과 위키 수정 권한을 갖고, 학생 연구원은 질의 및 열람 전용 권한을 부여받아 안전하게 협업할 수 있습니다.
논문 수집부터 MCP 자연어 질의·합성까지의 파이프라인
벼리의 동작 방식은 안드레이 카파시의 로컬 LLM-Wiki 방법론을 클라우드 규모로 확장한 구조를 취하고 있습니다.
논문 PDF가 시스템에 입력되면 Fargate 컨테이너가 본문과 시각 자료를 추출하고, Bedrock의 Claude 모델이 문서 전문을 정독하여 논문당 단 한 장의 표준화된 '증거 노트(Evidence Note)'를 작성합니다. 각 증거 노트에는 일관된 분석 품질을 보장하기 위해 정해진 규격이 적용됩니다.
- 표준 증거 노트 규격: 한 줄 요약, 주요 기여(Contributions), 연구 방법(Methodology), 실험 결과(Results), 연구의 한계(Limitations), 관련 연구(Related Work), 핵심 용어 정리(Terminology Glossary)가 고정된 순서로 체계화되어 기록됩니다.
- 출처 및 메타데이터 추적: 어떤 PDF 판본에서 어떤 모델이 언제 노트를 작성했는지가 메타데이터로 함께 기록되어 향후 모델 교체나 재검증 시 출처를 명확히 추적할 수 있습니다.
이렇게 작성된 증거 노트들이 연구실 내에 축적되면, 상위 모델이 이를 종합하여 소주제별 개요(Subtopic Overview)와 분야별 종합 개요(Domain Overview)를 주기적으로 작성하여 지식의 위계를 형성합니다.
연구실 구성원은 일상적인 연구 환경에서 Claude Code나 Codex 같은 코딩 에이전트에 내장된 MCP(Model Context Protocol) 인터페이스를 통해 벼리에 자연어로 직접 질문할 수 있습니다. 시스템은 축적된 위키와 노트를 기반으로 엄밀한 출처 인용이 포함된 답변을 즉시 반환합니다. 만약 연구원의 질문이 기존 위키에 정리되지 않은 새로운 주제의 융합이나 심층 정리를 요구할 경우, 시스템은 임의로 문서를 생성하지 않고 사용자에게 신규 합성 페이지를 생성할지 여부를 먼저 확인한 뒤 승인된 경우에만 위키에 문서를 영구 추가합니다.
이 과정에서 연구원의 질문에 기존 위키 역링크(Backlink)만 추가할지, 아니면 질문의 수준에 맞춰 위키를 새롭게 합성할지 판단하는 분류기로는 현재 JEV를 연동해 저렴하게 처리하고 있으나, 개발자는 최적의 해법인지에 대해 판단 분류기를 지속적으로 다듬으며 검증하고 있다고 밝혔습니다.
13,000편 실전 운영 데이터와 현재 베타 버전의 한계
공개된 저장소의 가장 큰 가치는 이론적 아이디어에 그치지 않고 실제 학술 연구 환경에서 대규모 실증을 거쳤다는 점입니다.
현재 개발자 연구실에서는 총 13,115편의 논문을 벼리 시스템에 적재하여 운영 중이며, 원본 PDF, 추출된 본문 및 표·그림 데이터, 위키 마크다운 페이지를 모두 합쳐 총 219 GB에 달하는 학술 지식 자산이 안정적으로 관리되고 있습니다. 개별 연구원에게는 전용 IAM 권한만 발급하면 손쉽게 접근 환경을 구성할 수 있어 연구실 운영 편의성이 높다는 평가를 받고 있습니다.
다만 개발자가 밝혔듯 현재 벼리는 오픈소스 초기 베타 버전으로, 도입을 검토할 때 유의해야 할 몇 가지 기술적 제약 사항이 존재합니다.
- 워커 컨테이너 빌드 환경 검증 미완료: PDF에서 그림과 표를 추출하는 워커 컨테이너 이미지는 Docker가 설치된 환경에서 직접 빌드해야 하며, 다양한 클라우드 배포 경로에 대한 표준화된 빌드 검증이 아직 진행 중입니다.
- PDF 메타데이터 식별 실패 시 예외 처리: 입력된 PDF 파일에서 논문의 서지 정보를 정상적으로 식별하지 못할 경우 노트 작성을 중단하고 정지하며, 현재로서는 이를 수동으로 개입해 정정하는 보완 경로가 마련되어 있지 않습니다.
- 학생용 메시지 다국어화 미비: 연구원 질의 응답 시 노출되는 학생용 안내 메시지 중 일부가 한국어로 고정되어 있어 글로벌 랩 환경을 위한 다국어 정비가 필요합니다.
- 합성 비용과 모델 민감도: 수많은 개별 노트로부터 종합 위키를 합성할 때 최적의 비용 대비 품질을 내는 모델 구성과 노트 연결 임계치에 대한 테스트가 지속되고 있습니다. 특히 성능과 비용 측면에서 뛰어난 Claude Opus 5.5의 경우 생물학 등 특정 민감 연구 분야의 안전 가드레일에 걸려 합성이 차단되는 사례가 관찰되었습니다.
- 수집 비용 최적화: 대량의 논문을 수집하는 Ingestion 단계의 경우 현재까지는 원시 API 직접 호출보다 구독형 요금제 환경을 거치는 방식이 비용 면에서 저렴하여, 토큰 소비량을 경량화하면서도 추출 품질을 유지하기 위한 추가 튜닝이 요구됩니다.
벼리는 수많은 논문 속에서 필요한 지식을 빠르게 찾고 팀 단위로 누적 관리하고자 하는 연구실, 학술 랩, R&D 엔지니어링 팀에게 실질적인 클라우드 LLM-Wiki 레퍼런스를 제공합니다. 프로젝트는 GitHub 저장소를 통해 코드가 공개되어 있으며, 사용 중 발생하는 문제와 개선 의견은 GitHub 이슈를 통해 접수받고 있습니다.
출처
- GitHub 저장소: joonan-lab/byeori
- Joon An 공식 X (@joonomics): 소개 포스트