Wafer AI 성능 엔지니어링 리소스 part 10, CUDA 프로그래밍 가이드 정리를 공개
Wafer의 AI 성능 엔지니어링 리소스 모음 part 10편으로 NVIDIA CUDA 프로그래밍 가이드의 핵심 활용법을 정리한 실무형 큐레이션입니다. 어텐션·matmul 커널 튜닝 관점에서 꼭 볼 장을 짚어줍니다.
Wafer(@wafer_ai, 인증 계정)가 2026년 10월 8일 AI 성능 엔지니어링 리소스 시리즈의 part 10편을 공개했습니다. 이번 편의 주제는 NVIDIA CUDA 프로그래밍 가이드이며, LLM을 빠르게 만드는 출발점으로 "실행이 어디에서 대기하는지 이해하는 것"이라는 관점을 제시합니다.
이미지 출처: @wafer_ai via X
시리즈의 맥락도 분명합니다. 작성자는 이 모음을 세계에서 가장 포괄적인 AI 성능 엔지니어링 저장소라고 소개하며(작성자 주장), 리소스마다 한 편씩 정리 글을 올리는 방식으로 연재하고 있습니다. 루트 게시글 본문이 스레드 미리보기 기준이라 시리즈 전체 분량은 확정할 수 없으므로, 이 글은 part 10편에서 확인되는 내용만 다룹니다.
part 10이 다루는 것: 대기의 메커니즘
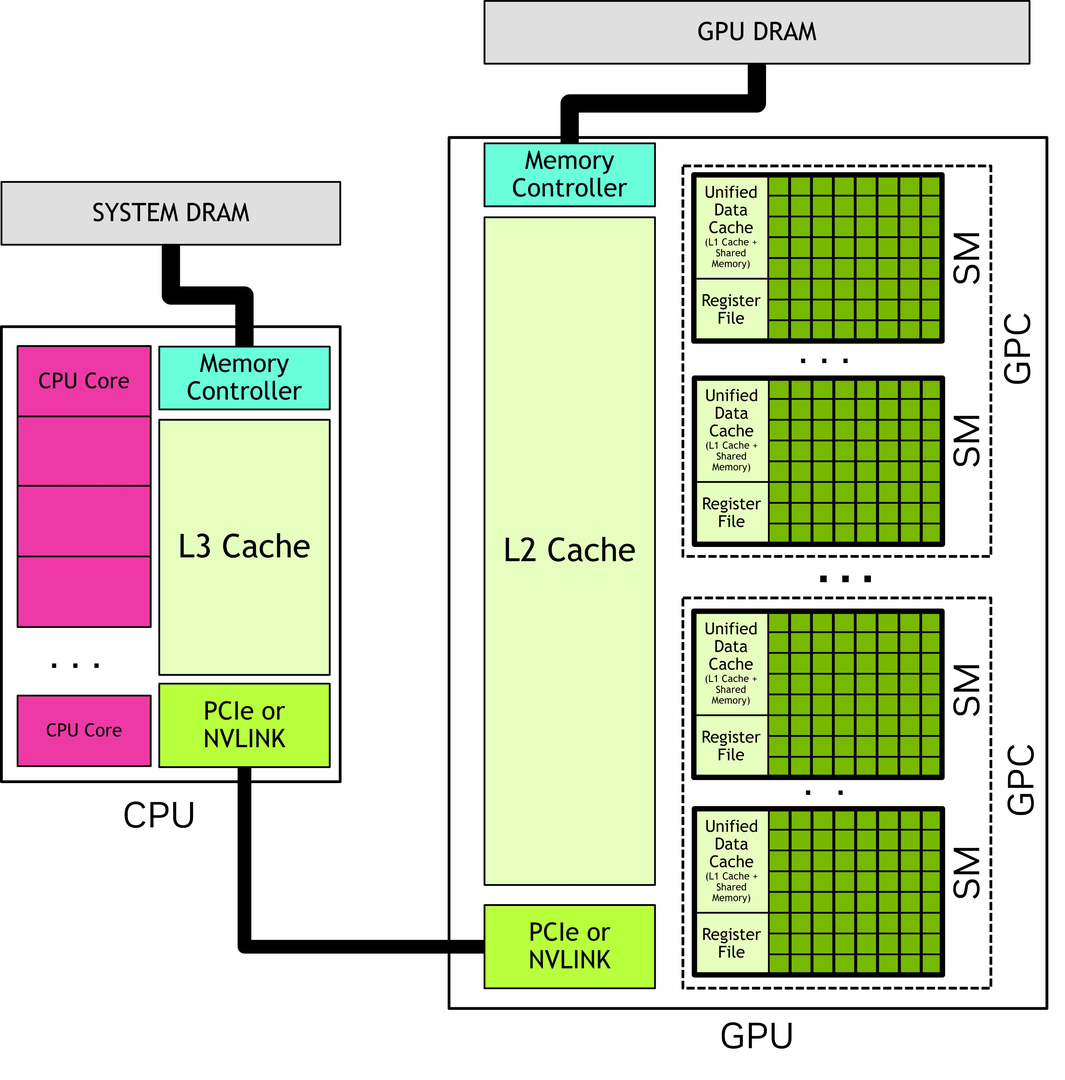
게시글은 두 가지 대기를 대비시킵니다. 어텐션 커널이 다음 타일 데이터를 기다리며 멈추는 경우, 그리고 서빙 런타임이 다음 실행 요청을 제때 넘기지 못해 GPU를 놀게 만드는 경우입니다. NVIDIA CUDA 프로그래밍 가이드는 바로 이런 대기 뒤에 있는 동작 메커니즘을 설명하는 문서로 소개됩니다.
실무 연결점도 구체적입니다. PyTorch·Triton·CUDA로 작업하는 AI 성능 엔지니어를 대상 독자로 못 박고, 어텐션·matmul·정규화 커널 튜닝 관점에서 SIMT 장과 CUDA 타일(Tile) 장을 짚어줍니다. 레이아웃과 데이터 재사용이 GPU 실행과 어떻게 이어지는지 파악하는 데 도움이 된다는 설명입니다. 루트 게시글이 중간에 잘려 있어 그 이상의 세부 목차나 분량은 단정하지 않습니다.
확인할 수 있는 경로: 공식 문서와 큐레이션 저장소
스레드 후속 게시글에서 검증되는 링크는 두 개입니다.
- NVIDIA CUDA 프로그래밍 가이드 공식 문서: https://docs.nvidia.com/cuda/cuda-programming-guide/
- Wafer의 큐레이션 저장소: https://github.com/wafer-ai/gpu-perf-engineering-resources
저장소의 코드 구성·커밋·라이선스는 이번 스레드 수준의 확인만으로는 단정할 수 없으므로, 큐레이션 모음이라는 범위에서만 이해하는 것이 안전합니다. 커널 코드를 직접 만지는 독자라면 공식 문서 링크부터 열고, 시리즈 저장소는 북마크해 두는 활용이 실용적입니다.
누가 보면 좋은가
LLM 서빙 지연의 원인이 커널 내부의 데이터 대기인지, 런타임의 실행 스케줄링인지 구분하고 싶은 성능 엔지니어에게 맞는 입문 큐레이션입니다. 어텐션·matmul 커널을 튜닝하거나 Triton·CUDA 레벨에서 병목을 좁혀야 하는 작업이라면, SIMT와 타일 장부터 살펴보는 것이 실용적입니다.
출처
- Wafer(@wafer_ai) 원문 스레드: part 10: CUDA Programming Guide
- NVIDIA 공식 문서: CUDA Programming Guide
- Wafer 큐레이션 저장소: gpu-perf-engineering-resources