vLLM-Omni 기술 리포트 공개, 옴니모달 서빙 통합 런타임
vLLM 팀이 vLLM-Omni 기술 리포트를 알리고 공식 저장소 링크를 공유한 소식을 한국어로 정리한 개발자용 소식입니다. 오케스트레이터와 스테이지 엔진 구조, 지원 모달리티를 확인했습니다.
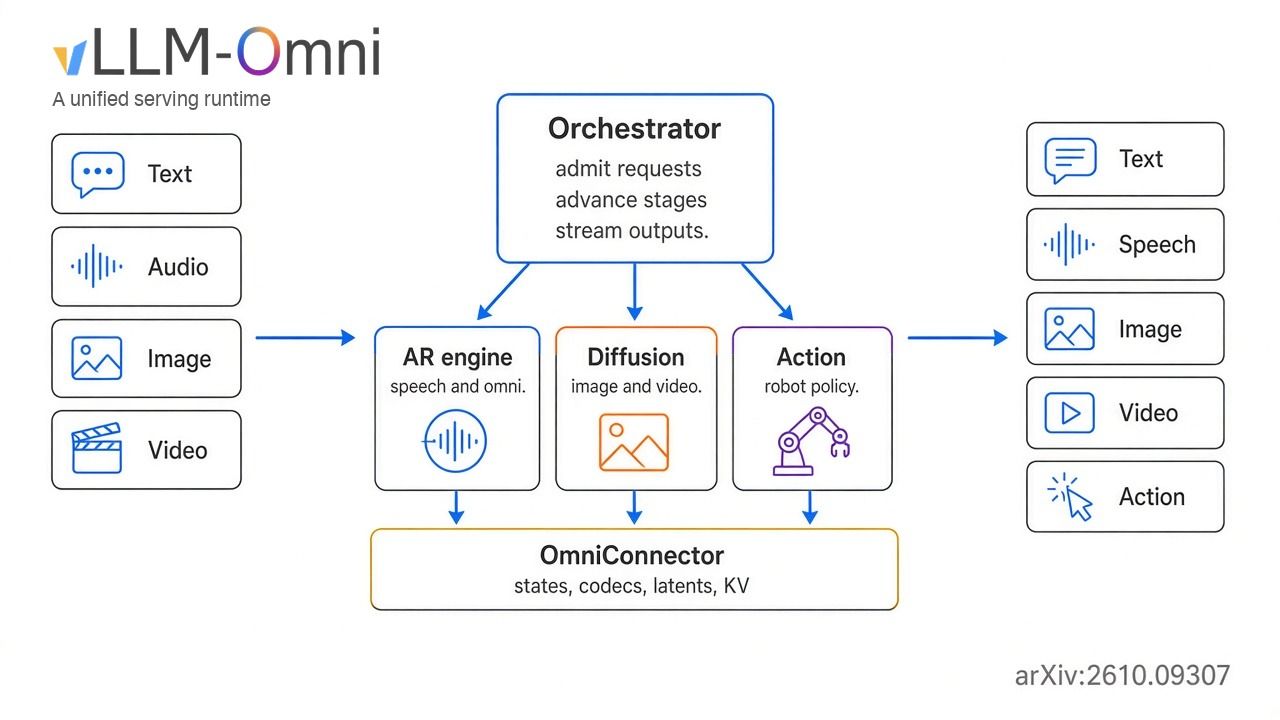
vLLM 공식 계정(@vllm_project)이 2026년 10월 8일 X 게시물에서 vLLM-Omni 기술 리포트 공개를 발표했습니다. vLLM-Omni는 텍스트 디코딩 단일 루프를 넘어선 옴니모달 생성을 위한 통합 서빙 런타임입니다.
이미지 출처: @vllm_project X 게시물
이 발표의 핵심은 서빙 구조의 분리입니다. 각 요청을 스테이지별로 진행시키는 오케스트레이터(Orchestrator)가 전체 흐름을 관장하고, 연산 자체는 용도별 특화 엔진(Specialized Engine)이 담당합니다. 음성 어시스턴트, 시각 생성, 월드 모델, 로봇 루프처럼 출력 양식에 따라 실행 패턴이 달라지는 작업들을 하나의 제어 평면에서 다루겠다는 것이 공식 게시물이 밝힌 방향입니다.
무엇이 확인됐나: 기술 리포트 발표와 공식 저장소 링크
확인된 사항은 기술 리포트 발표(논문 식별자 arXiv 2602.02204)와 공식 저장소 링크 공유(github.com/vllm-project/vllm-omni)입니다. 논문 초록은 텍스트·이미지·비디오·오디오를 함께 다루는 any-to-any 멀티모달 모델의 완전 분리형(fully disaggregated) 서빙을 표방합니다. 저장소 자체가 이번에 새로 개설됐다는 점은 번들 증거에서 확인되지 않으므로, 본문은 링크 공유 사실까지만 다룹니다.
아키텍처 문서에 명시된 지원 범위는 텍스트 외 이미지·오디오·비디오 출력과 Diffusion Transformer(DiT) 같은 비자기회귀(non-autoregressive) 구조입니다. 기존 LLM 서버와 디퓨전 스택이 각자 하나의 실행 패러다임에만 최적화되어 있어 배포 시 서로 다른 런타임을 이어 붙여야 했던 문제를 겨냥한 설계입니다.
이 소식은 멀티모달 추론 서버를 직접 운영하며 스테이지 간 상호작용을 수동으로 처리해야 했던 개발자에게 관련이 있습니다. 텍스트·음성·이미지·영상 출력을 한 파이프라인에서 서빙해야 하는 경우에 한해 참고하십시오.
오케스트레이터와 스테이지 엔진 구조
저장소 코드와 설계 문서가 확인해 주는 구조는 다음과 같습니다.
- 오케스트레이터: 백그라운드 스레드에서 동작하며 스테이지 엔진 클라이언트와 입출력 프로세서, 스테이지 간 전달 로직을 소유합니다. 요청이 멀티스테이지 파이프라인·반복 디퓨전·상태 유지 세션 중 어느 패턴이든 스테이지 단위로 전진시킵니다.
- 특화 스테이지 엔진: 각 스테이지의 실제 연산을 수행합니다. 모델별 경로, 배칭, 어텐션, 병렬화, 양자화 정책을 스테이지 지역(stage-local) 실행 정책으로 매핑합니다.
설계 문서의 표현을 빌리면, vLLM-Omni는 텍스트 중심 자기회귀 런타임이던 기존 vLLM을 비텍스트 출력과 비자기회귀 구성요소를 위한 스테이지 기반 실행으로 확장한 것입니다. vLLM 코어와의 호환성 유지가 설계 목표에 포함되어 있습니다.
지금 확인할 때 유의할 점
검증된 범위를 벗어난 내용은 포함하지 않았습니다. 이번 확정분에는 설치 명령어와 벤치마크 수치가 없어 본문에서 다루지 않습니다. 실제 도입 전에는 공식 저장소의 README와 설계 문서를 직접 확인하십시오.
날짜 구분도 명확히 합니다. X 게시일은 한국시간 기준 2026년 10월 8일이며, 논문 식별자 arXiv 2602.02204 자체의 공개 시점과는 별개입니다. 기술 리포트 공개 소식과 논문 자체의 초판일을 혼동하지 마십시오.
출처
- vLLM 공식 X (@vllm_project): vLLM-Omni 기술 리포트 공개 발표
- vLLM-Omni 공식 저장소: vllm-project/vllm-omni
- 아키텍처 개요: docs/design/architecture_overview.md
- 기술 리포트: arXiv 2602.02204 (PDF)