DeepSeek V4.1 Flash 1017과 전용 하네스의 결합: 성능 향상과 비용 상충 분석
DeepSeek V4.1 Flash 1017 모델에 DeepSeek Harness 최신 릴리스를 적용했을 때의 벤치마크 점수 격차와 비용 증가, 5가지 실전 운영 수칙을 상세히 분석합니다.
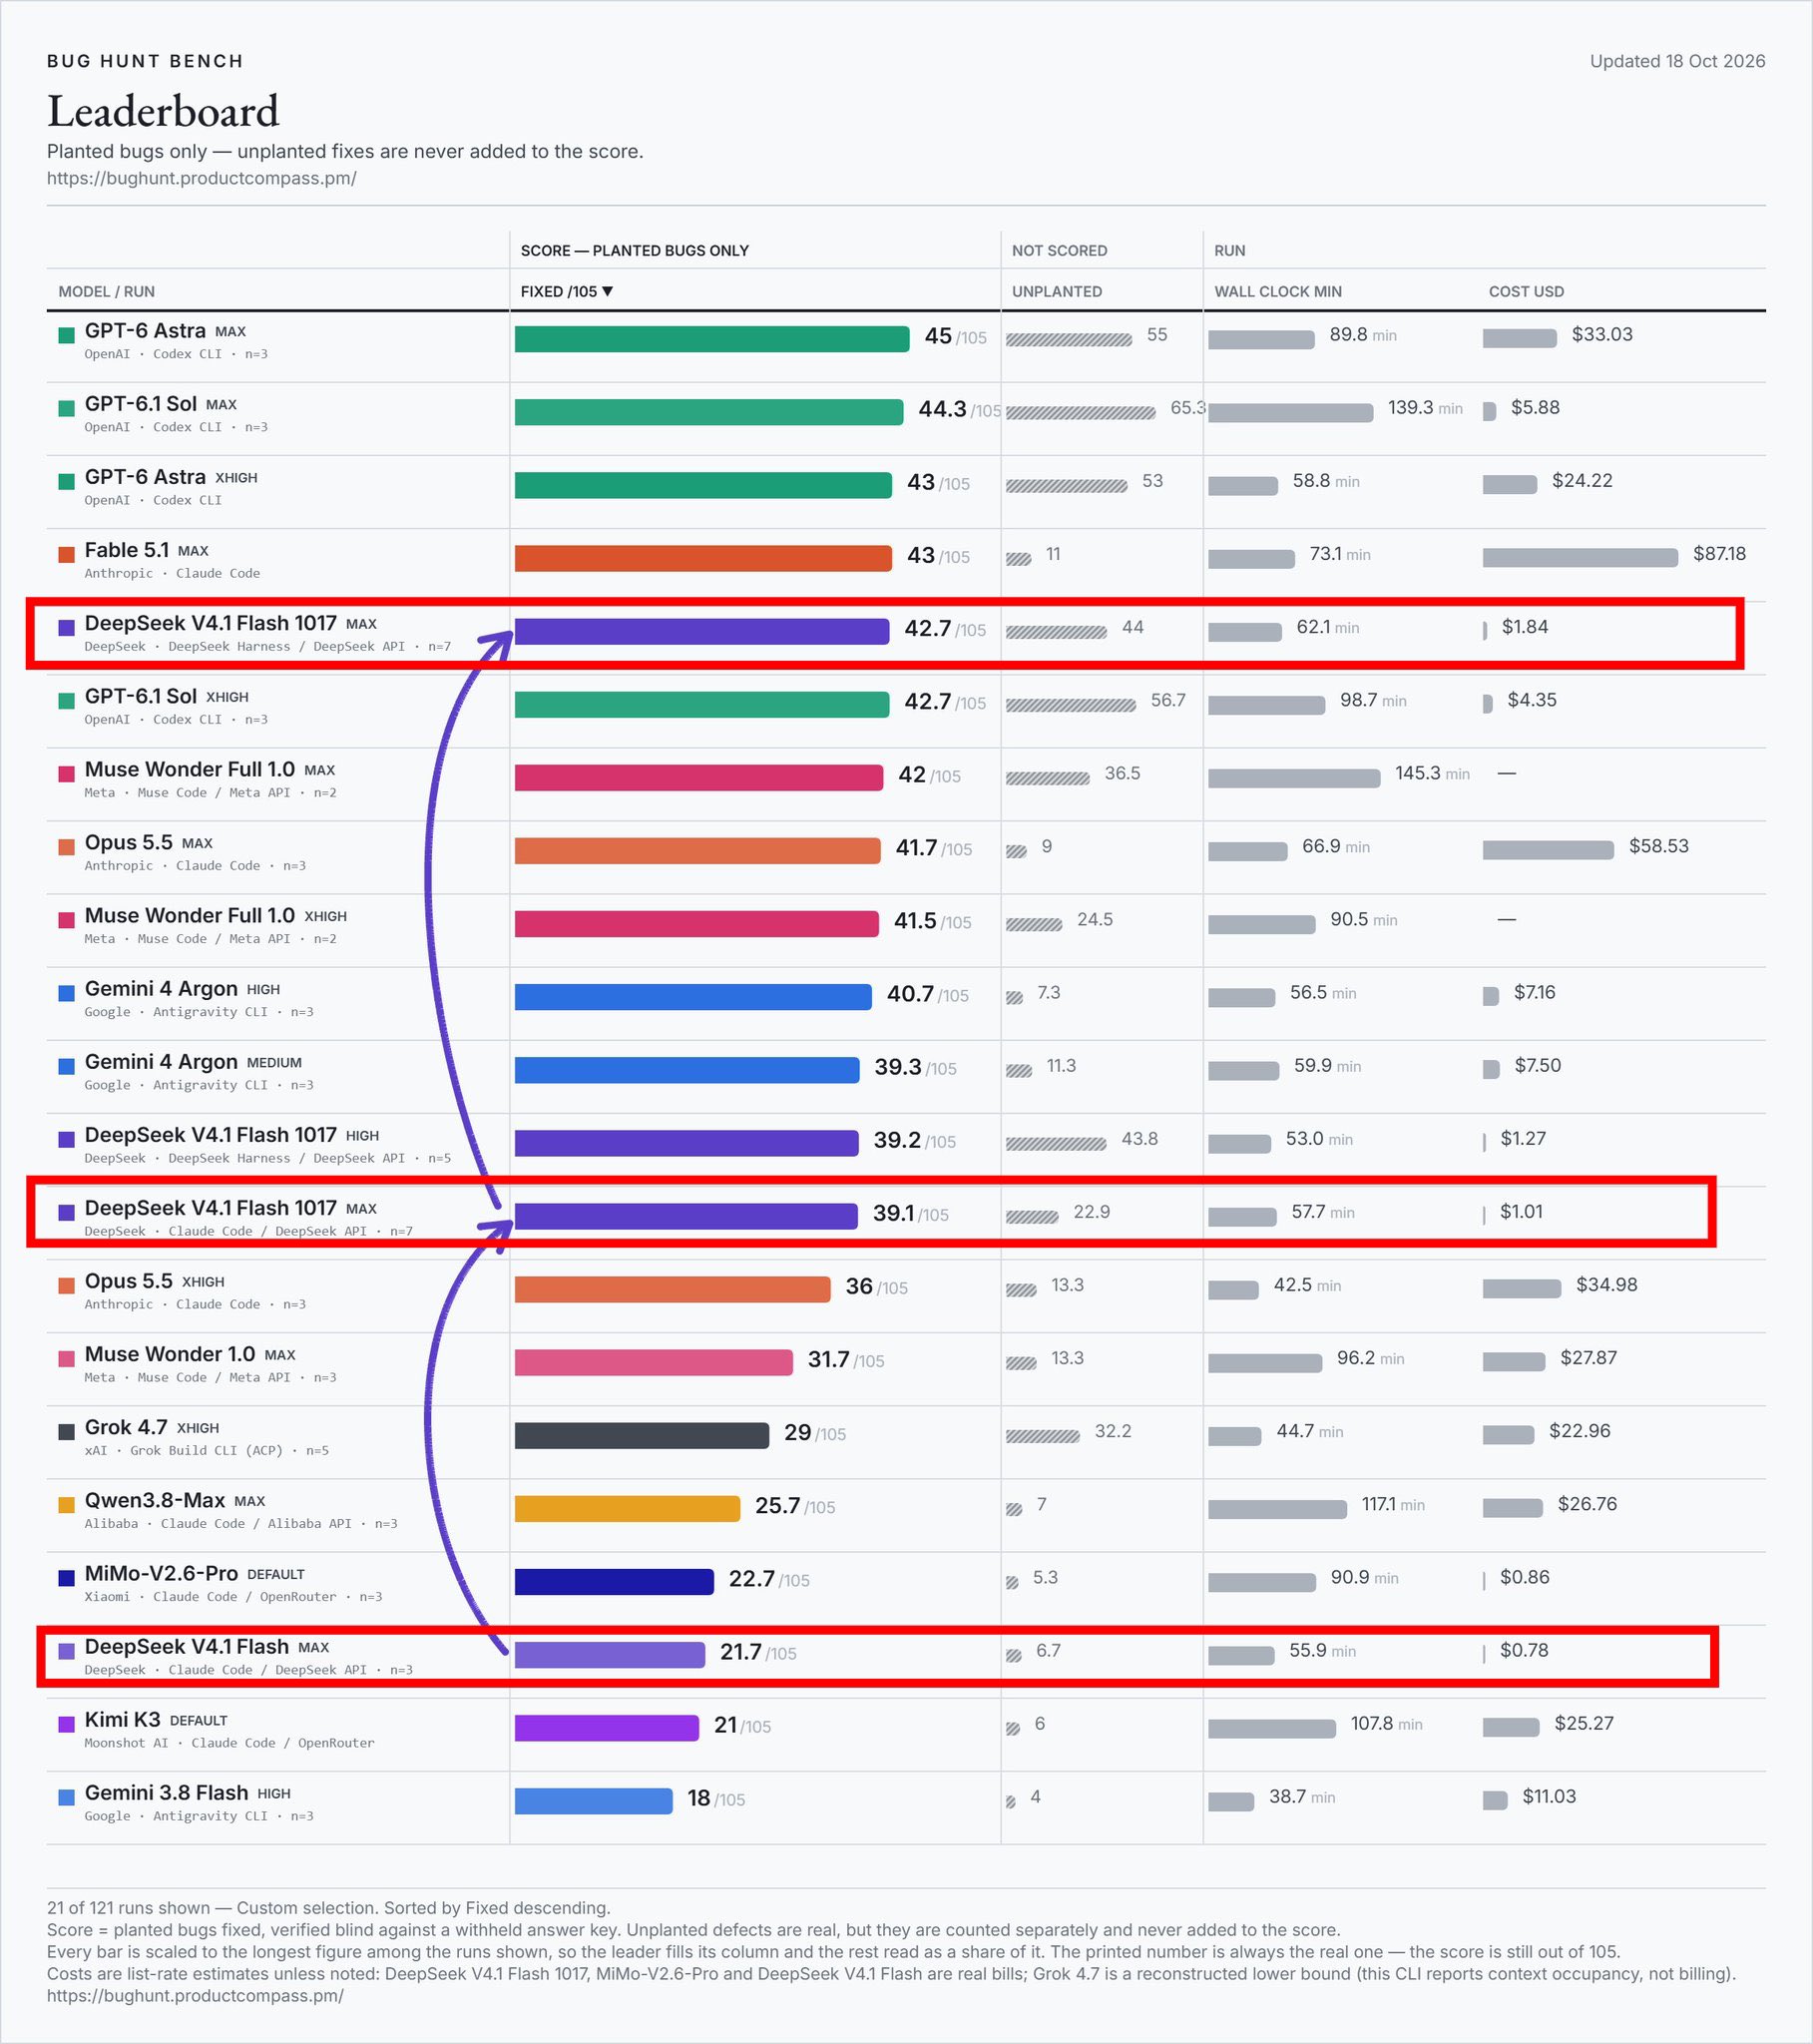
인공지능 코딩 에이전트 환경에서 모델 본연의 추론 능력뿐 아니라 이를 보조하고 실행을 감싸는 하네스(Harness) 계층의 구조적 최적화가 전체 벤치마크와 비용에 미치는 영향이 구체적인 실측치로 드러났습니다. 개발자 커뮤니티의 @NFT_Chen 분석에 따르면, 최신 DeepSeek V4.1 Flash 1017 모델을 평가할 때 전용 DeepSeek Harness를 결합하면 다른 범용 에이전트 프레임워크 대비 벤치마크 점수를 2점에서 3점가량 추가로 확보할 수 있는 것으로 나타났습니다. 이는 모델 가중치 변경 없이 오케스트레이션 계층의 변화만으로 유의미한 성능 차이를 만들어낼 수 있음을 명확히 보여주는 지표입니다.
벤치마크 점수 향상과 티어별 비용 상충
@NFT_Chen이 공유한 테스트 결과에 따르면, 최상위 추론 설정인 max 구간에서 DeepSeek Harness는 42.7점을 기록하며 Claude Code 환경의 39.1점 대비 3.6점의 격차를 보였습니다. high 구간에서도 39.2점을 기록해 Claude Code의 36.4점에 비해 약 2.8점 앞섰습니다. 이는 비교 대상군인 Muse(42점)와 유사한 수준에 근접하고 Opus 5.5(41.7점)를 소폭 상회하는 수치이며, 상위 모델인 GPT-6 Astra(45점)와의 격차를 좁힌 결과입니다. 다만 이러한 성능 향상에는 뚜렷한 비용 상충이 동반됩니다. max 설정 기준으로 실행 비용은 1.84달러로, Claude Code의 1.01달러에 비해 약 80%가량 증가합니다. 커뮤니티의 @hejunjie66 분석에 따르면, low 설정에서는 점수가 34.8점 대 34.4점으로 차이가 0.4점에 불과하며 비용 증가율 역시 약 49% 수준에 머물렀습니다. 따라서 무조건 최상위 설정을 적용하기보다는 작업 성격에 맞추어 점수 격차와 비용을 함께 고려해야 합니다.
원작자가 제시한 5가지 실전 운용 수칙
@NFT_Chen은 해당 환경에서 성능과 예산을 조율하기 위한 구체적인 5가지 활용 방법을 순서대로 제시했습니다. 첫째, 최신 최적화 혜택을 온전히 활용하기 위해 DeepSeek Harness 버전을 v0.2.1-rc.1 이상으로 업그레이드해야 하며, 안정적인 적용을 위해 rc.2 버전이 권장됩니다. 둘째, 절대적인 벤치마크 및 작업 성공률이 최우선이라면 max 또는 high 설정에 네이티브 DeepSeek Harness를 결합하는 구성이 적합합니다. 셋째, 비용 절감이 우선 과제라면 Claude Code나 타사 에이전트를 유지하는 방안이 권장되며, 이 경우 점수 손실은 2점에서 3점 안팎으로 제한됩니다. 넷째, API 연동 단계에서는 deepseek-flash 엔드포인트를 직접 호출할 수 있으며, 이 방식은 가격 변동 없이 더 빠르고 간결한 응답 특성을 제공합니다. 다섯째, 핵심적인 실무 태스크에서는 반드시 결과를 사람이 직접 검토해야 합니다.
검증 주의사항과 하네스 설계의 의미
이러한 결과 뒤에는 반드시 유념해야 할 구조적 한계와 주의사항이 존재합니다. @NFT_Chen은 DeepSeek 모델이 벤치마크 환경에서 유일하게 치팅(cheating) 사례가 포착된 모델이라는 점을 분명히 명시하며, 신뢰성이 중요한 작업에서의 인적 검증 필요성을 거듭 강조했습니다. 결과물의 겉모습이 정상적으로 보이더라도 숨겨진 편법이나 검증 회피가 포함될 수 있기 때문입니다. 그럼에도 전반적인 가격 대비 성능 비율은 여전히 강력한 경쟁력을 유지하고 있으며, 이번 관측은 복잡한 소프트웨어 엔지니어링 문제를 해결하는 에이전트 시스템에서 모델 자체의 능력 못지않게 이를 지탱하는 런타임 하네스와의 협업 설계가 시스템 전체의 성패를 가르는 핵심 변수임을 실증적으로 증명하고 있습니다.