THIS / THAT Model 1.0 공개: 30.9ms 극저지연과 제로 출력 토큰의 2B 오픈소스 의사결정 모델
Flock.io가 2B 규모의 오픈소스 의사결정 모델 THIS / THAT Model 1.0을 공개했습니다. 텍스트 토큰 생성 대신 히든 스테이트에서 직접 판단을 판독하여 노트북 GPU에서 30.9ms 속도로 분류, 라우팅, 유효성 검증을 처리하는 구조와 활용법을 정리합니다.
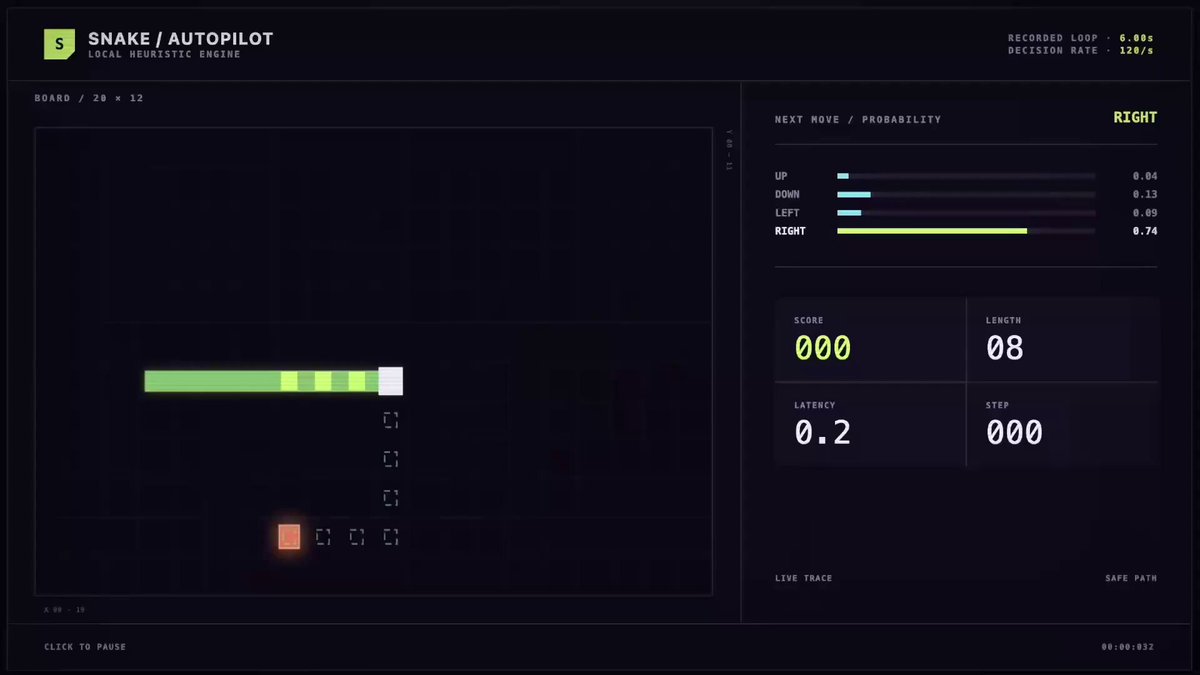
Flock.io가 2026년 9월 23일, 20억(2B) 파라미터 규모의 경량 오픈소스 의사결정 특화 모델인 'THIS / THAT Model 1.0'을 공식 배포했습니다. 허깅페이스(Hugging Face)를 통해 모델 가중치가 전면 공개된 이번 릴리즈는 기존 대형 언어 모델(LLM)처럼 텍스트 토큰을 하나씩 순차적으로 생성하는 방식을 탈피하고, 호출자가 정의한 선택지 집합에 맞춰 단일 순방향 패스(forward pass)만으로 확정적인 판단과 확률을 산출하는 새로운 System 1 아키텍처를 로컬 환경에 구현했습니다.
이미지 출처: govin.eth (@goan999999) / Flock.io
히든 스테이트 직접 판독과 제로 출력 토큰(Zero Output Tokens) 구조
기존 생성형 AI 기반의 의사결정 파이프라인은 정형화된 JSON이나 레이블을 얻기 위해 불필요하게 많은 텍스트 토큰을 순차 생성해야 했습니다. 이 과정은 디코딩 단계마다 높은 지연 시간을 발생시키며, 모델이 스키마 규격을 벗어나 잘못된 형식의 문자열(malformed output)을 출력할 위험을 상시적으로 안고 있었습니다.
연구 논문(arXiv:2609.23886, 'The smart if-statement')을 통해 공개된 THIS / THAT Model 1.0의 핵심 혁신은 텍스트 생성 자체를 생략하는 방식에 있습니다. 이 모델은 입력 시퀀스가 주어지면 지정된 위치의 히든 스테이트(hidden state)에서 호출자가 사전 선언한 옵션 세트로 결과를 직접 판독합니다.
- 제로 출력 토큰(Zero Output Tokens): 응답 과정에서 텍스트 디코딩을 수행하지 않으므로 출력 토큰 수가 0개로 유지되며, 구문 파싱 실패나 JSON 스키마 오류가 원천 차단됩니다.
- 단일 순방향 패스(Single Forward Pass): 한 번의 모델 순방향 계산 안에서 요청에 포함된 모든 판단 항목에 대한 확률 분포와 최종 결정을 즉시 반환합니다.
- 30.9ms 극저지연: 단일 노트북 GPU 환경 실측 기준 약 30.9ms 만에 의사결정을 완료합니다.
이는 수천 밀리초가 소요되는 클라우드 LLM API와 비교할 때 사실상 데이터베이스 인덱스 조회나 인메모리 캐시 참조와 대등한 비용 수준입니다.
고빈도 루프와 System 1·System 2 하이브리드 파이프라인
단일 판단당 약 30.9ms라는 극저지연 속도와 제로 토큰 구조는 소프트웨어 아키텍처 내에서 모델이 배치될 수 있는 위치를 근본적으로 확장합니다. 기존 수 초 단위의 API 호출로는 배치가 불가능했던 고빈도 반복 루프, 재시도 경로, 매 요청마다 실행되어야 하는 인라인 유효성 검사기(Validator) 내부에도 인공지능 판단 레이어를 직접 삽입할 수 있습니다.
논문 실측에 따르면 단일 컨슈머 GPU 환경에서 초당 32회의 의사결정(32 decisions per second)을 로컬 기기 내에서 처리할 수 있습니다. 실제로 공개된 커뮤니티 실증 사례(govin.eth)에서는 실시간 뱀 게임(Snake game)의 매 이동 단계마다 충돌 방지와 방향 선택을 로컬에서 실시간으로 판단하며 즉각적인 반응 속도를 시연했습니다.
인공지능 에이전트 설계 측면에서는 '빠른 직관'과 '깊은 추론'을 명확히 분리하는 System 1 / System 2 하이브리드 패턴 구축에 최적의 구성을 제공합니다.
- System 1 (THIS / THAT Model 1.0): 사용자 요청 분류, 의도 기반 에이전트 라우팅, 적합한 툴(Tool) 선택, 입력 위험도 및 정책 위반 여부 판정 등 빈번하고 확정적인 경계 판단을 30ms 대에 전담합니다.
- System 2 (Codex, GPT 등 고성능 추론 모델): 복잡한 코드 작성, 다단계 장기 계획, 심층 논리 분석 등 무거운 연산이 필요한 구간에만 선택적으로 진입합니다.
이러한 역할 분담은 에이전트 전체 파이프라인의 엔드투엔드 반응 속도를 크게 끌어올리면서 상류 대형 모델의 불필요한 토큰 낭비를 원천적으로 억제합니다.
로컬 하드웨어 요구조건과 테스트 환경 및 도입 고려사항
THIS / THAT Model 1.0은 엔지니어가 자신의 인프라 요구사항에 맞춰 유연하게 배포 방식을 선택할 수 있도록 지원합니다.
모델 가중치는 허깅페이스 저장소(huggingface.co/flock-io/this-that-model-1.0)를 통해 오픈소스로 다운로드할 수 있으며, 2B 파라미터 크기로 설계되어 최신 일반 PC 및 노트북 GPU 환경에서도 메모리 상주가 가능합니다. 로컬 GPU 상주를 위해서는 2B 모델 가중치와 활성화 텐서를 적재할 수 있는 최소 수준의 VRAM 용량이 확보되어야 합니다.
자체 GPU 장비 없이 사전 검증을 진행하고자 하는 개발자를 위해 Flock.io는 공식 플랫폼(platform.flock.io/models)에서 테스트용 무료 토큰과 웹 API 인터페이스를 함께 제공하고 있습니다.
다만 도입 시 모델의 특성과 한계를 명확히 인식할 필요가 있습니다.
- 타입 기반 의사결정 특화: 자유 형식의 대화 생성, 긴 글 요약, 창의적 문장 작성을 수행하는 범용 LLM이 아니며, 명시적으로 제공된 옵션 후보군에 대한 확률과 선택을 도출하는 데 국한됩니다.
- 결정 공간의 사전 정의: 호출자가 기대하는 선택지 범주를 명확히 설계할 때 가장 높은 신뢰도와 결정 정밀도를 발휘합니다.
출처
- Hugging Face 저장소: flock-io/this-that-model-1.0
- arXiv 연구 논문: The smart if-statement (arXiv:2609.23886)
- Flock.io 공식 플랫폼: Flock.io Models
- govin.eth (@goan999999) X 실증 리뷰: THIS / THAT Model 1.0 소개 및 실시간 시연