LLM 하네스 수동 코딩 대신 평가 세트 기반 자체 수정 루프 구축하기
에이전트 호출 구조를 사람이 직접 코딩하지 않고, 분리된 채점 세트와 실행 리포트를 기반으로 하네스 파일을 매 라운드 자동 수정·선별하는 워크플로를 정리했습니다.
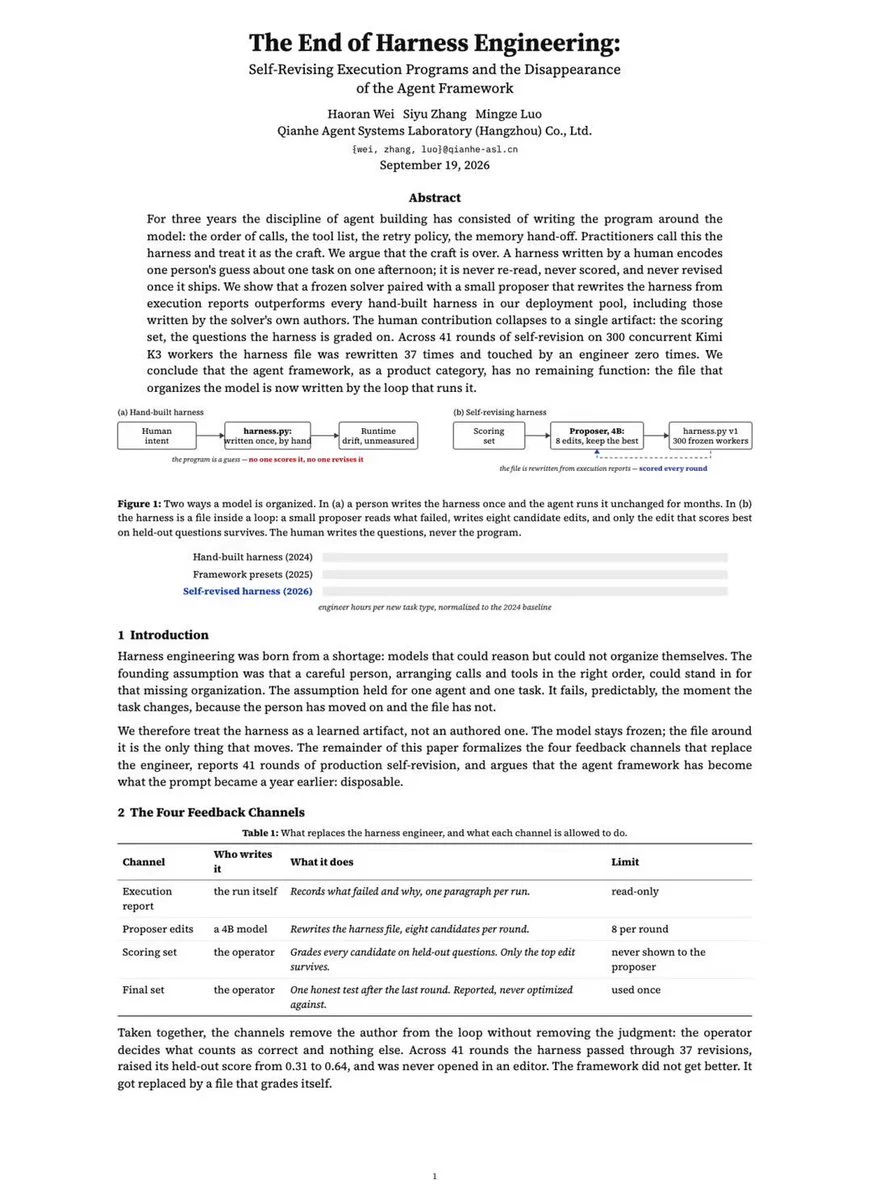
2026년 10월 19일 X 사용자 @virgilxbt는 중국 연구진이 발표한 논문 'The End of Harness Engineering'을 인용하며, 대형 언어 모델(LLM)을 제어하는 하네스(harness, 모델 주변에서 도구 호출·프롬프트 전달·실행 순서를 묶어 제어하는 오케스트레이션 코드나 설정 파일)를 사람이 직접 수정하지 않고 실행 루프 스스로 고쳐 쓰는 워크플로를 공유했습니다. 핵심 요약은 "파일을 직접 쓰지 말고 채점하라(grade the file, don't write it)"입니다.
이미지 출처: https://x.com/virgilxbt/status/2111890105028022608
기존 에이전트 개발에서는 개발자가 도구 배치를 손으로 짜고 커밋 메시지를 남기는 방식으로 파이프라인을 다듬었습니다. 원문 작성자는 이를 "커밋 메시지가 붙은 추측(a guess with a commit message)"이라고 짚으면서, 에이전트를 감싸는 외부 제어 구조를 일회용 코드로 두고 사람의 핵심 업무를 채점 기준 설계로 옮기는 방식을 소개합니다.
핵심 개념: 하네스는 버리고 채점 세트만 사람이 작성한다
이 워크플로에서 모델 본체인 솔버(solver, 실제 문제를 푸는 기본 LLM)는 전체 라운드 동안 버전을 바꾸지 않은 채 고정(frozen) 상태로 유지합니다. 대신 모델 바깥에서 작업 흐름을 조율하는 하네스 파일만 매 라운드 수정 대상이 됩니다.
사람이 직접 작성하고 관리하는 산출물은 단 하나, 채점 세트(scoring set, 정답 여부를 판별하기 위해 따로 떼어 둔 평가 문제 묶음)입니다. 원문에서 강조하는 운영 원칙은 세 가지입니다.
- 제안자(proposer) 비공개: 하네스 수정안을 만드는 모델에게 채점 세트를 절대 보여주지 않습니다.
- 직접 최적화 금지: 채점 세트 문항을 보고 맞춤형 규칙을 끼워 넣는 방식의 과적합을 막습니다.
- 후보 선별 전용: 매 라운드 생성된 하네스 후보들의 성적을 매기는 용도로만 사용합니다.
원문 작성자는 개발자의 역할이 "호출과 도구를 배치하는 일"에서 "무엇을 정답으로 볼지 정하고 점수를 읽는 일"로 바뀐다고 설명합니다.
반복 개선 루프의 4단계 작동 구조
원문이 제시한 자체 수정(self-revising) 하네스 루프는 단순한 자동 탐색 절차를 반복합니다.
- 실행 리포트 입력: 이전 라운드 하네스가 작업을 수행하며 남긴 실행 리포트(execution report, 실패 로그와 처리 과정 기록)를 입력으로 넣습니다.
- 수정안 8종 생성: 리포트를 바탕으로 하네스 파일 수정 후보(edits) 8개를 생성합니다.
- 보류 평가 세트 채점: 후보 8개를 사전에 격리해 둔 보류 질문 세트(held-out questions, 학습이나 수정 제안 과정에 노출하지 않은 별도 검증 문항)에서 실행하고 점수를 매깁니다.
- 우승 후보 채택 후 반복: 가장 높은 점수를 얻은 하네스 파일만 남기고 다음 라운드로 넘어갑니다.
원문 게시물에 따르면, 인용된 사례에서는 41라운드 동안 사람이 하네스 편집기를 한 번도 열지 않은 상태에서 보류 평가 점수가 0.31에서 0.64로 상승했습니다. 또한 @virgilxbt 본인이 직접 문서화해 운영한 루프에서는 Kimi K3 워커 300개를 투입해 41라운드 동안 37회의 자동 재작성을 거쳤고, 수동 편집은 0회였다고 밝혔습니다.
적용 시 확인해야 할 한계와 주의점
원문 스레드와 함께 공개된 검증 기록을 기준으로, 실무에 이 방식을 옮길 때 유의할 점도 분명합니다.
- 채점 기준의 품질 의존성: 스레드 참여자
@wwardenn은 평가 세트가 가장 철저히 보호해야 할 핵심이라고 짚었고,@open_is_free는 선택 압력이 사라진 것이 아니라 "채점자를 누가 채점하는가"라는 한 단계 위 문제로 이동했다고 지적했습니다. 채점 세트가 부실하거나 편향되면 하네스 역시 잘못된 방향으로 진화합니다. - 원논문 서지 정보 미확인: 원문 게시물은 논문 제목('The End of Harness Engineering')과 수치를 언급했지만, 게시물 본문과 스레드에는 arXiv 등 학술 저장소의 직접 링크가 포함되지 않았습니다. 인용된 0.31에서 0.64로의 점수 향상 수치 역시
@virgilxbt의 요약 게시물에 근거한 것이며 독립적인 원문 대조는 확인되지 않았습니다. - 실행 환경 조건: 작성자 본인의 41라운드 실험에는 Kimi K3 워커 300개 규모의 병렬 실행 환경이 사용되었으므로, 단일 로컬 환경에서 동일한 라운드 수와 후보 8종 평가를 돌릴 때는 토큰 비용과 실행 시간을 별도로 계산해야 합니다.
원문 출처
- @virgilxbt (X): The End of Harness Engineering 요약 및 자체 수정 하네스 루프 스레드