Scale AI, 직관적 시각 추론 벤치마크 'Humanity’s Sixth Sense' 공개… 인간 93.1% vs 최상위 모델 53.6%
Scale AI와 Elorian이 인간의 일상적 직관과 물리·사회적 시각 추론 능력을 평가하는 522개 과제 벤치마크 HSS를 발표했습니다. 인간 기준선 93.1% 대비 최고 AI 모델인 GPT-6-astra가 53.6%에 머물며 뚜렷한 격차를 확인했습니다.
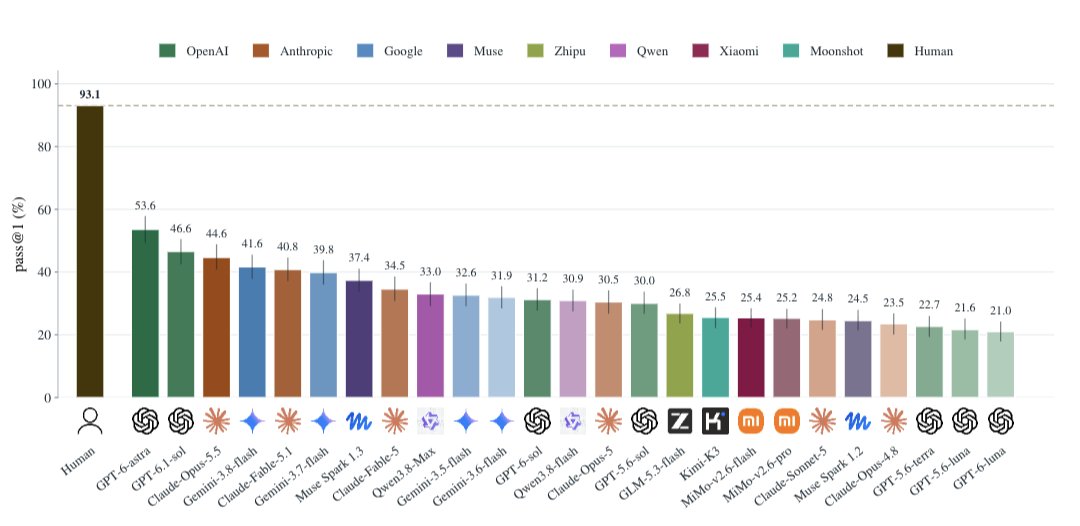
Scale AI Labs와 Elorian이 2026년 10월 7일(현지 시각), 인간이 일상 속에서 무의식적으로 활용하는 직관적 시각 추론(intuitive visual reasoning) 능력을 체계적으로 측정하는 신규 벤치마크 'Humanity’s Sixth Sense(HSS)'를 공식 발표했습니다. 이미지와 단편 비디오 클립으로 구성된 522개의 주관식 과제로 진행된 이번 평가에서, 인간 평가단 기준선은 93.1%를 기록한 반면 최고 성능을 기록한 AI 모델인 GPT-6-astra(최대 추론 강도)는 53.6%에 그치며 인간과 최첨단 멀티모달 AI 간의 뚜렷한 인지 격차가 실증되었습니다.
이미지 출처: Scale AI / Elorian
그동안 변호사 시험 통과나 고난도 텍스트 추론 벤치마크에서 인간을 넘어서는 성과를 증명해 온 프론티어 AI 모델들이, 일반적인 성인이라면 직관적으로 파악하는 물리적 공간 여유나 인물 간의 사회적 의도와 같은 일상적 시각 장면 해석에서는 여전히 취약하다는 점이 이번 평가를 통해 수치로 입증되었습니다.
522개 오픈엔드 과제와 4대 평가 영역: 일상의 '여섯 번째 감각' 측정
연구진은 인간이 시각 환경을 마주할 때 별도의 복잡한 연산 없이 즉각적으로 파악하는 공간 배치, 물체 간의 물리적 역학, 사회적 규범과 상황적 맥락을 일종의 '여섯 번째 감각(Sixth Sense)'으로 정의했습니다.
HSS 벤치마크는 288개의 정적 이미지와 234개의 비디오 클립(총 17.6시간 분량)을 기반으로 총 522개의 오픈엔드(open-ended, 주관식 서술형) 과제를 구성했습니다. 객관식 선택형 시험이 유발하는 무작위 찍기 효과나 언어적 통계 편향을 원천 차단하기 위해 모든 문항은 주관식으로 출제되었으며, 인간 채점관이 수립한 엄격한 루브릭 기준을 모두 충족해야만 정답으로 인정되는 부분 점수 배제 원칙이 적용되었습니다.
평가 프레임워크는 인간 시각 직관의 핵심을 관통하는 4대 영역으로 나뉩니다.
- 시간·인과 역학(Temporal & causal dynamics): 시간의 흐름에 따른 물체의 궤적 변화나 인과적 전후 관계를 예측합니다. (예: 어항 속 물고기들의 현재 유영 궤적을 보고 화면 하단 프레임 밖으로 벗어날 개체 수를 정확히 계산하는 과제)
- 물리·공간 논리(Physical & spatial logic): 시각적 단서를 기반으로 물리적 여유 공간이나 역학적 힘의 작용 상태를 파악합니다. (예: 책장 틈새를 보고 책 두 권이 추가로 들어갈 공간이 있는지 판단하거나, 팽팽하게 당겨진 사슬을 통해 쟁기가 견인되는 상태인지 추론하는 과제)
- 사회적 이해(Social understanding): 장면 속 인물들의 시선, 자세, 표정, 상대적 배치를 종합해 타인의 숨겨진 의도와 감정, 서열 및 사회적 행동 규범을 유추합니다.
- 맥락 추론(Contextual reasoning): 시각 장면에 직접 드러나지 않은 암묵적 배경 단서를 복원합니다. (예: 여행자가 공간 내에 들어선 입구가 어느 쪽 문이었는지 남겨진 흔적을 토대로 역추적하는 과제)
25개 모델 리더보드 결과: GPT-6-astra 53.6%, 전체 중앙값 30.9%
총 25개 주요 상용 및 오픈소스 멀티모달 모델을 대상으로 수행된 벤치마크 평가 결과, 인간 베이스라인(93.1%)과 인공지능 모델군 간의 간극은 예상보다 훨씬 광범위했습니다.
최고 성적을 거둔 모델은 GPT-6-astra로, 추론 강도를 최대로 설정한 상태에서 53.6%의 정답률을 기록했습니다. 그러나 평가에 참여한 25개 모델 전체의 중앙값(median)은 30.9%에 불과해, 대다수 모델이 3개 문항 중 1개도 채 맞히지 못하는 결과를 보였습니다. Claude Opus 5.5, Gemini 3.8 Flash 등 주요 프론티어 모델들 역시 일상 상식에 기반한 표본 문항에서 세 차례 시도 모두 오답을 기록하는 등 고전했습니다.
특히 모델들이 가장 극단적인 취약성을 드러낸 분야는 '사회적 이해(Social understanding)' 영역이었습니다. 평가된 25개 모델 중 21개 모델에서 사회적 이해 점수가 전체 영역 중 최저점을 기록했으며, 해당 영역의 모델 평균 정답률은 24.4%에 그쳤습니다. 이는 인간의 미묘한 시선 교환, 제스처에 담긴 위계 질서, 정황적 의도를 파악하는 능력이 방대한 텍스트 사전 학습만으로는 메워지기 어려운 고유한 영역임을 시사합니다.
오답 8,573건 정밀 분석: 실패의 94%는 '추론' 아닌 '시각 인식과 암묵적 함의 포착 실패'
Scale AI와 Elorian 연구팀은 모델들이 기록한 총 8,573건의 오답 데이터를 전수 분류하여 실패의 근본 원인을 분석했습니다. 그 결과 실패 원인의 94%가 논리적 추론 단계의 결함이 아니었다는 점이 밝혀졌습니다.
- 시각 인식 실패(Visual misperception, 53%): 이미지나 영상에 명시적으로 존재하는 공간적 증거 자체를 잘못 인식하고 왜곡 해석한 사례입니다.
- 미표시 함의 추론 실패(Implicit inference failure, 41%): 시각 정보에는 직접 표시되지 않았으나 상식적으로 유추 가능한 암묵적 물리·상황적 함의를 도출하지 못한 사례입니다.
즉, 최신 모델들은 기호 논리나 수학 문제를 푸는 언어적 추론 회로는 매우 고도화되었으나, 시각 입력에서 어떤 단서가 핵심 물리 법칙이나 상황적 함의를 지니는지 감지하고 이를 현실 세계 상식과 결합해 해석하는 감각적 그라운딩(sensory grounding) 능력이 여전히 부재한 상태입니다.
연구팀은 본 벤치마크의 전체 데이터셋을 허깅페이스(ScaleAI/HSS)에 오픈소스로 공개했으며, 모델별 공식 순위를 확인할 수 있는 공개 리더보드와 연구 논문 전문을 함께 배포했습니다. 다만 공급업체의 모델 체크포인트 갱신 주기와 추론 강도(effort) 설정값에 따라 리더보드 점수는 변동될 수 있습니다.
출처
- Scale AI Labs 공식 X: Humanity's Sixth Sense 발표 공지
- Scale Labs 공식 리서치: Humanity's Sixth Sense 연구 논문
- Scale Labs 리더보드: HSS 공식 리더보드
- Hugging Face 데이터셋: ScaleAI/HSS 데이터셋 저장소
- Elorian 공식 블로그: Humanity's Sixth Sense 기술 소개