Rapid-MLX v0.16.0 출시: Mac 로컬 AI TensorFold 가속 및 의사결정 모델 지원
Apple Silicon Mac을 위한 로컬 LLM 런타임 Rapid-MLX v0.16.0이 공개되었습니다. TensorFold 프로파일 도입으로 DeepSeek V4 Flash 처리량이 최대 2.1배 향상되었으며, System One 의사결정 모델과 OpenCode 2.x 연동이 추가
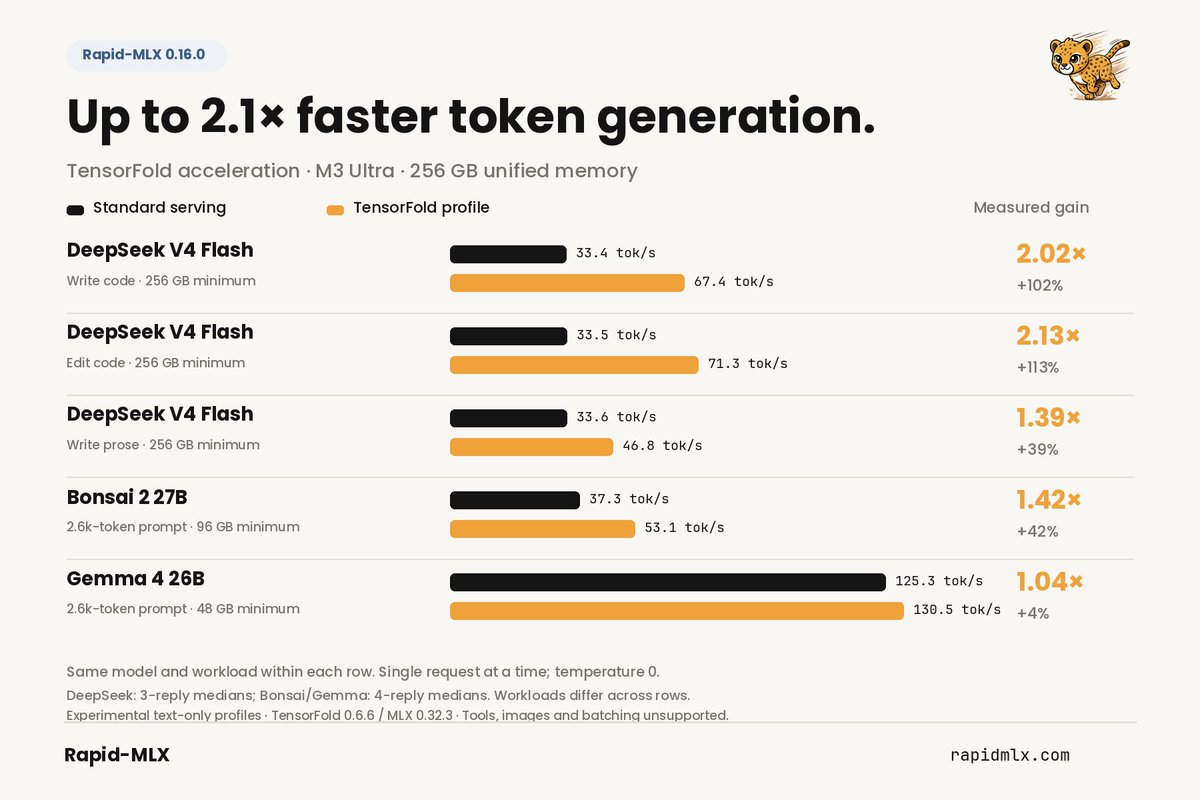
Apple Silicon Mac 환경에서 로컬 거대언어모델(LLM)을 구동하는 런타임 도구 Rapid-MLX의 v0.16.0 버전이 2026년 10월 10일 공식 출시되었습니다. 이번 업데이트는 MLX 아키텍처 기반의 하드웨어 가속 프로파일인 TensorFold를 도입하고, 실무 워크플로우를 위한 System One 의사결정 모델 및 OpenCode 2.x 코딩 에이전트 연동을 공식 지원합니다.
이미지 출처: @rapidmlx via X
이미지 출처: @rapidmlx via X
Rapid-MLX v0.16.0은 모델 추론 처리량을 대폭 끌어올리는 커널 최적화와 함께 로컬 환경에서 티켓 분류나 순위 평가를 즉시 수행할 수 있는 의사결정 파이프라인을 구축한 것이 핵심입니다.
TensorFold 프로파일 도입 및 모델별 처리량 최적화
Rapid-MLX v0.16.0의 가장 큰 기술적 진보는 'TensorFold 프로파일'의 정식 탑재입니다. Pierre의 mlx2 연구 성과를 결합해 Apple Silicon의 통일 메모리 및 GPU 코어 연산 효율을 극대화했습니다.
- DeepSeek V4 Flash: 추론 처리량(throughput)이 기존 대비 최대 2.1배(2.1×)까지 향상되었습니다.
- Bonsai 2 27B: 처리 속도가 +42% 가속되었습니다.
- Gemma 4 26B: +4%의 처리 속도 개선이 적용되었습니다.
모델 패밀리에 따라 가속 폭의 차이는 있으나, 클라우드 API 호출 없이 동일한 Mac 하드웨어에서 단위 시간당 처리 가능한 토큰 생성량을 크게 확장했습니다.
System One 의사결정 모델(Decider·Clef·OpenJev) 네이티브 지원
단순 텍스트 생성을 넘어 분류, 우선순위 채점, 답변 랭킹을 로컬에서 즉각 수행할 수 있는 'System One' 의사결정 모델들이 MLX 환경에 네이티브로 통합되었습니다.
사용자는 터미널에서 단일 명령어로 관련 모델을 즉시 구동할 수 있습니다.
rapid-mlx system-one decider-2b
지원되는 주요 의사결정 모델과 규격은 다음과 같습니다:
- Decider 2B: 초경량 고속 로컬 판단 모델.
- Clef Flash 9B 및 Clef 27B: 텍스트뿐만 아니라 멀티모달(Multimodal) 입력을 네이티브로 지원.
- OpenJev 27B: 대규모 추론 및 순위 평가 모델 (해당 가중치는 비상업적 용도 제한 라이선스 적용).
OpenCode 2.x 코딩 에이전트 지원 및 개발자 편의 기능 개선
개발자 도구 및 코딩 에이전트와의 결합도 대폭 강화되었습니다.
rapid-mlx agents opencode --setup --yes
- OpenCode 2.x 지원: 대화 턴 간 컨텍스트 재사용(Context reuse) 성능이 개선되어 긴 코딩 세션에서도 메모리 오버헤드를 줄였습니다.
- 안정적인 툴 호출(Tool Call) JSON 파싱: 로컬 에이전트 구동 시 발생하는 JSON 포맷 오류를 대폭 완화했습니다.
- 동시 스트리밍 및 이어받기 지원: 다중 요청 스트리밍 환경이 한층 매끄러워졌으며 대용량 모델 가중치 다운로드 시 중단된 지점부터 이어받을 수 있는 다운로드 안정화가 추가되었습니다.
출처
- Rapid-MLX 공식 X (@rapidmlx): Rapid-MLX v0.16.0 릴리스 안내
- GitHub 릴리스: raullenchai/Rapid-MLX v0.16.0