Qwen3.8-Flash-Next, 단일 32GB GPU 구동 프리뷰 공개… 80+ tok/s 달성
AgentionAI가 125B MoE 구조의 Qwen3.8-Flash-Next 모델을 단일 32GB GPU 환경에서 구동하는 특수 양자화 프리뷰를 공개했습니다. N-gram 오프로드와 로터 기반 양자화로 28.8 GiB 점유 및 80+ tok/s 생성 속도를 보고했습니다.
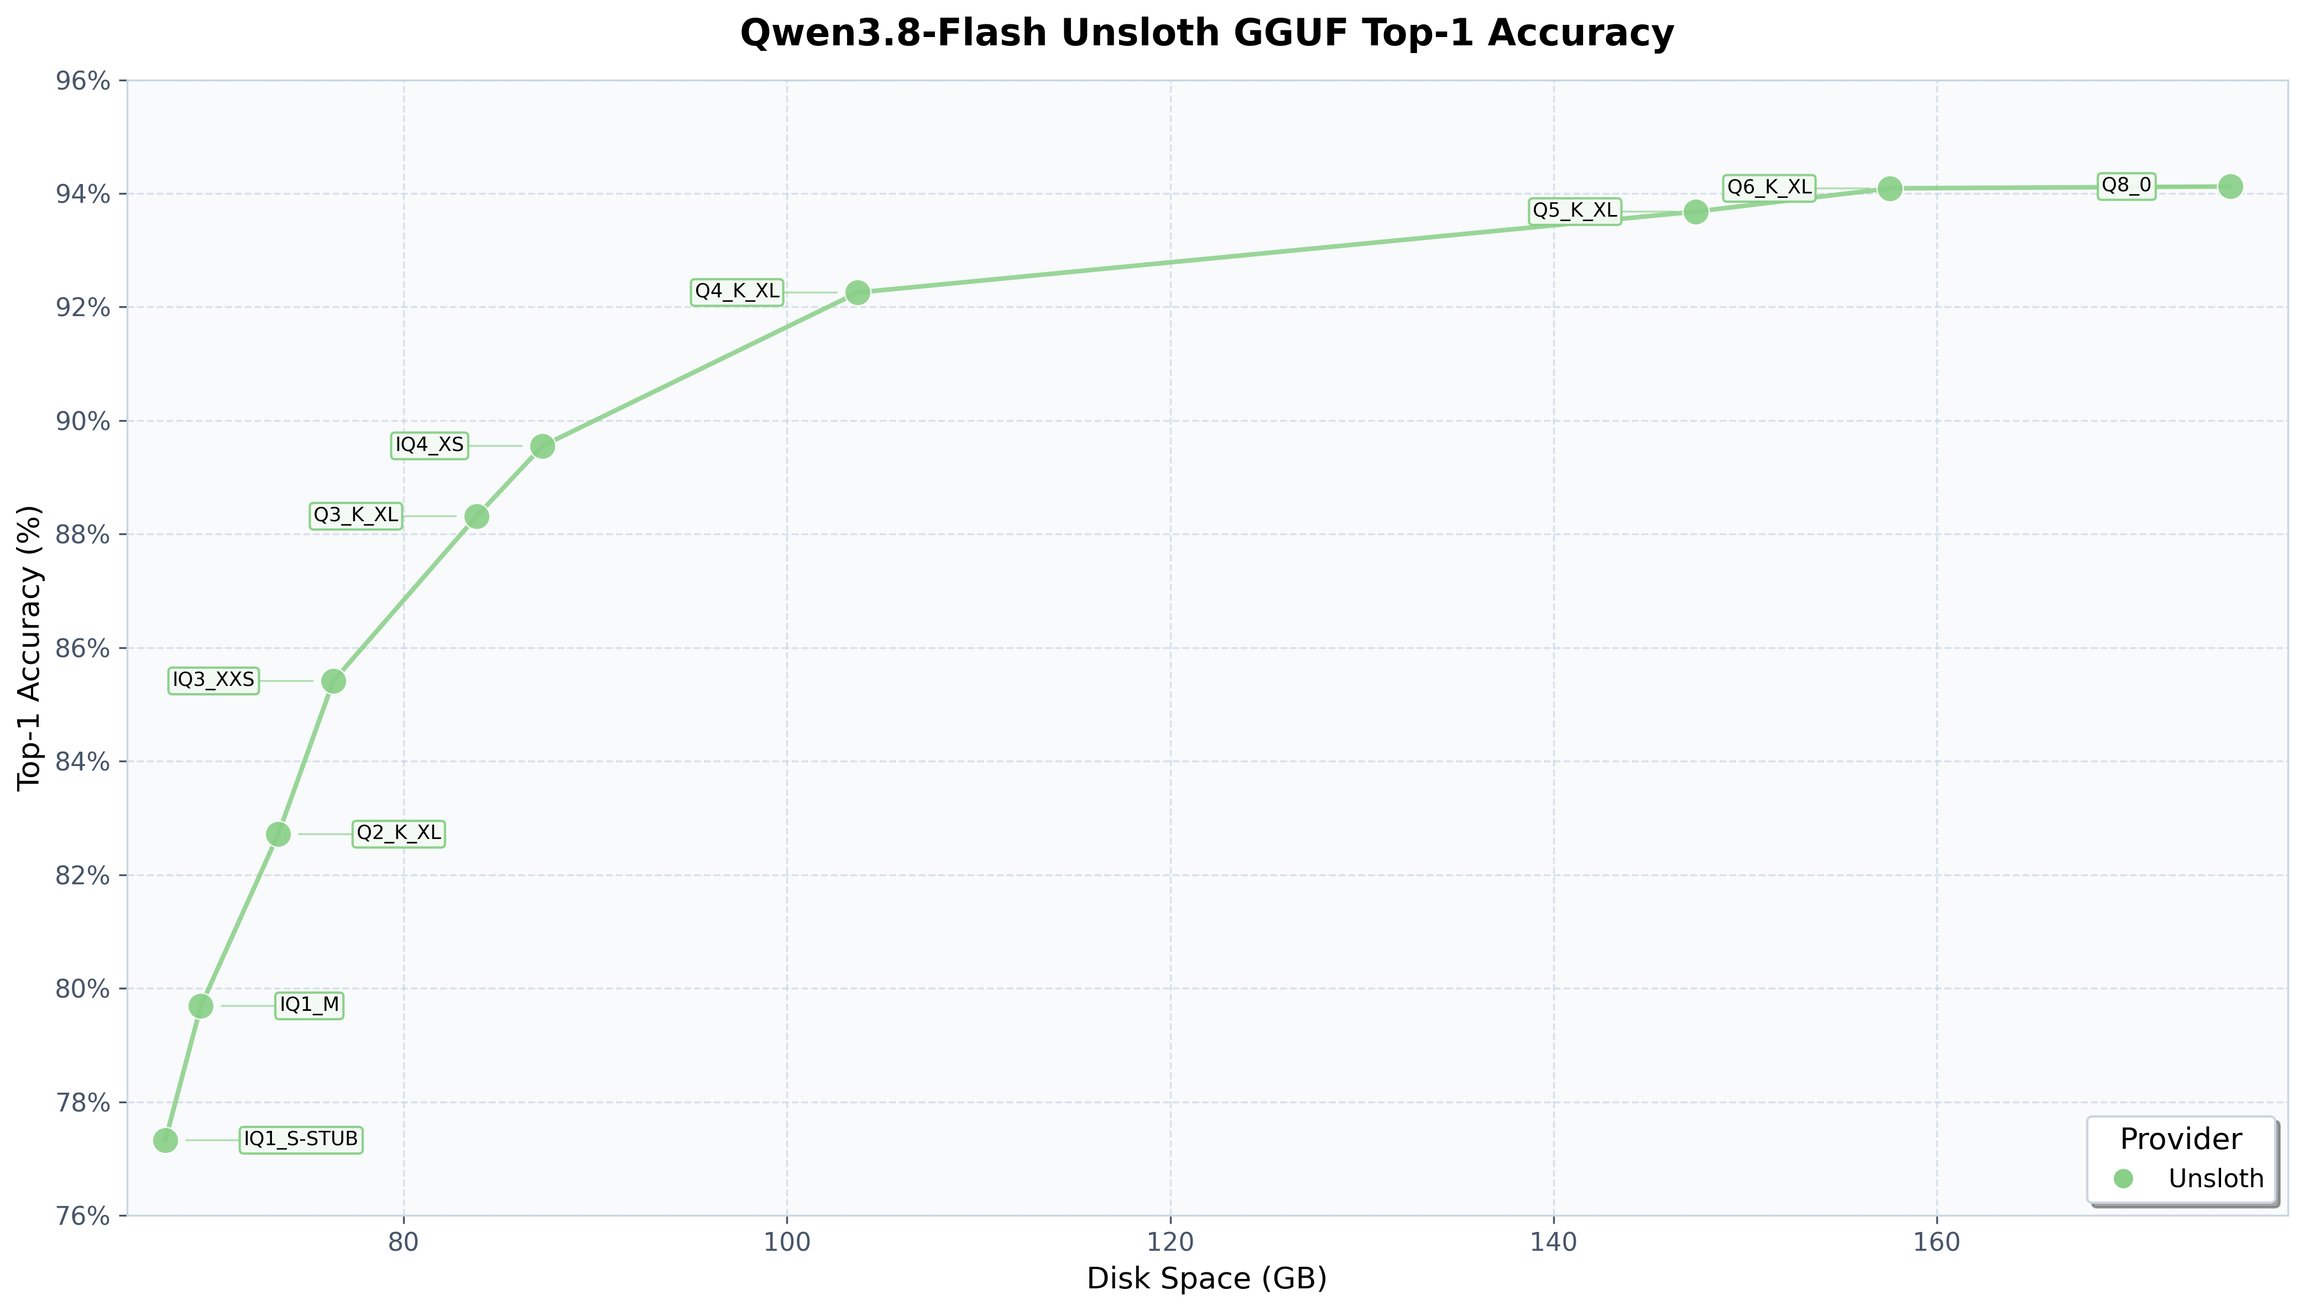
이미지 출처: https://unsloth.ai/docs/models/qwen3.8-next
2026년 10월 3일, AgentionAI가 Qwen의 차세대 MoE 아키텍처 모델인 'Qwen3.8-Flash-Next'를 단일 32GB GPU 환경에서 구동할 수 있도록 설계된 특수 양자화 프리뷰 빌드를 공개했습니다. 이번 프리뷰는 단일 Radeon R9700 PRO 32GB 셋업에서 80 tok/s 이상의 토큰 생성 속도를 기록한 것으로 보고되었습니다.
Qwen3.8-Flash-Next는 전체 125B 파라미터(토큰당 6B 활성화)와 51B 파라미터 규모의 N-gram 임베딩 테이블을 결합한 대규모 MoE 모델로, 일반적인 양자화 방식으로는 단일 소비자용·워크스테이션 GPU에 적재하기 어려운 한계가 있었습니다. AgentionAI는 가중치 분할 및 메모리 오프로드 아키텍처를 재설계하여 32GB VRAM 카드에서 실사용 가능한 추론 속도를 확보했습니다.
1. N-gram 호스트 오프로드와 로터 기반 MoE 양자화 메커니즘
AgentionAI의 32GB 최적화 프리뷰는 단일 정밀도로 전체 모델을 압축하는 대신, 컴포넌트별 특성에 맞춘 비대칭 양자화 및 메모리 배치 전략을 채택했습니다.
- N-gram 임베딩 테이블 호스트 오프로드: 모델 용량의 큰 비중을 차지하는 51B N-gram 테이블을 GPU VRAM 대신 호스트 시스템 메모리(RAM)로 오프로드하여 GPU VRAM 점유를 방지합니다.
- 라우팅 MoE 레이어의 로터(rotor) 기반 특수 양자화: 활성화되는 라우팅 전문가(routed experts) 레이어에 특수 저비트 로터 양자화를 적용해 모델의 핵심 추론 능력 손실을 최소화하면서 메모리 풋프린트를 대폭 압축했습니다.
- VRAM 점유율 최적화: 64K 컨텍스트 길이 기준으로 GPU VRAM 사용량을 약 28.8 GiB 수준으로 유지하여 32GB 그래픽 카드에서 OOM(Out of Memory) 없이 안정적으로 실행될 수 있도록 구성했습니다.
2. Qwen3.8-Flash-Next 아키텍처와 추론 처리량
Qwen3.8-Flash-Next는 알리바바 큐원 팀이 차세대 플래그십 Qwen4 시리즈에 적용될 설계를 미리 검증하기 위해 공개한 아키텍처 프리뷰 모델입니다.
- 하이브리드 어텐션과 희소 인덱싱: Gated DeltaNet(GDN)과 QSA(Qwen Sparse Attention)를 결합하여 초장문 컨텍스트에서도 연산 지연을 억제합니다.
- 효율적인 활성화 비율: 125B 전체 매개변수 중 토큰당 6B 매개변수만 선별 활성화하여 연산 부하를 최소화하면서 상위 플래그십급 추론 능력을 유지합니다.
- 단일 카드 80+ tok/s 보고: AgentionAI는 단일 32GB GPU 테스트베드에서 80+ tok/s의 생성 처리량을 달성했다고 보고했으며, 이는 기존 대규모 MoE 모델을 로컬 단일 카드에서 구동할 때 발생하던 속도 저하 문제를 실용적인 수준으로 개선한 수치입니다.
3. 프리뷰 단계의 하드웨어 편차 및 향후 로드맵
이번 배포는 커뮤니티 전반의 피드백과 다양한 하드웨어 호환성 검증을 위한 초기 프리뷰(Preview) 릴리즈입니다.
- 하드웨어 및 환경에 따른 성능 편차: AgentionAI는 보고된 80+ tok/s가 모든 32GB 환경에서 일률적으로 보장되는 고정 수치가 아니며, NVIDIA/AMD GPU 아키텍처, 드라이버 버전, 컨텍스트 길이, 추론 백엔드, 추측 디코딩(Speculative Decoding/MTP) 설정에 따라 실제 성능 차이가 발생할 수 있음을 명시했습니다.
- 단계별 메모리 티어 로드맵: 32GB 프리뷰 공개를 시작으로, 48GB 및 64GB VRAM 환경에 최적화된 추가 빌드와 추가적인 성능 최적화 패치가 순차적으로 공개될 예정입니다.
출처
- AgentionAI 모델 페이지: Qwen3.8-Flash-Next
- Oluwaphilemon1 X 포스트 (@Oluwaphilemon1): Qwen3.8-Flash-Next 32GB GPU 80+ tok/s Preview Announcement