MiniMax H3용 155MB 인물 LoRA: 참조 이미지 없는 텍스트 기반 로컬 비디오 생성
Playtime-AI가 공개한 155MB 크기의 MiniMax H3 전용 LoRA는 별도 참조 이미지 없이 텍스트 프롬프트만으로 일관된 인물 비디오를 로컬에서 생성합니다. 33B 모델과의 결합 구조와 실무 한계를 정리했습니다.
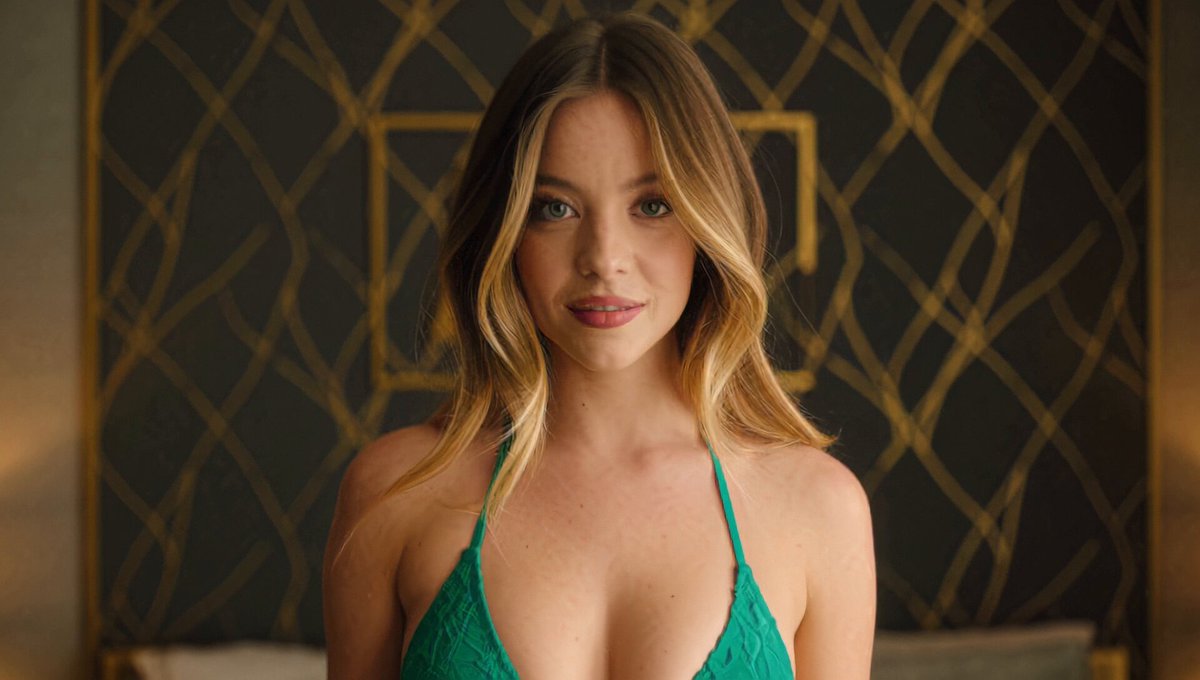
오픈소스 비디오 생성 AI 생태계에서 특정 인물의 외형과 얼굴 특징을 연속된 프레임 전반에 걸쳐 유지하는 '캐릭터 일관성(Character Consistency)'은 생성 모델의 가장 까다로운 기술적 난제 중 하나로 꼽혀왔습니다. 최근 오픈소스 커뮤니티 개발자 Playtime-AI가 330억(33B) 파라미터 기반의 오픈웨이트 비디오·오디오 생성 모델 MiniMax H3를 위한 155MB 크기의 초경량 인물 LoRA 가중치 'Minimax_H3-Sydney_Sweeney'를 허깅페이스(Hugging Face)에 공개해 주목받고 있습니다.
이미지 출처: X / @0x0SojalSec / Playtime-AI
기존의 이미지-투-비디오(I2V)나 다중 참조 기반 비디오 생성(Ref2V) 방식은 원하는 인물의 시작 프레임 이미지나 복수의 얼굴 앵글 사진을 직접 모델에 입력해야 했습니다. 반면 이번에 공개된 LoRA는 시작 이미지 입력 없이 텍스트 프롬프트에 인물 이름(Sydney Sweeney)을 지정하는 것만으로, 기본 모델에 내장된 비디오 렌더링 파이프라인과 결합해 고해상도 비디오 클립을 로컬에서 오프라인으로 렌더링합니다.
155MB 저순위 적응(LoRA)과 33B 멀티모달 파운데이션 모델의 결합 아키텍처
MiniMax H3는 텍스트, 이미지, 비디오, 오디오를 복합적인 컨텍스트로 입력받아 최대 15초 분량의 2K 해상도 비디오와 동기화된 네이티브 스테레오 사운드를 동시에 생성하는 330억 파라미터 규모의 오픈웨이트 멀티모달 모델입니다. 영상의 동작, 표정, 카메라 움직임, 물리 시뮬레이션뿐 아니라 배경 음향과 음성까지 단일 패스로 처리하는 구조를 갖추고 있습니다.
Playtime-AI가 공개한 가중치는 155MB 크기의 .safetensors 단일 파일로 구성된 LoRA(Low-Rank Adaptation) 체크포인트입니다.
- 기본 가중치 보존: INT8 양자화 적용 시 약 32GB에 달하는 MiniMax H3 본체 가중치를 재학습하거나 수정하지 않고, 모델의 특정 어텐션 레이어에 저순위 적응 행렬만을 동적으로 결합합니다.
- 제로 레퍼런스(Zero-reference) 인물 발현: 이미지 참조 없이 순수 텍스트 프롬프트에서 인물 식별 토큰을 직접 안면 기하 구조 벡터로 투영함으로써, 추가적인 이미지 입력 파이프라인 없이도 대상 인물의 얼굴 특징을 일관되게 재현합니다.
- 오프라인 네이티브 렌더링: 외부 클라우드 API 호출이나 원격 검열 게이트웨이 없이 로컬 환경에서 완전히 오프라인으로 추론할 수 있습니다.
로컬 실행 환경 요구사항과 워크플로우 구성
Hugging Face 저장소에서 배포되는 가중치 파일은 로컬 MiniMax H3 실행 파이프라인에 직접 로드할 수 있도록 설계되었습니다.
- 파이프라인 로딩 방식: 오픈소스 MiniMax H3 실행 환경(Python 스크립트 또는 호환 인터페이스)의
loras설정 항목에 다운로드한.safetensors파일 경로와 적용 강도(strength)를 지정하여 구동합니다. - VRAM 메모리 요구사항: LoRA 파일 자체는 155MB에 불과하지만, 이를 구동하는 기본 MiniMax H3 모델이 33B 규모의 고밀도 모델이므로 로컬 하드웨어에는 최소 24GB~32GB 이상의 VRAM이 요구됩니다. 일반적인 작업 환경에서는 INT8 양자화 적용이 사실상 필수적입니다.
- 프롬프트 제어: 복잡한 제어 태그 없이도 프롬프트 내에 인물 식별자를 배치하고 원하는 배경, 조명, 카메라 무빙, 액션을 기술하여 텍스트 기반 씬 디렉팅을 수행합니다.
실무 제작 관점의 기술적 한계와 윤리적 고려사항
이번 도구는 155MB라는 극도로 작은 용량으로 대규모 비디오 모델에서 특정 인물의 외형 일관성을 확보할 수 있음을 입증했으나, 실무 프로덕션 도입 시에는 몇 가지 명확한 한계를 고려해야 합니다.
- 극단적 앵글 및 조명 변화 시 왜곡: 참조 이미지를 기반으로 픽셀 레벨을 고정하는 방식이 아니기 때문에, 급격한 카메라 앵글 회전이나 과도한 역광 등 복잡한 조명 조건에서는 안면 특징이 순간적으로 왜곡되거나 원형에서 벗어나는 드리프트(Drift) 현상이 발생할 수 있습니다.
- 기본 모델 메모리 장벽: LoRA의 경량성에도 불구하고 기본 33B 파운데이션 모델의 VRAM 풋프린트를 회피할 수는 없으므로, 하이엔드 단일 GPU나 다중 GPU 워크스테이션이 갖춰지지 않은 환경에서는 구동 진입 장벽이 여전히 높습니다.
- 초상권 및 딥페이크 악용 위험: 실존하는 공인의 얼굴 외형에 특화된 체크포인트인 만큼, 허위 정보 생성, 동의 없는 합성 영상 제작 등 딥페이크 악용 위험에 직면할 수 있어 라이선스 규정과 법적·윤리적 책임에 기반한 주의 깊은 활용이 필수적입니다.
출처
- Hugging Face: Playtime-AI/Minimax_H3-Sydney_Sweeney 모델 저장소
- X: @0x0SojalSec 로컬 비디오 생성 시연 포스트
- GitHub: MiniMax-AI/MiniMax-H3 공식 저장소